
容器与云原生 / 系统课时
区分 DNS 与策略连接故障
区分 DNS 与策略连接故障
Pod 访问 Service 失败时,curl service-name 一次失败无法直接判断是 DNS、NetworkPolicy、Service 转发还是应用本身。应拆开名称解析、目标地址、端口连接和应用响应,定位故障具体停在哪一层。
学习目标
- 分离 DNS 解析失败与目标网络连接失败
- 判断故障位于 NetworkPolicy、Service 转发还是应用监听层
- 用最小命令形成可重复的分层验证路径
先验证 DNS 是否能得到目标地址
第一步只测试名称解析,不发起业务连接。若 Pod 无法解析 Service 名称,应优先检查集群 DNS、DNS Service,以及出站 NetworkPolicy 是否允许访问 DNS,而不是直接修改业务端口规则。
kubectl exec -n client client-0 -- nslookup api.backend.svc.cluster.local预期输出
Server:    <IP>
Address:   <IP>:53

Name:      api.backend.svc.cluster.local
Address:   <IP>
实际 DNS 与 Service IP 会不同。如果出现超时或无法联系 DNS Server,说明故障发生在名称解析链路;如果返回 NXDOMAIN,则应核对名称、命名空间和 Service 是否存在。这与 TCP 端口是否被策略允许是两类问题。
使用默认拒绝出站策略时,常见遗漏是只允许业务目标,却没有允许 DNS。下面是允许客户端访问带有 k8s-app=kube-dns 标签的 DNS Pod 的片段示例;实际集群标签和 DNS 所在命名空间应先通过查询确认。
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-dns
  namespace: client
spec:
  podSelector:
    matchLabels:
      app: client
  policyTypes:
    - Egress
  egress:
    - to:
        - namespaceSelector:
            matchLabels:
              kubernetes.io/metadata.name: kube-system
          podSelector:
            matchLabels:
              k8s-app: kube-dns
      ports:
        - protocol: UDP
          port: 53
        - protocol: TCP
          port: 53
生效后,匹配 app=client 的 Pod 可向符合条件的 DNS Pod 发送 UDP/TCP 53 流量。验证时仍应重新执行 nslookup,而不是只确认 NetworkPolicy 对象已经创建。
绕过 DNS 直接测试目标 IP 与端口
如果名称可以解析,下一步用解析得到的目标地址直接测试 TCP 端口,把 DNS 从故障链路中排除。
kubectl exec -n client client-0 -- sh -c 'nc -vz -w 3 <IP> 8080'预期输出
<IP> (<IP>:8080) open若名称解析成功,但直接连接目标 IP 超时,说明 TCP 握手没有在超时时间内完成,应重点检查客户端出站策略、目标 Pod 入站策略、CNI 数据路径和节点网络。若立即返回 Connection refused,通常表示报文已经到达目标地址,但目标端口没有进程监听或监听端口配置错误,此时应转向应用监听状态和端口配置,而不是继续扩大 NetworkPolicy 允许范围。
再区分 Service 转发与 Pod 直连
Service 能解析并不代表后端一定存在可用 Endpoint。先查询 Service 与 EndpointSlice,再分别测试 Service IP 和后端 Pod IP,可以判断问题是否落在 Service 选择器、转发路径或后端监听层。
kubectl get service -n backend api -o wide
kubectl get endpointslice -n backend -l kubernetes.io/service-name=api
预期输出
NAME   TYPE        CLUSTER-IP   EXTERNAL-IP   PORT(S)    AGE      SELECTOR
api    ClusterIP   <IP>         <none>        8080/TCP   <TIME>   app=api

NAME       ADDRESSTYPE   PORTS   ENDPOINTS   AGE
api-<ID>   IPv4          8080    <IP>        <TIME>
如果 EndpointSlice 没有后端地址,应检查 Service selector、Pod 标签和 Ready 状态。若直接访问 Pod IP 成功、访问 Service IP 失败,则除 NetworkPolicy 外还需要检查 Service 转发路径;若二者都失败,则继续检查策略、网络数据路径和应用监听。
用分层路径定位停止点
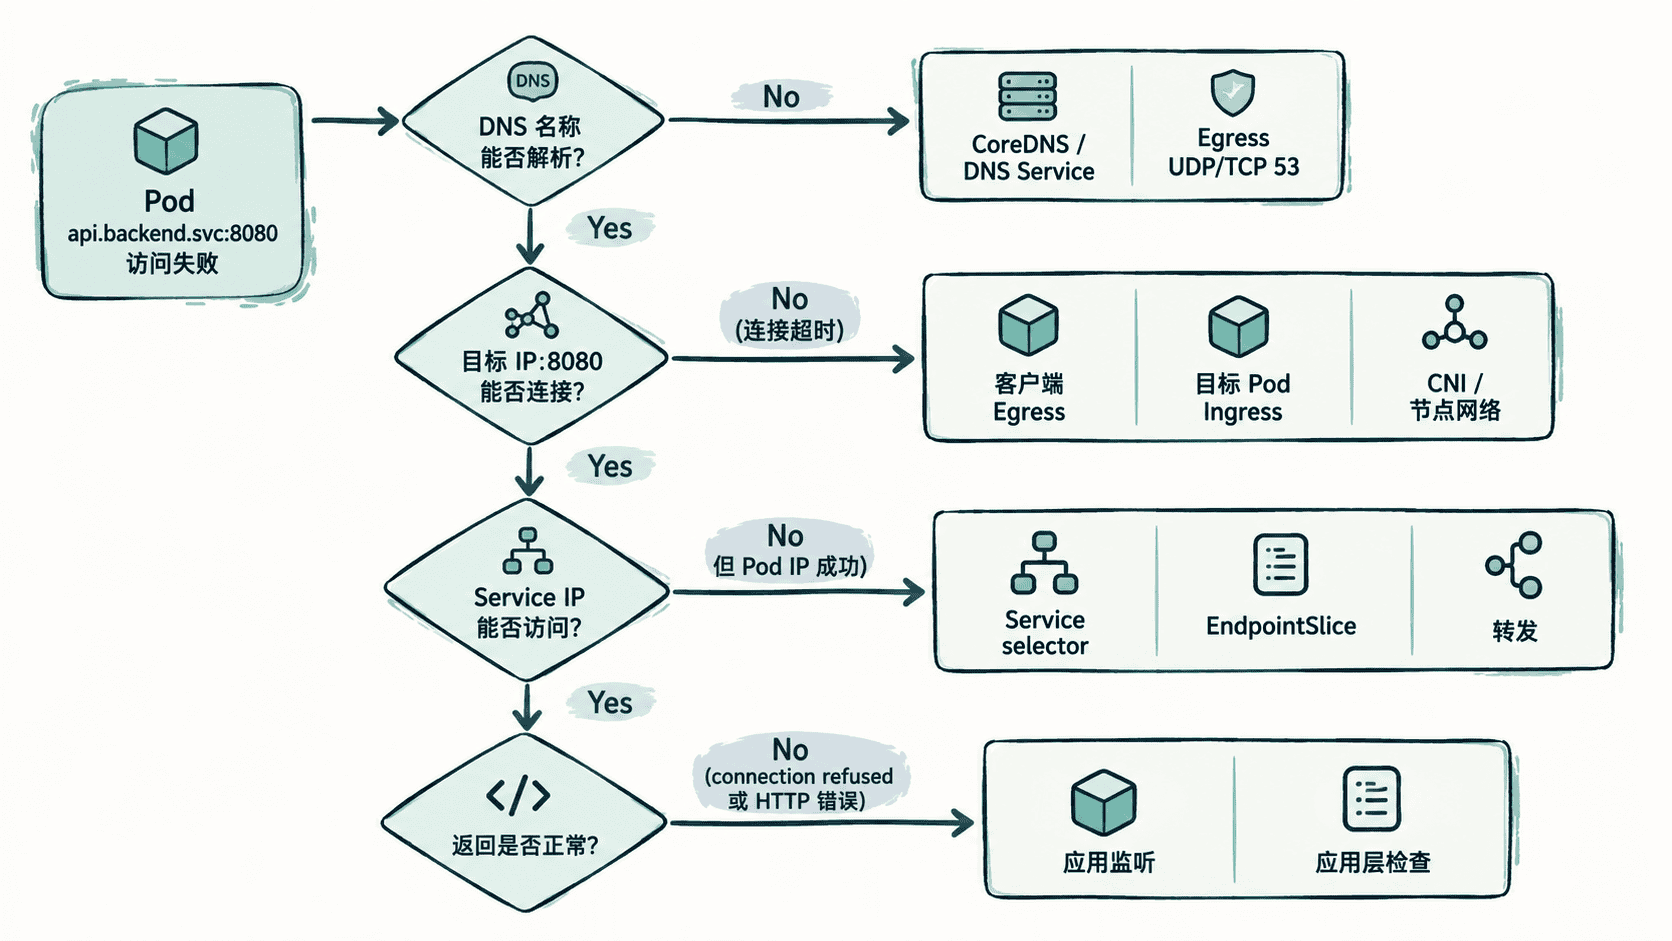
实际排障时可以按“名称解析 → IP → 端口 → Service → 应用”顺序执行。每一步只验证一个故障层级:先确认 DNS,再验证网络可达性和端口,之后检查 Service 后端与转发,最后才验证完整的应用请求。
kubectl exec -n client client-0 -- sh -c 'wget -S -O- --timeout=3 http://api.backend.svc:8080/health 2>&1 | head'预期输出
HTTP/1.1 200 OK如果最终请求恢复,而前面的分层测试也能稳定通过,才可以确认故障真正闭环。DNS 超时、TCP 超时、连接被拒绝和 HTTP 错误分别指向不同层级,排障时应保持这种区分,避免一看到“连不上”就把所有问题归因于 NetworkPolicy。