
容器与云原生 / 系统课时
识别平台组件通信依赖
识别平台组件通信依赖
默认拒绝策略最容易误伤的往往不是业务调用,而是 DNS、指标采集、日志传输、健康检查等平台能力。上线隔离前,需要把这些通信按来源、目标、端口和方向盘点清楚,再把确认必要的路径转换成最小化允许规则。
学习目标
- 识别常见平台组件对业务 Pod 和基础设施服务的通信依赖
- 区分需要由 ingress、egress 或通信两侧分别放行的链路
- 用实际观测验证默认拒绝策略没有切断平台能力
从通信方向而不是组件名称开始盘点
平台依赖不要只列一串“Prometheus、DNS、日志系统”的名字,而要写成可以转化为策略的四项信息:谁发起、访问谁、使用什么端口、属于哪个方向。同一个组件可能同时存在多条不同的数据路径。
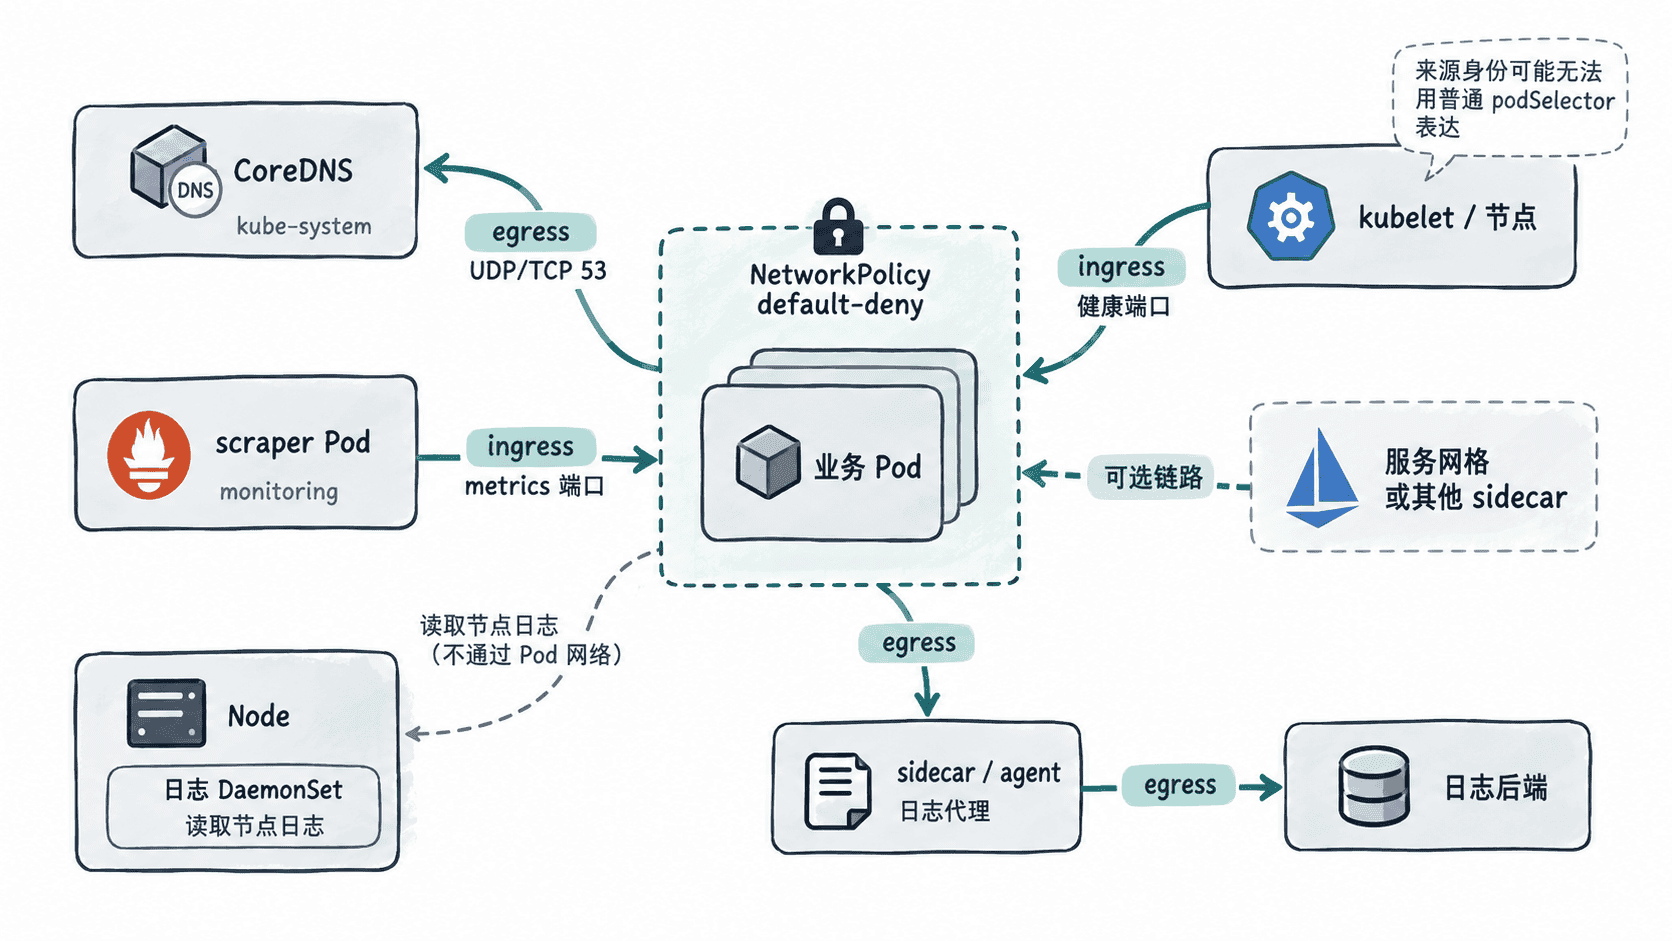
典型依赖可以先按下面的思路分类:
| 能力 | 常见发起方 | 常见目标 | 策略关注点 |
|---|---|---|---|
| DNS | 业务 Pod | CoreDNS | 业务 Pod 的 egress,通常为 TCP/UDP 53 |
| 指标采集 | Prometheus 或采集器 Pod | 业务 Pod metrics 端口 | 业务 Pod ingress |
| 日志传输 | Agent、sidecar 或业务 Pod | 日志后端 | 发起方 egress;后端若受 ingress 隔离还需放行对应来源 |
| 健康探针 | kubelet 或节点侧组件 | Pod 健康端口 | 来源通常不能直接用普通 Pod selector 表达 |
| 服务发现或配置 | 业务 Pod | API、注册中心或配置服务 | 业务 Pod egress;目标侧策略按实际情况处理 |
这张表只能作为盘点起点。实际端口、命名空间、标签和访问方式必须从当前集群验证,不能直接照搬模板。NetworkPolicy 是按被策略选中的 Pod 分别约束 ingress 与 egress,因此一条链路是否需要两侧规则,取决于源 Pod 和目标 Pod 各自是否已经被相应方向的策略隔离。
先验证 DNS 这条基础依赖
实施默认拒绝 egress 后,DNS 是最常见的首个故障点。可以在目标业务命名空间启动一个临时测试 Pod,直接解析 Kubernetes Service 名称:
kubectl -n <NAMESPACE> run dns-check --rm -i --restart=Never --image=busybox:1.36 -- nslookup kubernetes.default.svc.cluster.local预期输出:
Server:    <IP>
Address:   <IP>:53

Name:      kubernetes.default.svc.cluster.local
Address:   <IP>
实际地址和输出格式可能因集群 DNS 实现而不同。如果查询超时,而测试 Pod 本身运行正常,应优先检查 egress NetworkPolicy 是否允许访问集群 DNS。不要只根据 kube-dns Service 的 ClusterIP 猜测策略写法,应同时确认 DNS 后端所在命名空间、Pod 标签,以及当前 CNI 在 Service 转发前后实施策略的位置。
找出指标采集的真实来源
指标采集方向通常与业务请求相反:不是业务 Pod 主动访问 Prometheus,而是采集器访问业务 Pod 的 metrics 端口。因此,当 app=myapp 的 Pod 被 ingress 默认拒绝后,需要明确允许实际监控来源。
先查看采集器和目标 Pod 的标签,这些标签才是后续 selector 的依据:
kubectl get pods -n monitoring --show-labels
kubectl get pods -n <NAMESPACE> -l app=myapp --show-labels
预期结果:
NAME                 READY   STATUS    RESTARTS   AGE      LABELS
prometheus-<ID>      1/1     Running   0          <TIME>   app=prometheus,<LABELS>

NAME                 READY   STATUS    RESTARTS   AGE      LABELS
myapp-<ID>           1/1     Running   0          <TIME>   app=myapp,<LABELS>
实际 Pod 名称、标签和值会不同。如果准备使用 namespaceSelector 与 podSelector 联合限制来源,应确认监控命名空间拥有稳定标签,并确认采集 Pod 也有可长期依赖的标签。不要把临时 Pod 名当作策略身份。
不要把所有平台能力都当成 Pod 到 Pod 流量
日志代理是一个典型反例。DaemonSet 日志 Agent 如果直接读取节点上的容器日志文件,它与业务 Pod 之间未必存在需要 NetworkPolicy 放行的网络连接;真正需要放行的可能是 Agent 到日志后端的 egress。相反,sidecar 主动把日志发送到远端时,就会形成另一条网络路径。
健康探针也需要单独判断。HTTP、TCP 或 gRPC 探针通常由 kubelet 发起,其网络来源不是普通业务 Pod,因此不能看到“探针访问 Pod 端口”就机械地写一个来源 podSelector。应结合所用 CNI 的 NetworkPolicy 实现和实际抓取到的流量来源,确认节点到 Pod 的探针流量是否受策略影响,以及是否需要额外处理。
同理,服务网格、准入辅助组件、外部密钥服务、配置中心和云厂商节点组件都应根据实际数据路径判断,而不是根据产品名称套固定规则。
用默认拒绝后的功能验收收口
策略上线后,验证应覆盖“策略对象存在”和“平台功能仍可用”两层。先确认 NetworkPolicy 与业务 Pod 的状态:
kubectl -n <NAMESPACE> get networkpolicy
kubectl -n <NAMESPACE> get pods
预期结果:
NAME                    POD-SELECTOR   AGE
<NETWORKPOLICY-NAME>    <SELECTOR>     <TIME>

NAME             READY   STATUS    RESTARTS   AGE
<POD-NAME>       1/1     Running   0          <TIME>
实际名称、选择器和时间会不同。随后还要实际验证 DNS 查询、监控目标是否恢复可采集、日志是否继续进入后端、健康探针是否持续成功,并检查应用日志与平台告警。仅看到 Pod 为 Running,不能证明这些依赖仍然正常。
生产环境中可以把每条平台通信登记成“来源身份、目标身份、协议端口、方向、验证方法”五项记录,再只为确认存在的依赖开口。这样默认拒绝策略既不会退化成宽泛的全放行规则,也能减少隔离上线后才发现 DNS、监控或健康检查被意外切断的风险。