
容器与云原生 / 系统课时
建立网络策略排障证据链
建立网络策略排障证据链
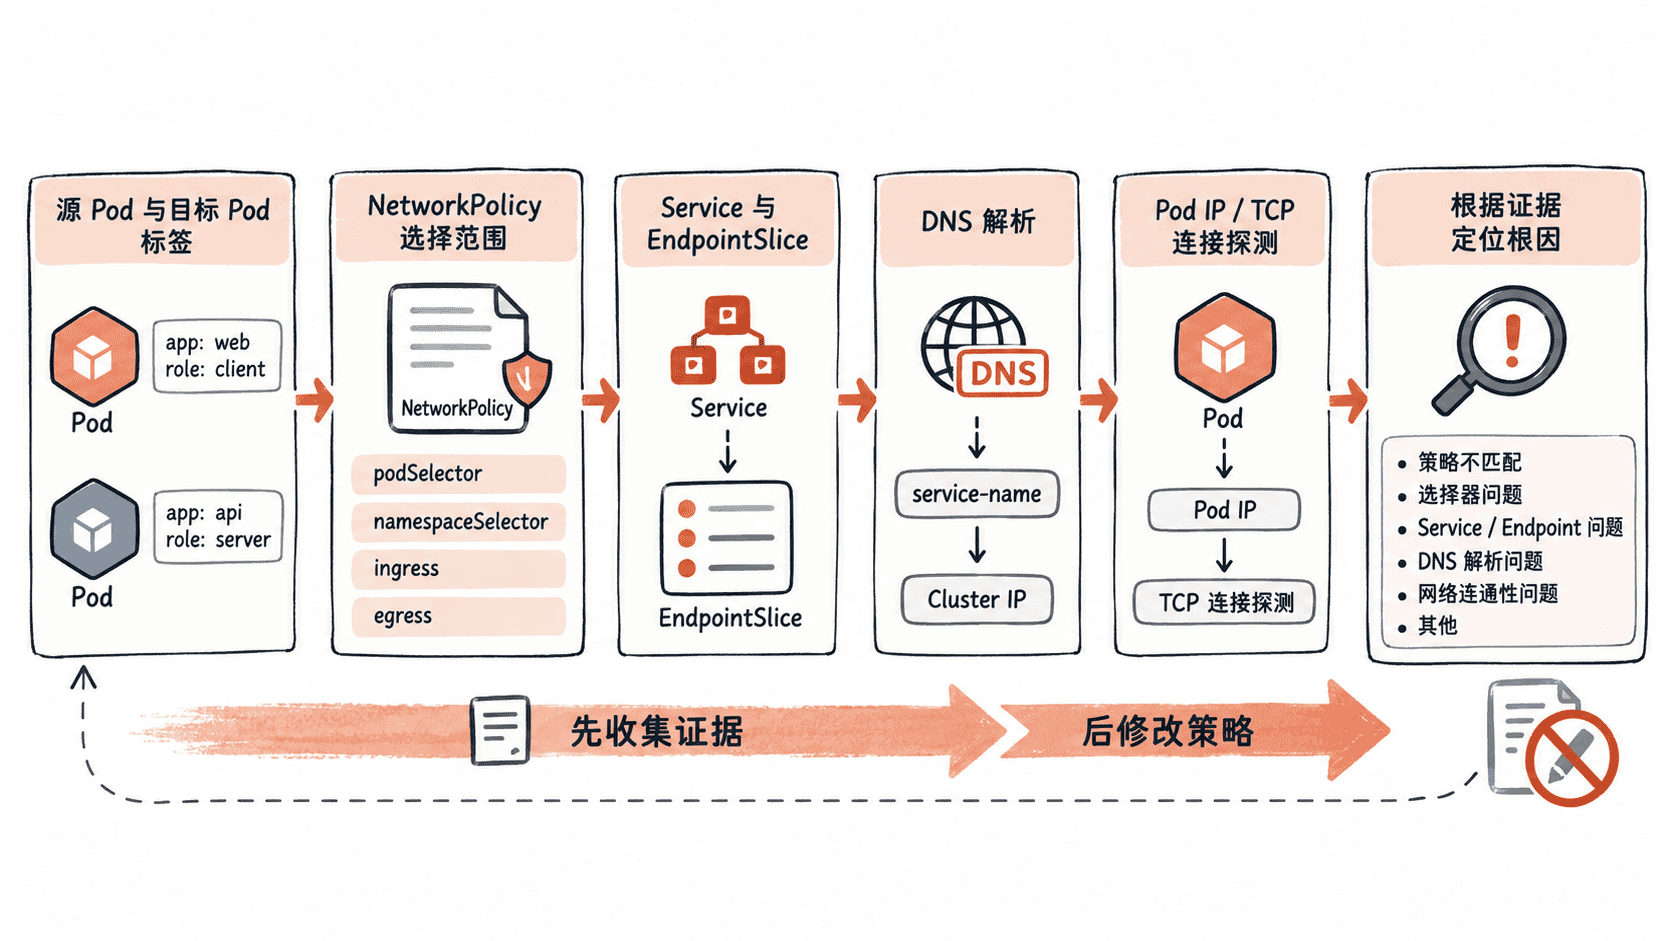
网络策略故障最容易陷入“改一条规则再试一次”的猜测式排查。本课建立一条可重复的证据链:先确认对象和标签,再确认策略选择范围、Service 端点与 DNS,最后用连接探测验证实际数据路径。
学习目标
- 按固定顺序收集 NetworkPolicy 故障所需的关键证据
- 区分标签选择、端点异常、DNS 失败与策略拒绝造成的连接问题
- 用可重复命令保存修复前后的验证结果
从工作负载与策略选择关系开始
排查时不要先改 YAML。第一步是确认源 Pod、目标 Pod、命名空间标签以及实际生效的 NetworkPolicy。NetworkPolicy 通过标签选择对象,同名应用只要标签不同,就可能完全不受同一条策略约束。
假设源 Pod 位于 team-a,目标服务位于 team-b,先收集对象与策略:
kubectl get pod -n team-a --show-labels
kubectl get pod -n team-b --show-labels
kubectl get namespace team-a team-b --show-labels
kubectl get networkpolicy -n team-a -o wide
kubectl get networkpolicy -n team-b -o wide
预期输出
NAME       READY   STATUS    AGE      LABELS
client     1/1     Running   <TIME>   app=client
NAME       READY   STATUS    AGE      LABELS
api-<ID>   1/1     Running   <TIME>   app=api
NAME     STATUS   AGE      LABELS
team-a   Active   <TIME>   tenant=team-a
team-b   Active   <TIME>   tenant=team-b
NAME             POD-SELECTOR   AGE
<policy-name>    app=api        <TIME>
实际名称、年龄和策略数量会不同。此时应回答三个问题:策略是否选中了预期 Pod,namespaceSelector 依赖的标签是否真实存在,以及源端和目标端是否分别被 egress 或 ingress 策略选中。
检查策略明细与服务端点
确认标签后,再读取策略完整内容,并检查 Service 是否真的拥有可用后端。若 Service 没有可用 EndpointSlice 端点,即使 NetworkPolicy 完全正确,连接同样会失败。
kubectl describe networkpolicy -n team-b <policy-name>
kubectl get service -n team-b
kubectl get endpointslice -n team-b -l kubernetes.io/service-name=<service-name> -o wide
预期输出
Name:         <policy-name>
Namespace:    team-b
PodSelector:  app=api
Policy Types: Ingress
...
NAME             TYPE        CLUSTER-IP   PORT(S)
<service-name>   ClusterIP   <IP>         8080/TCP
NAME          ADDRESSTYPE   PORTS   ENDPOINTS
<slice-name>  IPv4          8080    <IP>
如果 EndpointSlice 没有后端地址,或端点并未就绪,应先修复 Service selector、Pod readiness 或工作负载本身,而不是继续调整网络策略。
把 DNS 与网络连通性分开验证
应用访问通常先经过 DNS,再发起 TCP 或 HTTP 连接。因此 Could not resolve host 与 Connection timed out 不能归为同一种故障。先验证名称解析,再探测目标端口,才能判断问题发生在哪一层。下面假设 client 容器中已安装 nslookup 与 nc。
kubectl exec -n team-a client -- nslookup <service-name>.team-b.svc.cluster.local
kubectl exec -n team-a client -- sh -c 'if nc -z -w 3 <service-name>.team-b.svc.cluster.local 8080 >/dev/null 2>&1; then echo "TCP 8080 reachable"; else echo "TCP 8080 unreachable"; exit 1; fi'
预期输出
Name:      <service-name>.team-b.svc.cluster.local
Address:   <IP>
TCP 8080 reachable
nslookup 的详细格式可能因镜像中的工具实现而不同,但应能看到目标 Service 解析到实际 ClusterIP。若 DNS 失败,应继续检查到集群 DNS 的 egress 是否被策略限制;若 DNS 所在命名空间也有 ingress 隔离,还要检查 DNS Pod 的入站放行。若名称可以解析而端口探测失败,则重点回到源端 egress、目标端 ingress、端口和协议条件。
用 Pod IP 缩小故障范围
为了区分 Service/DNS 路径和 Pod 数据路径,可以取得一个目标 Pod IP 直接探测。这个测试用于定位,不代表生产应用应绕过 Service。
TARGET_IP=$(kubectl get pod -n team-b -l app=api -o jsonpath='{.items[0].status.podIP}')
kubectl exec -n team-a client -- sh -c "if nc -z -w 3 $TARGET_IP 8080 >/dev/null 2>&1; then echo \"Pod IP $TARGET_IP:8080 reachable\"; else echo \"Pod IP $TARGET_IP:8080 unreachable\"; exit 1; fi"
预期输出
Pod IP <IP>:8080 reachable实际 Pod IP 会不同,必须以命令读取到的地址为准。若 Pod IP 可通而 Service 名称不可通,优先检查 DNS、Service 和 EndpointSlice;若两者都不通,再根据源端 egress 与目标端 ingress 的联合结果定位策略条件。
固化修复后的验证证据
修复后应重跑同一组检查,而不是只观察应用“似乎恢复”。至少保留策略、标签、端点、DNS 和连接结果,这样才能证明哪一层发生变化。
kubectl get networkpolicy -n team-a -o yaml
kubectl get networkpolicy -n team-b -o yaml
kubectl get endpointslice -n team-b -l kubernetes.io/service-name=<service-name> -o wide
kubectl exec -n team-a client -- nslookup <service-name>.team-b.svc.cluster.local
kubectl exec -n team-a client -- sh -c 'if nc -z -w 3 <service-name>.team-b.svc.cluster.local 8080 >/dev/null 2>&1; then echo "TCP 8080 reachable"; else echo "TCP 8080 unreachable"; exit 1; fi'
预期结果
策略对象可读取
目标 Service 存在可用 EndpointSlice
DNS 返回目标 Service ClusterIP
TCP 8080 reachable
固定顺序的价值在于把“网络不通”拆成可证伪的小问题。标签与策略范围确认对象是否被管控,EndpointSlice 证明目标是否存在,DNS 测试验证名称解析路径,最后的连接探测才用于判断数据流是否真正通过。