
大数据与流处理 / 系统课时
管理状态描述符与序列化
管理状态描述符与序列化
状态能否从 checkpoint 或 savepoint 恢复,不只取决于状态值,还取决于 StateDescriptor、类型信息和 TypeSerializer。本篇把这条链路拆开,并给出升级状态类型时的检查方法。
学习目标
- 理解
StateDescriptor、TypeInformation与TypeSerializer的职责关系 - 显式声明状态类型,避免 Java 泛型擦除或 Kryo 回退带来的不确定性
- 在升级作业前识别可兼容、需迁移和不可兼容的状态变化
描述符决定如何找到并解释状态
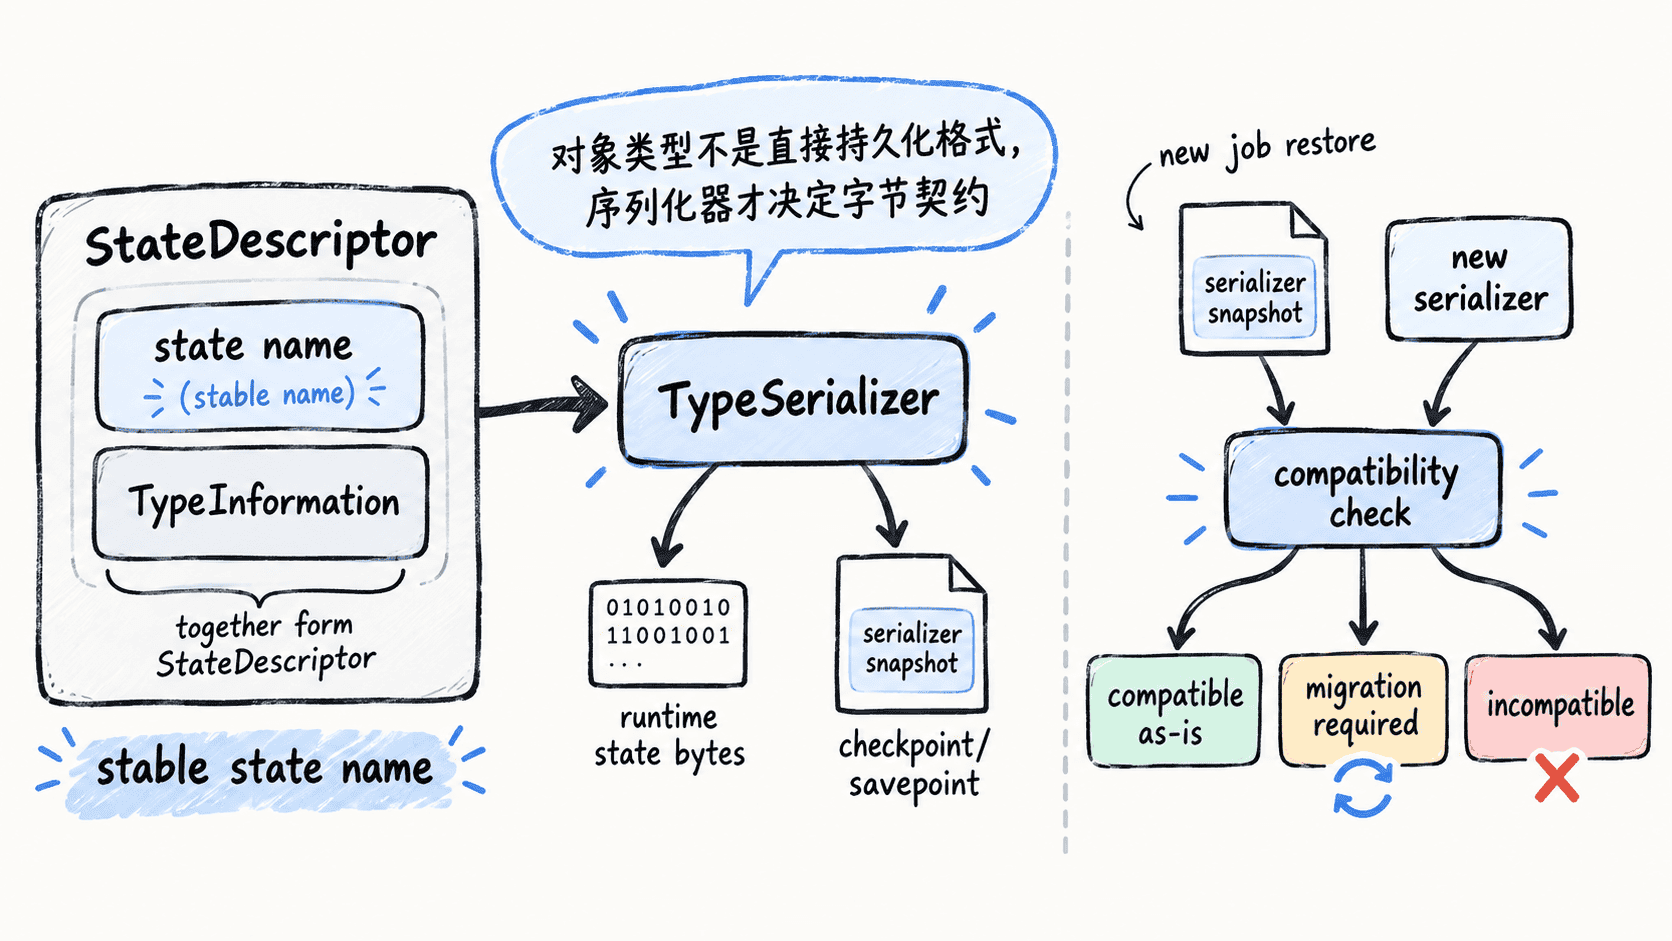
StateDescriptor 至少承担两件事:用稳定名称标识一份状态,并告诉 Flink 这份状态保存什么类型。运行时再根据 TypeInformation 创建或选择对应的 TypeSerializer,把 Java 对象转换成状态后端和 checkpoint 中的字节。
恢复时,Flink 不只是“把字节读回来”。它还要比较旧状态保存的序列化器快照与新作业准备使用的序列化器,判断能否直接读取、是否需要迁移,或者必须拒绝恢复。状态名称和序列化格式因此都属于持久化契约。
用明确类型创建状态描述符
下面的程序为每个用户维护订单次数和金额。OrderStats 是公开、可无参构造且字段公开的 POJO,因此 Flink 可以为它建立明确的类型信息,而不是把状态当作一个不透明的通用对象。
import org.apache.flink.api.common.functions.OpenContext;
import org.apache.flink.api.common.state.ValueState;
import org.apache.flink.api.common.state.ValueStateDescriptor;
import org.apache.flink.api.common.typeinfo.TypeInformation;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.RichFlatMapFunction;
import org.apache.flink.util.Collector;

public class StateDescriptorDemo {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        env.fromData(
                        TypeInformation.of(Event.class),
                        new Event("alice", 5),
                        new Event("alice", 7),
                        new Event("bob", 3))
                .keyBy(event -> event.user)
                .flatMap(new RunningTotal())
                .print();

        env.execute("state-descriptor-demo");
    }

    public static class RunningTotal extends RichFlatMapFunction<Event, String> {
        private transient ValueState<OrderStats> stats;

        @Override
        public void open(OpenContext openContext) throws Exception {
            TypeInformation<OrderStats> stateType =
                    TypeInformation.of(OrderStats.class);

            // 名称与类型共同构成这份持久化状态的重要契约。
            ValueStateDescriptor<OrderStats> descriptor =
                    new ValueStateDescriptor<>("order-stats", stateType);
            stats = getRuntimeContext().getState(descriptor);
        }

        @Override
        public void flatMap(Event event, Collector<String> out) throws Exception {
            OrderStats current = stats.value();
            if (current == null) {
                current = new OrderStats();
            }

            current.count += 1;
            current.amount += event.amount;
            stats.update(current);

            out.collect(event.user
                    + " count=" + current.count
                    + " amount=" + current.amount);
        }
    }

    public static class Event {
        public String user;
        public long amount;

        public Event() {}

        public Event(String user, long amount) {
            this.user = user;
            this.amount = amount;
        }
    }

    public static class OrderStats {
        public long count;
        public long amount;

        public OrderStats() {}
    }
}
预期输出
alice count=1 amount=5
alice count=2 amount=12
bob count=1 amount=3
这个示例的关键不在聚合逻辑,而在 new ValueStateDescriptor<>("order-stats", stateType):order-stats 应在兼容升级中保持稳定,stateType 则让 Flink 明确生成与该状态对应的序列化器。
泛型类型要防止信息被擦除
Java 会在运行时擦除大部分泛型参数。若状态类型是 Map<String, Long>、List<MyType> 之类,单独给一个原始 Class 往往不足以表达完整类型。此时可以用 TypeHint 保留参数化类型信息。
片段示例,放在 open 方法中替代状态类型声明即可:
TypeInformation<java.util.Map<String, Long>> stateType =
        TypeInformation.of(
                new org.apache.flink.api.common.typeinfo.TypeHint<
                        java.util.Map<String, Long>>() {});
这段代码不会单独产生控制台输出;验证方法是检查作业能正常构图并启动,同时确认状态描述符拿到的是带完整泛型参数的 TypeInformation。如果自定义类无法被识别为 Flink POJO,运行时可能退回通用序列化方案;对需要长期升级和恢复的状态,不要把这种回退当成可演进保证。
升级状态类型前先判断兼容性
Flink 会把序列化器相关快照随状态一起保存,并在恢复时做兼容性判断。对 Flink 自身类型序列化框架而言,当前自动 schema evolution 主要面向 POJO 与 Avro;这不等于任意 Java 类修改都能恢复。
POJO 的常见安全方向是新增字段或删除字段;新增字段恢复后使用 Java 默认值。字段类型不能随意更换,POJO 的类名和包名也不能任意改变。Key 的结构不支持 schema migration,因为 key 的字节身份决定分区和状态定位,改变后可能让原本不同或相同的 key 关系失真。
Kryo 也不应被当作状态 schema evolution 方案。若状态内部某一部分最终由 Kryo 序列化,不能假设修改类结构后 Flink 能替你验证并迁移旧字节。
如果确实需要把自定义 TypeSerializer 直接交给描述符,就必须同时把 TypeSerializerSnapshot 的兼容性设计当作版本协议:它负责恢复旧 serializer、比较新旧格式并声明是否可直接兼容或需要迁移。否则,自定义序列化器只是把风险从类型推断阶段移动到了恢复阶段。
把状态模式当作升级契约
稳定的状态升级流程应先固定 state name,再确认类型由哪个 TypeInformation 和 TypeSerializer 处理,最后用真实 savepoint 做恢复验证。这样遇到恢复失败时,可以明确区分“状态找不到”“类型信息变化”和“序列化格式不兼容”,而不是把所有问题都归因于 checkpoint。