
大数据与流处理 / 系统课时
理解 Operator State 适用边界
理解 Operator State 适用边界
Operator State 解决的是“每个并行子任务自己要记住什么”,而不是“某个业务 key 要记住什么”。本课从状态归属、扩缩容再分配和 CheckpointedFunction 用法出发,判断哪些场景该用 Operator State,哪些应改用 Keyed State。
学习目标
- 区分 Operator State 与 Keyed State 的归属单位和访问方式。
- 理解 List State 在恢复与改变并行度时的再分配方式。
- 能根据 source、sink、本地缓冲和按 key 业务状态选择合适方案。
先判断状态属于谁
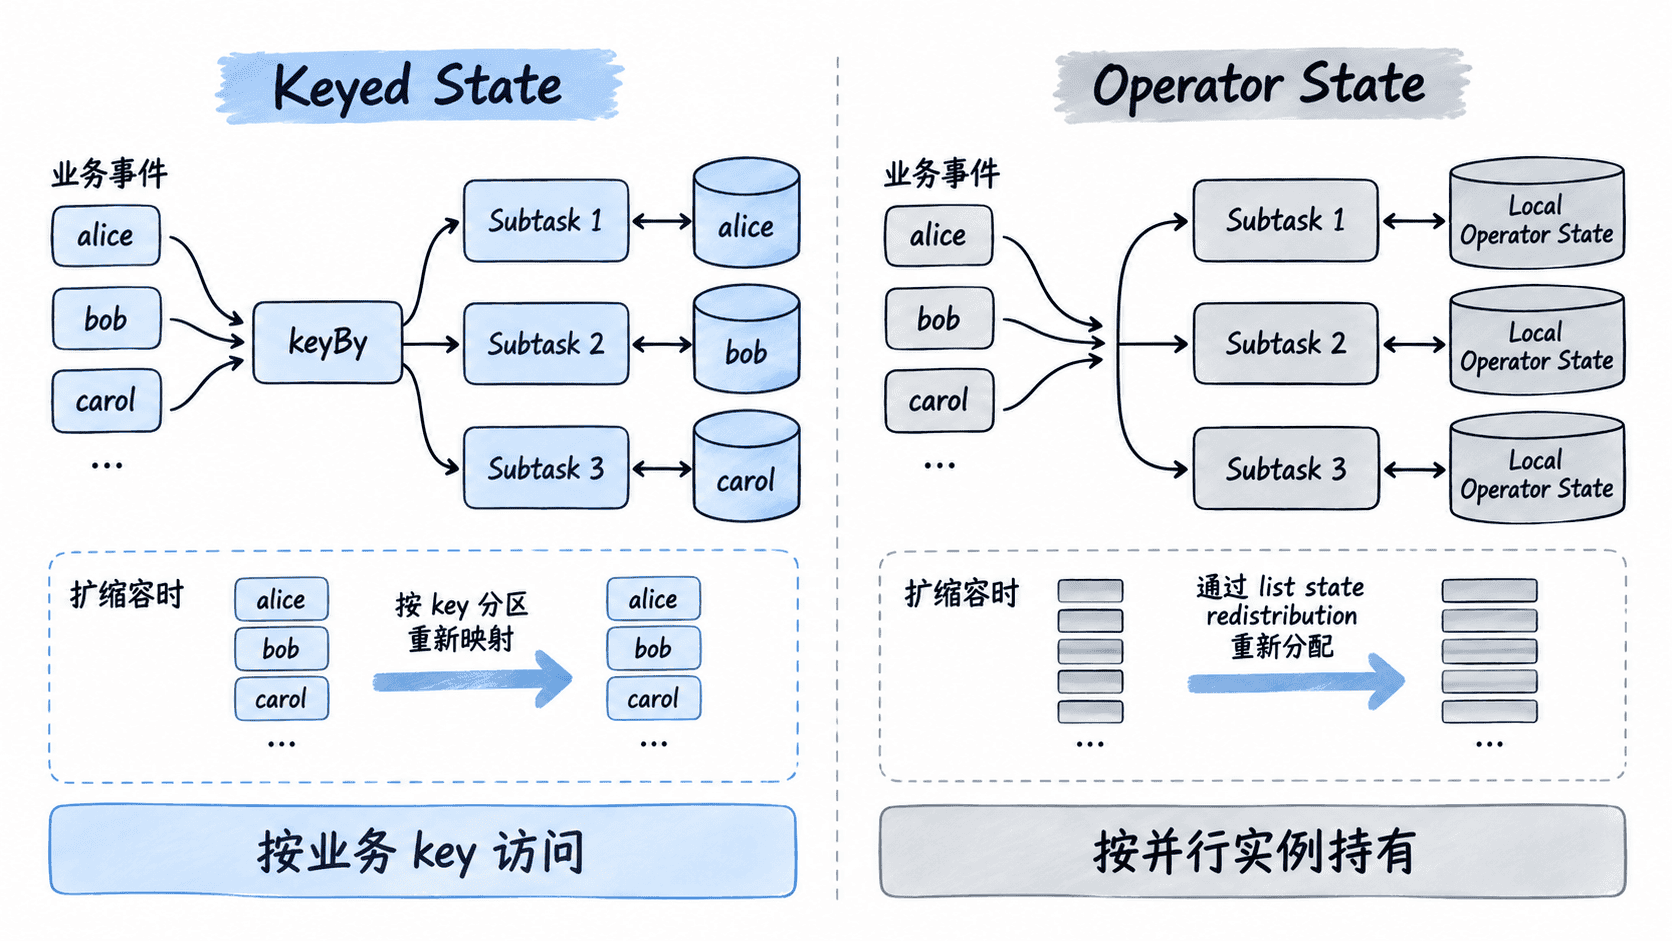
Keyed State 的归属单位是 key。调用 keyBy(...) 后,同一个 key 的状态始终通过 Flink 的分区机制交给负责该 key 的并行实例,应用代码看到的是当前 key 对应的 ValueState、MapState 等。
Operator State 的归属单位则是一个并行算子实例。子任务 0、子任务 1 可以各自保存不同内容,代码不能按业务 key 随机读取另一个子任务的 Operator State。它适合保存“这个子任务正在负责的分片、偏移、本地缓冲或阶段性元数据”。
用 CheckpointedFunction 保存子任务本地状态
自定义函数需要直接管理 Operator State 时,可以实现 CheckpointedFunction。snapshotState 在 checkpoint 时把当前内存状态写入托管状态,initializeState 则负责首次初始化以及从 checkpoint 或 savepoint 恢复。
下面的完整示例为每个并行实例维护本地计数。演示固定为并行度 1,因此输出可预测;把并行度调大后,每个子任务会形成自己的 localCount。
import org.apache.flink.api.common.functions.RichMapFunction;
import org.apache.flink.api.common.state.ListState;
import org.apache.flink.api.common.state.ListStateDescriptor;
import org.apache.flink.runtime.state.FunctionInitializationContext;
import org.apache.flink.runtime.state.FunctionSnapshotContext;
import org.apache.flink.streaming.api.checkpoint.CheckpointedFunction;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class OperatorStateDemo {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);
        env.enableCheckpointing(10_000);

        env.fromElements("A", "B", "C")
                .map(new LocalCounter())
                .print();

        env.execute("operator-state-demo");
    }

    static class LocalCounter
            extends RichMapFunction<String, String>
            implements CheckpointedFunction {

        private transient ListState<Long> checkpointedCount;
        private long localCount;

        @Override
        public String map(String value) {
            localCount++;
            return value + " localCount=" + localCount;
        }

        @Override
        public void snapshotState(FunctionSnapshotContext context)
                throws Exception {

            checkpointedCount.clear();
            // 一个子任务写入一个计数条目,后续可随并行度变化重新分配。
            checkpointedCount.add(localCount);
        }

        @Override
        public void initializeState(FunctionInitializationContext context)
                throws Exception {

            ListStateDescriptor<Long> descriptor =
                    new ListStateDescriptor<>("local-count", Long.class);

            checkpointedCount = context.getOperatorStateStore()
                    .getListState(descriptor);

            localCount = 0L;
            if (context.isRestored()) {
                // 缩容时一个新子任务可能收到多个旧条目,因此需要合并。
                for (Long value : checkpointedCount.get()) {
                    localCount += value;
                }
            }
        }
    }
}
预期输出
A localCount=1
B localCount=2
C localCount=3
这个有界示例通常会很快结束,重点是观察 API 结构;在持续运行的作业中,已完成 checkpoint 才会提供后续故障恢复所需的 Operator State 快照。
理解扩缩容时的再分配
通过 getListState(...) 获取的是可重新分配的 List State。恢复且并行度变化时,Flink 会把所有旧子任务的状态条目重新切分给新的并行实例,因此每个条目最好是可以独立搬迁的最小单元。示例在恢复时对收到的多个计数条目求和,就是为了覆盖缩容后一个实例接收多份旧状态的情况。
getUnionListState(...) 的语义不同:恢复时,每个新并行实例都会拿到所有旧条目的并集。它适合每个实例都确实需要完整集合的少量元数据;如果状态条目很多,把全集复制给每个子任务会明显放大恢复成本。
Broadcast State 是 Operator State 的特殊形式,用于把一条广播流中的规则、配置等维护到所有下游并行实例。普通 Operator State 并不会因为“属于算子”就自动复制到所有实例。
什么时候不该用 Operator State
如果需求是“按用户、订单、设备等业务 key 读取和更新独立状态”,应优先使用 keyBy(...) 加 Keyed State。把这类数据塞进 Operator State,会让业务 key 与子任务本地容器手工绑定,扩缩容时还要自己解决定位和迁移问题。
如果状态天然描述“当前子任务负责的资源”,例如 source 分片与偏移、sink 本地批次、无法按业务 key 分区的局部缓冲,Operator State 才是合适的边界。选择状态类型时先问“恢复后谁应该拿到这份状态”,通常比先挑 API 更可靠。