
大数据与流处理 / 系统课时
处理状态结构与序列化演进
处理状态结构与序列化演进
有状态作业升级最危险的变化,往往不是业务代码能否编译,而是新版本还能不能读懂旧 checkpoint 或 savepoint 中的字节。本篇用 serializer snapshot 的兼容判断解释恢复过程,并给出可验证的迁移路径,避免升级到一半才发现状态无法恢复。
学习目标
- 说明 Flink 为什么要为托管状态保存 serializer snapshot
- 区分直接兼容、需要迁移、可重配置与不兼容四类恢复结果
- 为高风险状态类型变化设计可回滚、可验证的迁移方案
恢复时先比较序列化契约
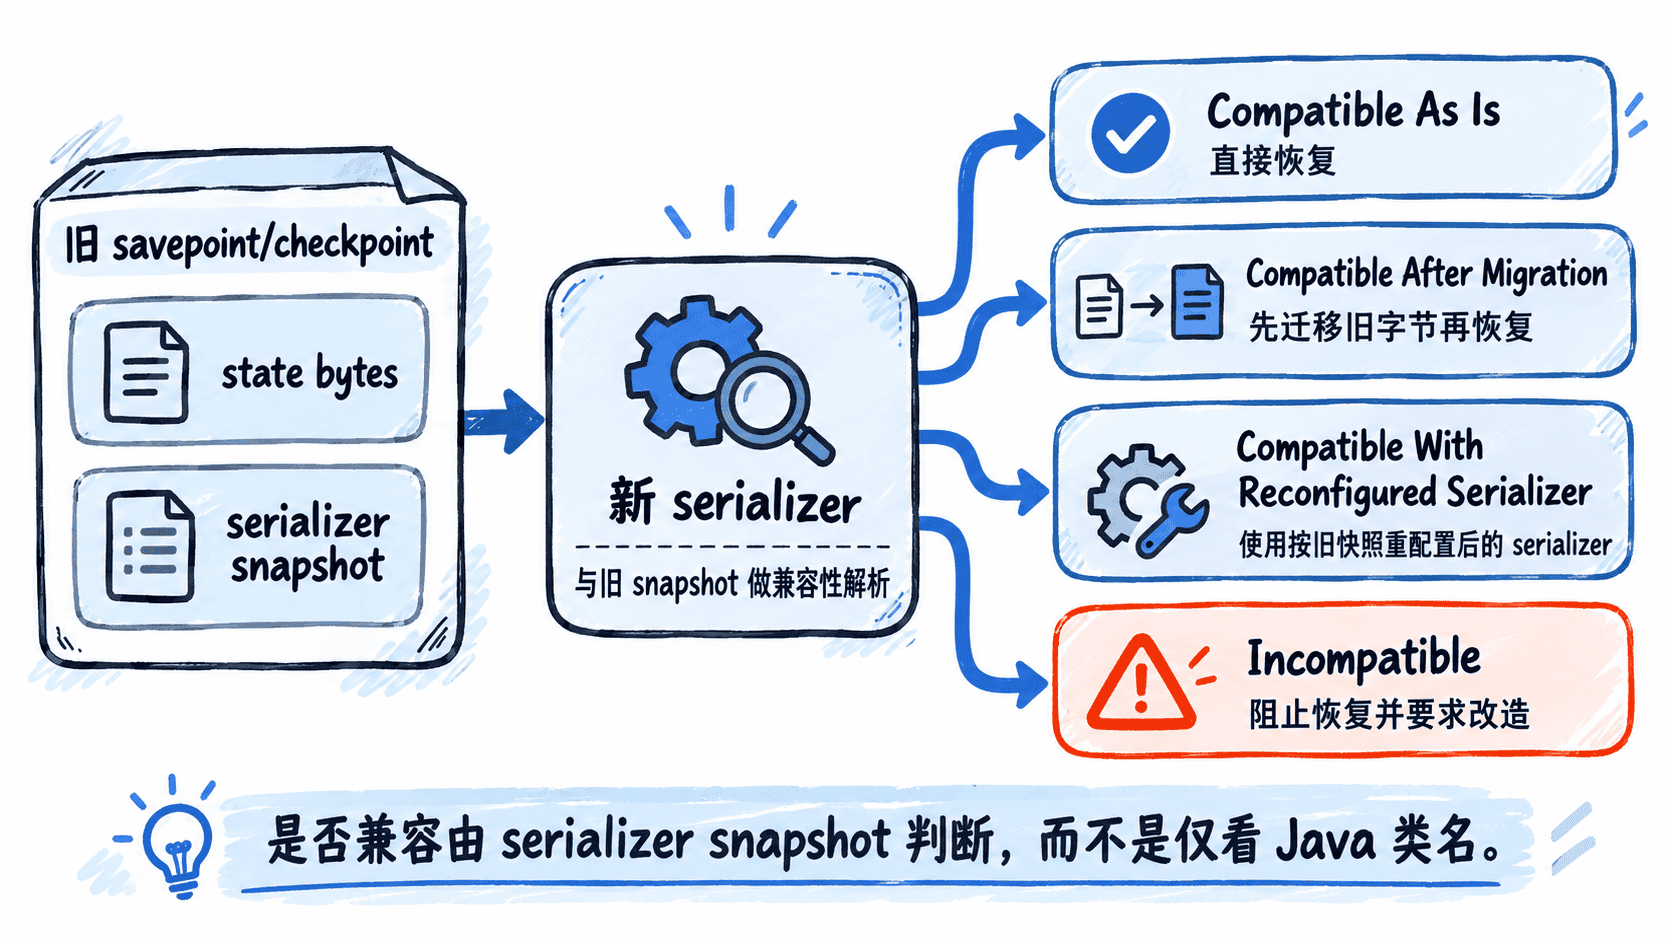
Flink 的托管状态不仅保存序列化后的数据,还会保存与状态序列化器相关的快照信息。恢复时,旧快照会参与判断新版本 serializer 能否继续解释这些字节,因此“Java 类型看起来差不多”并不能保证可以恢复。
兼容判断可以理解为四类结果:直接兼容时可按新 serializer 继续读取;需要迁移时必须把旧格式转换为新格式;可重配置时需要基于旧快照调整 serializer 后再读取;不兼容时则应终止恢复。具体结果由所用 serializer 及其 snapshot 实现决定,不能仅凭字段增删做猜测。
最容易踩坑的是同名 State 改类型
StateDescriptor 的名字用于在算子内部标识一份状态。若同一个 UID 下仍使用状态名 last-seen,但把值类型从 Long 直接改成 String,新版本就要求同一份旧状态突然换一种序列化契约。这个变化是否可恢复取决于 serializer 的兼容判断,不能把“能编译”当成“能从旧 savepoint 恢复”。
下面是一个故意展示风险的片段示例。它依赖同一个有状态算子和同一个稳定 UID,两个版本不会同时存在于一份源码中。
// v1:旧版本
ValueStateDescriptor<Long> oldDescriptor =
        new ValueStateDescriptor<>("last-seen", Long.class);

// v2:高风险直接改型
ValueStateDescriptor<String> newDescriptor =
        new ValueStateDescriptor<>("last-seen", String.class);
这类改动不要直接推到生产恢复。类似风险还包括更换 serializer 实现、改变类型注册方式、让原本的 POJO 退化到另一种序列化路径,或修改自定义 serializer 却没有同步维护自己的 TypeSerializerSnapshot。对于自定义 serializer,snapshot 本身就是升级协议的一部分。
用双状态做显式迁移
当新旧类型无法确认兼容时,一个更可控的做法是暂时保留旧状态定义,同时用新名字创建 v2 状态;新版本第一次读取 key 时,把旧值转换后写入新状态,再清理旧值。这样恢复阶段仍按旧 serializer 读取旧状态,类型转换发生在业务代码可控制的位置。
下面是核心迁移逻辑的片段示例,放在同一个 KeyedProcessFunction 或其他 keyed function 中。上下文需要在 open() 中初始化这两个 ValueState。
ValueState<Long> lastSeenV1;
ValueState<String> lastSeenV2;

String readAndMigrate() throws Exception {
    String current = lastSeenV2.value();
    if (current != null) {
        return current;
    }

    Long legacy = lastSeenV1.value();
    if (legacy == null) {
        return null;
    }

    // 显式迁移后再清理旧值,避免同一个 key 长期保留两份状态。
    String migrated = Long.toString(legacy);
    lastSeenV2.update(migrated);
    lastSeenV1.clear();
    return migrated;
}
迁移版本应继续保留原来的算子 UID,并把旧状态 descriptor 的名字和类型维持不变;否则你连读取旧值的机会都可能失去。等所有线上 key 都完成迁移并经过新的 savepoint 固化后,再评估后续版本是否删除旧状态代码。
用真实 savepoint 做升级门禁
序列化兼容性必须在“旧版本产生状态、新版本恢复状态”的链路上验证。先由当前生产等价版本生成 savepoint,再使用待发布 JAR 从这个 savepoint 启动。动态 ID、路径和实际日志会因环境不同而变化。
bin/flink savepoint <JOB_ID> <SAVEPOINT_DIR>
bin/flink run -s <SAVEPOINT_PATH> <PATH>/job-v2.jar
预期结果
Savepoint completed. Path: <SAVEPOINT_PATH>
Job has been submitted with JobID <ID>
只有作业成功提交还不够。还要检查恢复日志中是否出现 serializer compatibility、state migration 或 restore failure 相关异常,并用业务输入确认旧 key 的状态值连续。若恢复失败,不要用跳过未恢复状态来“绕过”关键业务状态;应先确认是 UID、State 名称还是 serializer 契约发生了变化。
设计可持续的状态演进规则
对长期运行的作业,状态类型应被当作持久化 schema 管理:稳定算子 UID,稳定关键 State 名称,重要对象使用明确、可测试的序列化方案;任何字段结构、容器类型或 serializer 的变化都先在旧 savepoint 上做恢复测试。
如果变化确实不兼容,就把迁移设计成一个独立发布阶段,而不是把“改业务逻辑、改状态结构、改并行度”同时塞进一次升级。这样出问题时可以明确知道失败发生在状态匹配、序列化兼容还是业务逻辑层,也更容易回滚到旧版本。