
大数据与流处理 / 系统课时
用 CheckpointedFunction 管理状态
用 CheckpointedFunction 管理状态
普通成员变量只活在当前算子实例的 JVM 内;任务失败并重建后,它不会自动回到故障前的值。本课用 CheckpointedFunction 把算子本地数据接入 Flink Checkpoint,在初始化、快照和恢复三个阶段之间建立清晰的状态边界。
学习目标
- 理解
initializeState()与snapshotState()各自负责的生命周期阶段 - 使用 Operator
ListState保存并恢复算子本地成员变量 - 避免把普通字段误当成可容错状态
状态为什么不能只放成员变量
Operator State 属于某个并行算子实例,不按 key 划分。普通字段可以作为运行时缓存,但它本身不受 Flink 状态后端管理:进程退出、Task 重启或作业从 Checkpoint 恢复时,只依赖字段里的值会丢失进度。
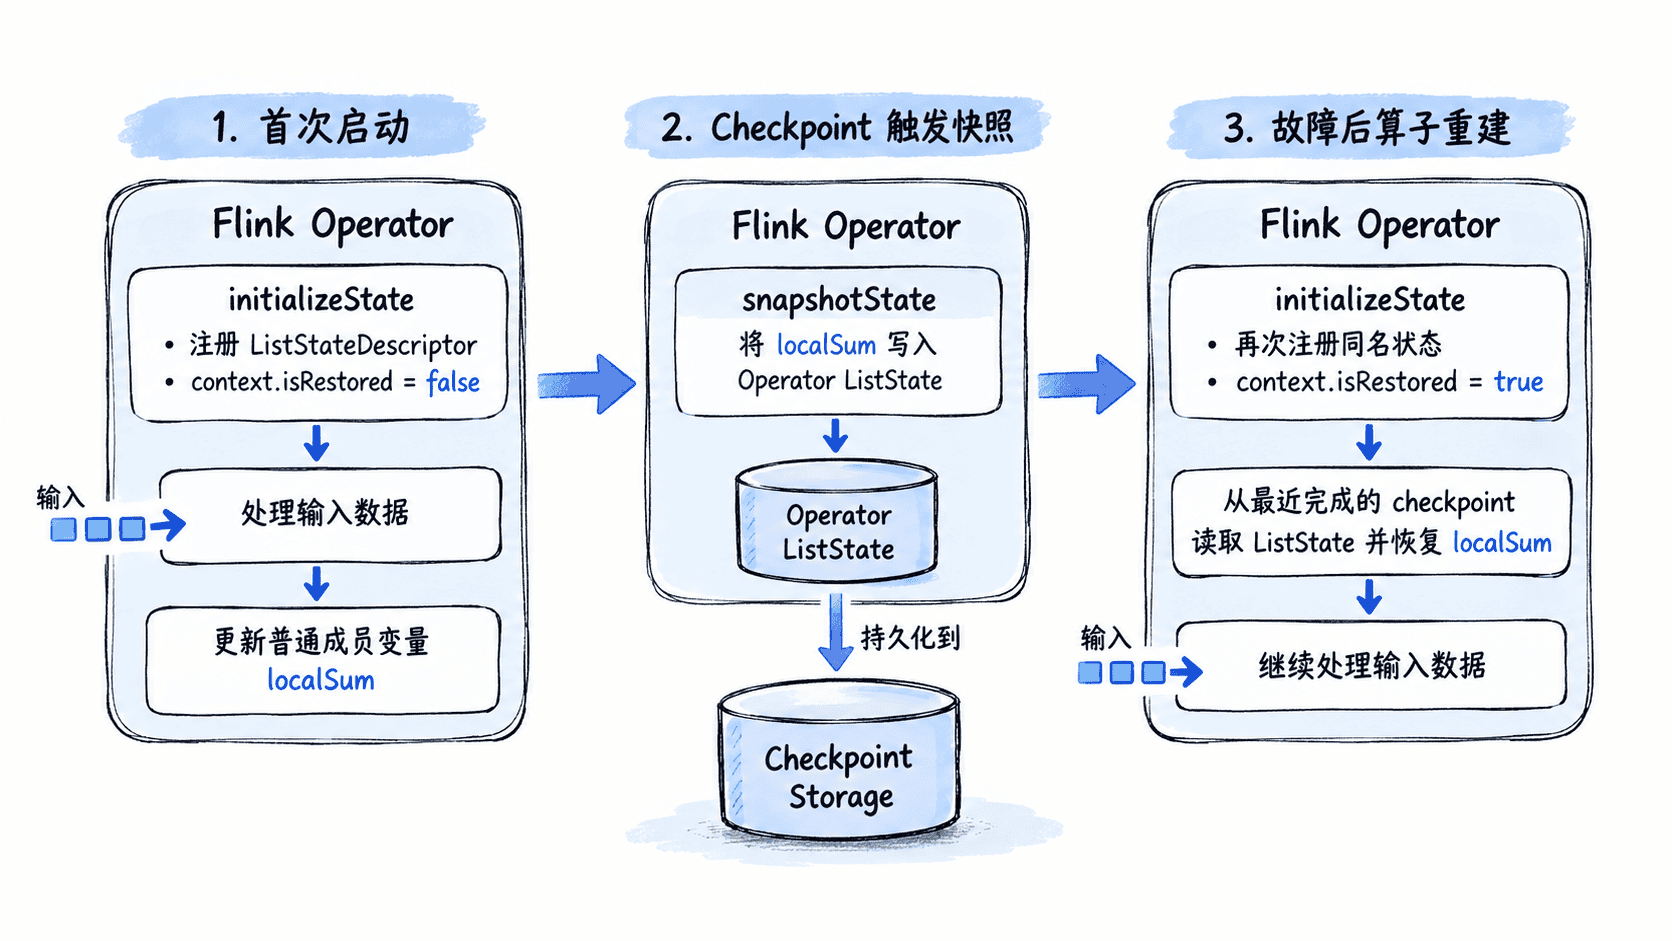
CheckpointedFunction 提供两个回调:initializeState() 在函数实例初始化时执行,首次启动和恢复都会进入;snapshotState() 在制作 Checkpoint 时执行。常见做法是把高频访问的数据留在普通字段中,再在快照时写入 Operator State,在恢复时反向装载。
用 ListState 保存本地累计值
下面的完整示例把每个子任务的累计和保存在 Operator ListState<Integer> 中。运行时读取和修改的是 localSum,Checkpoint 时再把它同步到受 Flink 管理的状态;恢复时则把状态中的值重新合并回字段。
import org.apache.flink.api.common.functions.MapFunction;
import org.apache.flink.api.common.state.ListState;
import org.apache.flink.api.common.state.ListStateDescriptor;
import org.apache.flink.runtime.state.FunctionInitializationContext;
import org.apache.flink.runtime.state.FunctionSnapshotContext;
import org.apache.flink.streaming.api.checkpoint.CheckpointedFunction;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class CheckpointedFunctionDemo {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);
        env.enableCheckpointing(1000);

        env.fromData(10, 20, 30)
                .map(new RunningSum())
                .setParallelism(1)
                .print()
                .setParallelism(1);

        env.execute("checkpointed-function-demo");
    }

    public static class RunningSum
            implements MapFunction<Integer, String>, CheckpointedFunction {

        private transient ListState<Integer> checkpointedSum;
        private int localSum;

        @Override
        public String map(Integer value) {
            localSum += value;
            return "sum=" + localSum;
        }

        @Override
        public void snapshotState(FunctionSnapshotContext context) throws Exception {
            // 当前子任务只维护一个累计值,因此每次快照覆盖旧内容。
            checkpointedSum.clear();
            checkpointedSum.add(localSum);
        }

        @Override
        public void initializeState(FunctionInitializationContext context)
                throws Exception {
            ListStateDescriptor<Integer> descriptor =
                    new ListStateDescriptor<>("running-sum", Integer.class);
            checkpointedSum =
                    context.getOperatorStateStore().getListState(descriptor);

            if (context.isRestored()) {
                // 缩容时一个子任务可能拿到多个状态元素,因此逐项合并。
                for (Integer saved : checkpointedSum.get()) {
                    localSum += saved;
                }
            }
        }
    }
}
预期输出(并行度为 1;控制台可能附带任务编号前缀):
sum=10
sum=30
sum=60
这段有限输入通常很快结束,主要用于验证代码路径和本地累计行为;真正验证恢复语义时,应让长时间运行的作业至少完成一次 Checkpoint,再制造失败并确认恢复后的状态连续。
把恢复逻辑放在正确的位置
initializeState() 不是只在故障恢复时调用,因此状态描述符和 getListState() 必须无条件执行;只有“把旧值读回业务字段”这一步需要由 context.isRestored() 判断。状态名和类型也应保持稳定,否则旧 Checkpoint 不能按原定义恢复。
snapshotState() 应保存能够重建运行时字段的最小必要数据。若本地结构是集合,可以先 clear() 再逐项 add(),或用适合的更新方式写回;不要把线程池、网络连接、客户端对象等运行时资源塞进状态,这些资源应在生命周期方法中重新创建。
验证容错是否真的生效
判断实现是否正确,不要只看正常运行时的输出。至少检查三个事实:作业能完成 Checkpoint;恢复时 context.isRestored() 为真且读到了状态;故障前后的业务进度没有从初始值重新开始。
如果状态只在字段里变化、snapshotState() 没有写回,故障后就会回退;如果只写了状态却没有在 initializeState() 恢复到运行时字段,恢复后的函数同样会从空状态继续。CheckpointedFunction 的关键不是“实现两个方法”,而是让运行时字段与托管状态在快照和恢复两个方向都保持一致。