
大数据与流处理 / 系统课时
理解 keyBy 与 Key Group
理解 keyBy 与 Key Group
keyBy 不只是把相同 key 的记录发到同一个并行实例,它还决定了 Keyed State 的归属基础。理解 key、Key Group、并行度和最大并行度之间的关系,才能解释为什么扩缩容后状态仍能被正确找回。
学习目标
- 说明
keyBy如何把相同 key 的记录路由到同一逻辑分区 - 区分 key、Key Group、并行子任务三层归属关系
- 判断并行度变化时 Keyed State 为什么能够随 Key Group 重新分配
从 keyBy 到 Keyed Stream
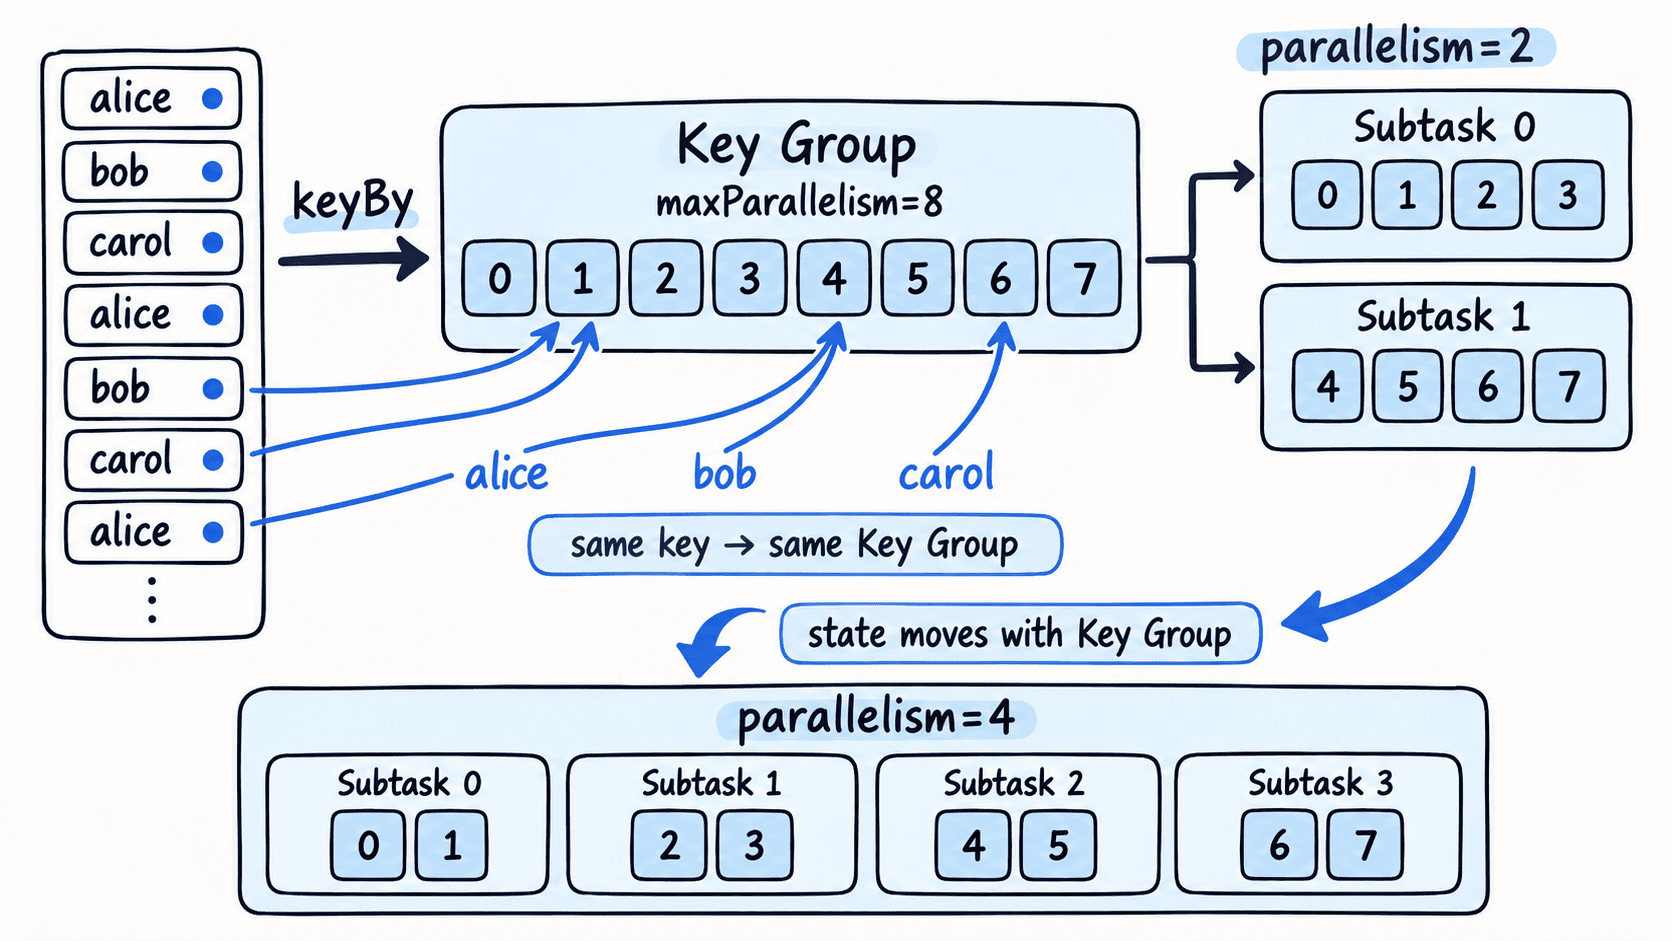
调用 keyBy 后,Flink 会根据选择出的 key 对记录进行确定性哈希,并把每个 key 映射到一个 Key Group。相同 key 始终落入同一个 Key Group,因此它们会被同一个下游并行子任务处理,这也是 ValueState、ListState 等 Keyed State 能按 key 隔离的前提。
这里要区分“逻辑归属”和“当前运行实例”。状态首先归属于 key,再经由 Key Group 组织;并行子任务只是某一时刻负责一段 Key Group 范围的执行者。任务重启或改变并行度时,执行者可以变化,但状态仍按 Key Group 重新分派。
Key Group 为什么存在
如果状态直接绑定到某个并行子任务,那么把并行度从 2 调到 4 时,就很难精确切分原有状态。Key Group 提供了稳定的中间层:作业创建时由 maxParallelism 决定 Key Group 总数,每个 key 先被映射到其中一个组,再把这些组分给当前并行子任务。
例如 maxParallelism = 8、parallelism = 2 时,可以把 Key Group 0-3 分给子任务 0,把 4-7 分给子任务 1。恢复为 parallelism = 4 后,同样 8 个 Key Group 会被重新划分为更小的连续范围。状态文件可以按这些范围装载到新的子任务,而不必重新扫描所有业务 key。
状态到底属于谁
可以把归属关系记成一条链:key → Key Group → 当前并行子任务。其中前两层在给定 maxParallelism 时保持稳定,最后一层会随着 parallelism 改变。
| 对象 | 作用 | 扩缩容时是否变化 |
|---|---|---|
| key | 区分业务实体,如用户或设备 | 不变化 |
| Key Group | 聚合一组 key 的状态,作为重分配单元 | 编号不变化 |
| 并行子任务 | 实际执行计算并持有分配到的 Key Group | 可能变化 |
因此,keyBy 的真正意义不仅是负载分区,还把后续算子带入 keyed 上下文。只有在 keyed 上下文中,运行时才能根据当前记录的 key 定位对应状态,并在 checkpoint 与恢复过程中按 Key Group 组织和迁移这些状态。
选择并行度时要看什么
提高 parallelism 只能增加执行槽位,不能自动消除数据倾斜。如果大量记录集中在极少数 key 上,这些热点 key 仍只能落到少数 Key Group,并由相应子任务处理。此时瓶颈来自 key 分布,而不是 Key Group 数量不足。
另一方面,maxParallelism 一旦随带状态快照进入生产,就不应随意调整。它影响 key 到 Key Group 的映射;改变这层映射会破坏已有 Keyed State 的稳定归属。设计作业时应为未来扩容预留合理上限,同时避免盲目设得过大。
只要记住“相同 key 固定进入同一 Key Group,Key Group 再分给当前并行子任务”,就能解释 keyBy、状态隔离、扩缩容与恢复之间的共同基础。