
大数据与流处理 / 系统课时
配置重启策略与故障恢复
配置重启策略与故障恢复
Flink 作业失败后,恢复效果取决于失败检测、重启节奏、受影响任务范围和状态恢复能否衔接。本课用 fixed-delay 与 failure-rate 两种策略建立一条可验证的恢复链路,并说明什么时候应该让作业停止而不是无限重试。
学习目标
- 说清任务失败、重启策略与状态恢复之间的关系
- 配置并区分
fixed-delay与failure-rate的适用场景 - 根据重启次数、检查点与最终状态验证恢复是否符合预期
看清一次故障恢复
任务抛出未处理异常、进程退出或依赖不可用时,Flink 会先判定执行失败。重启策略回答“是否重启、何时重启”,Failover 机制决定哪些受影响的任务需要重新部署;如果存在可用的已完成 Checkpoint,重启后的有状态算子再从该快照恢复状态。
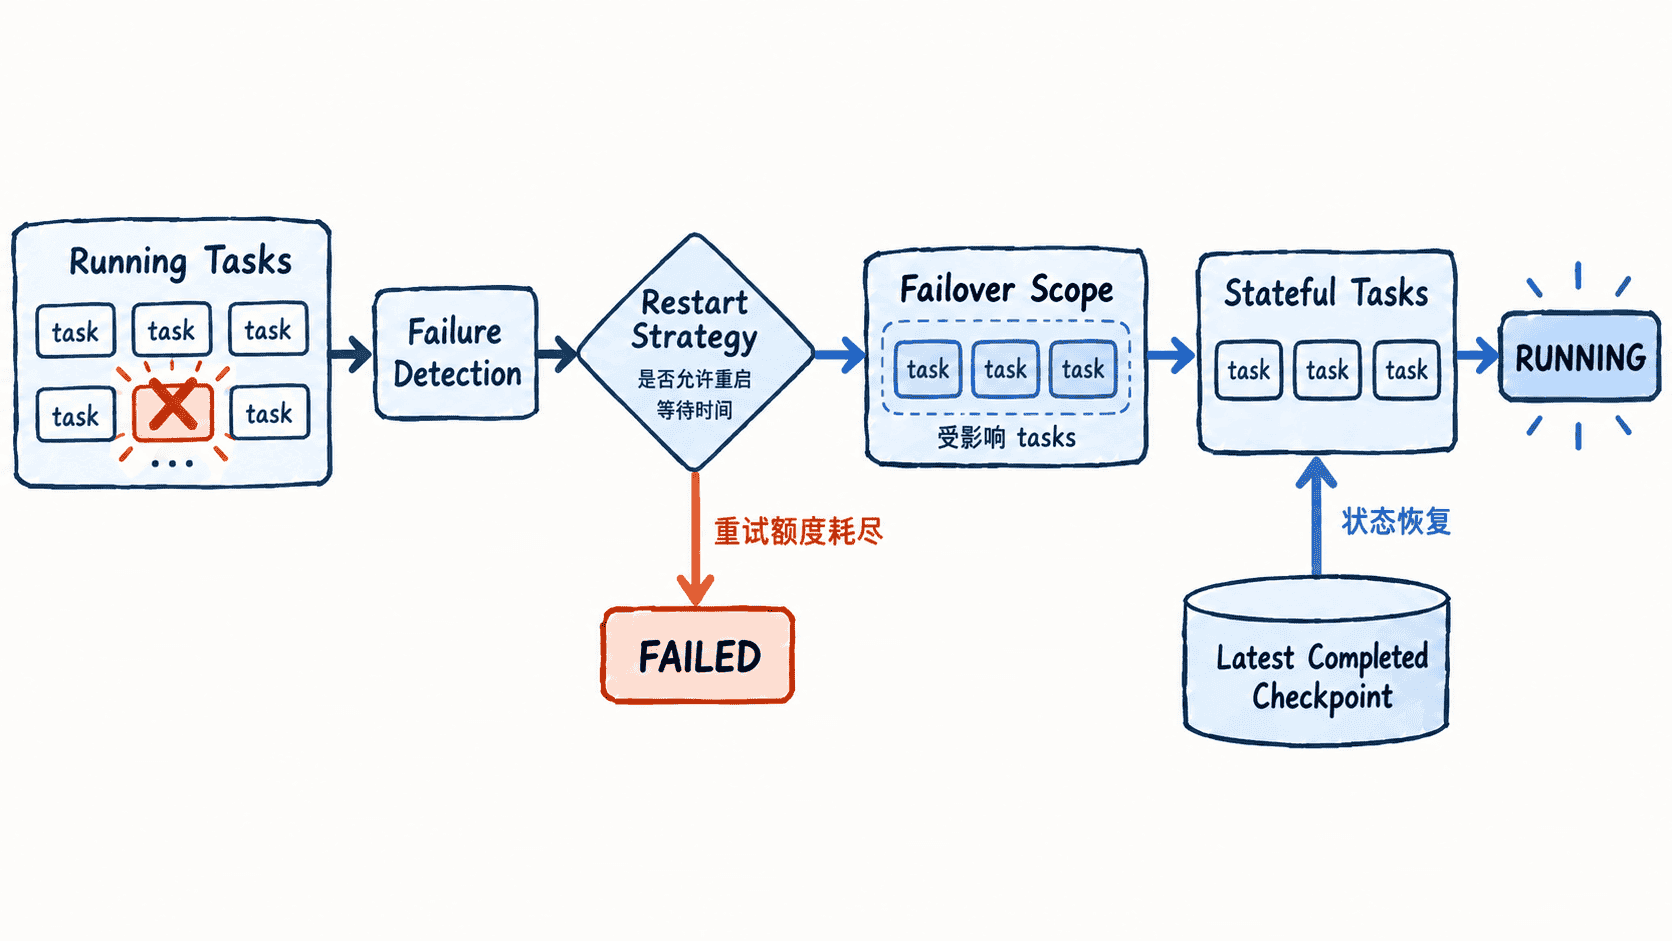
这也意味着“配置了重启”不等于“状态一定能恢复”。没有可用快照时,重启策略只能重新拉起执行;能否从源端重放并重建正确结果,还取决于 Source、状态和 Sink 的语义。
使用 fixed-delay 控制有限重试
fixed-delay 适合故障恢复时间比较可预测、并且希望设置明确重试上限的场景,例如短暂网络闪断或外部数据库重启。下面把最大重启次数设为 3,每次之间等待 10 秒。
restart-strategy.type: fixed-delay
restart-strategy.fixed-delay.attempts: 3
restart-strategy.fixed-delay.delay: 10 s
预期结果
第 1 次失败 -> 等待约 10 s -> 第 1 次重启
第 2 次失败 -> 等待约 10 s -> 第 2 次重启
第 3 次失败 -> 等待约 10 s -> 第 3 次重启
再次失败且重启次数已耗尽 -> 作业进入 FAILED
这是集群级默认策略;如果作业提交时显式设置了自己的重启策略,作业级配置会覆盖集群默认值。配置变更是否需要重启集群或重新提交作业,取决于你的部署方式。
使用 failure-rate 限制故障密度
failure-rate 不直接限制作业生命周期内的总重启次数,而是限制一个时间窗口中的失败密度。它适合允许偶发故障、但不希望持续抖动的长时间运行作业。
restart-strategy.type: failure-rate
restart-strategy.failure-rate.max-failures-per-interval: 3
restart-strategy.failure-rate.failure-rate-interval: 5 min
restart-strategy.failure-rate.delay: 10 s
预期结果
任意 5 min 统计窗口内最多允许 3 次重启
每次允许重启前等待约 10 s
继续出现故障并超过该窗口的重启上限 -> 作业进入 FAILED选择策略时不要只看“想不想重启”。fixed-delay 更像单次故障处置的固定预算;failure-rate 更适合识别“偶发失败”和“持续不稳定”的差别。对于代码缺陷、坏数据必现、权限永久失效等确定性故障,提高重试额度只会延迟暴露问题。
验证恢复而不是只看 RUNNING
验证时应同时观察执行状态和状态连续性。先确认失败后确实进入重启等待,再确认受影响任务被重新部署;随后检查恢复使用的是预期的最新已完成 Checkpoint,并用业务状态或测试事件确认计数、窗口或去重状态没有意外回到初始值。