
大数据与流处理 / 系统课时
观察状态与 Checkpoint 指标
观察状态与 Checkpoint 指标
这一课把“Checkpoint 看起来正常吗”变成一套可复核的读数方法:先从 Web UI 找到最近检查点,再结合状态体积、耗时、对齐、失败计数与恢复信号,判断问题更像状态增长、反压还是存储侧异常。
学习目标
- 能从 Flink Web UI 的 Checkpoints 页面读取最近检查点的状态与耗时。
- 能区分检查点增量大小、完整状态大小、对齐时间和屏障到达延迟。
- 能用 REST 指标留下可比较的运行证据,而不是只凭单次截图判断。
先看 Checkpoints 页再看单个算子
进入正在运行的 Job 后打开 Checkpoints。先看最近几次检查点是 COMPLETED、FAILED 还是仍在进行,再比较端到端耗时、数据大小和各算子的子任务明细。若只有某个算子或少数 subtask 明显偏慢,应继续下钻到该节点,而不是直接修改全局超时。
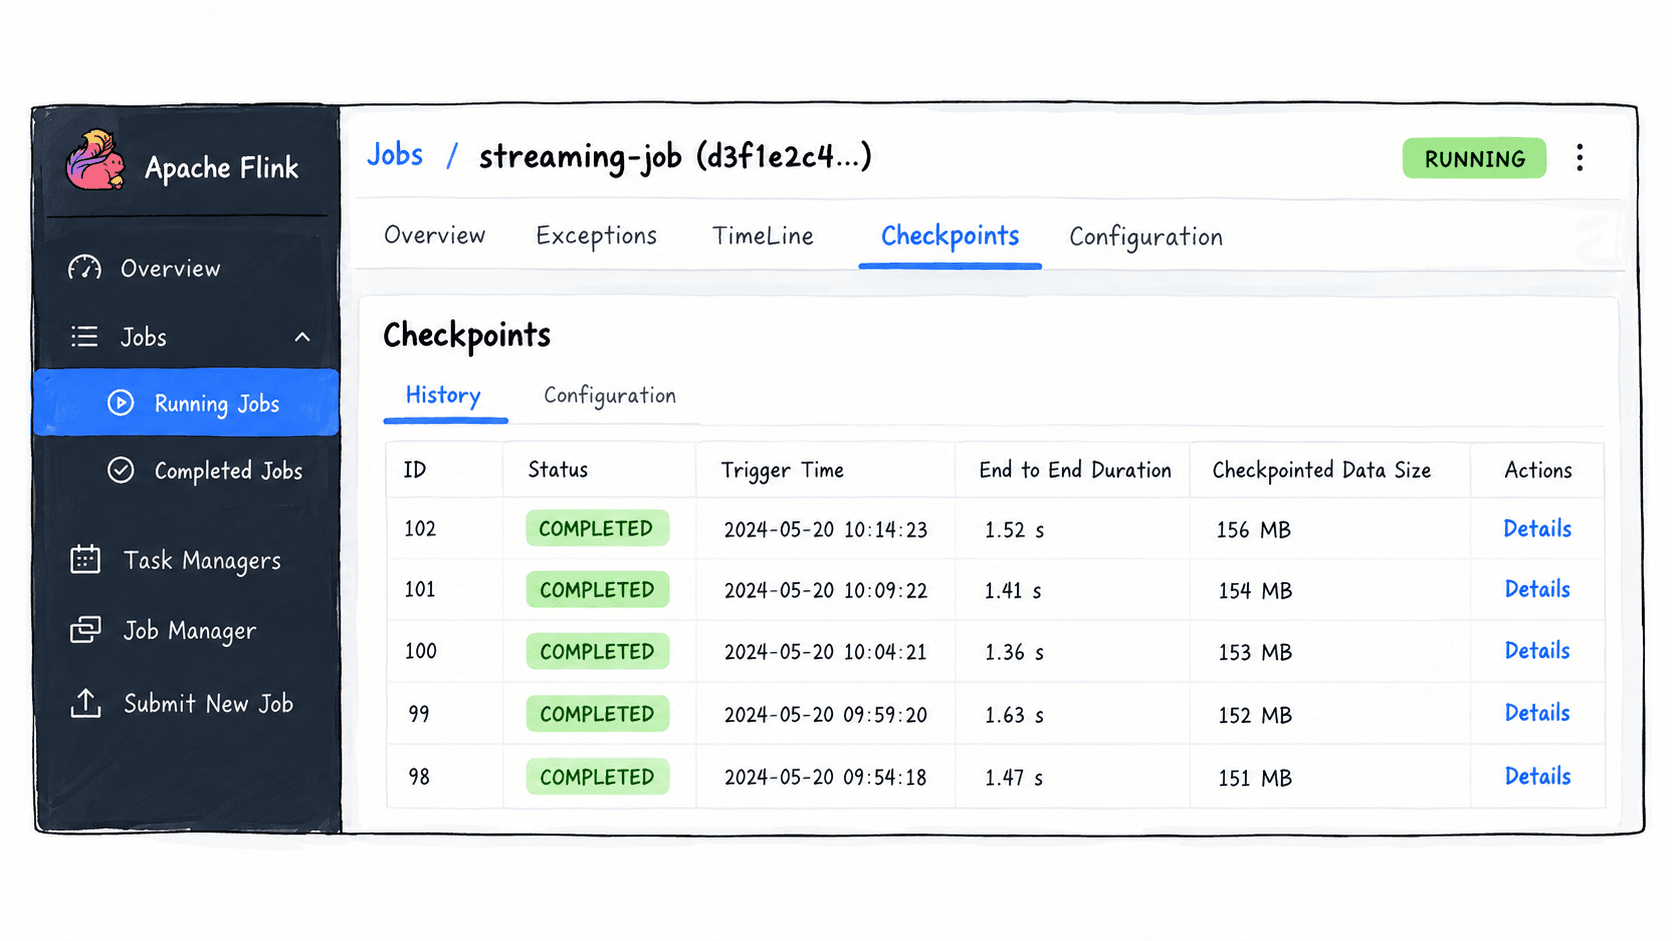
Web UI 的字段名称会随版本略有差异,但核心读法一致:先确认检查点是否完成,再看持续时间和大小,最后下钻到 task/subtask 的屏障传播与对齐信号。Flink 还提供作业级 lastCheckpointDuration、lastCheckpointSize、lastCheckpointFullSize、numberOfFailedCheckpoints 与恢复时间戳等指标。([Apache Nightlies][1])
用几组指标判断问题落在哪一层
| 指标或页面字段 | 主要回答的问题 | 典型解读 |
|---|---|---|
lastCheckpointDuration / End to End Duration |
最近一次检查点花了多久 | 持续升高说明先要继续拆分屏障传播、快照和存储耗时 |
lastCheckpointSize |
本次实际 checkpoint 的数据量多大 | 启用增量 checkpoint 或 changelog 时,它可能只是本次增量,不能直接当作全部状态 |
lastCheckpointFullSize |
对应 checkpoint 的完整状态规模多大 | 适合观察状态是否长期增长 |
checkpointStartDelayNanos |
checkpoint 创建后,屏障多久才到达当前 task | 值高常提示上游传播受阻,可与反压指标一起判断 |
checkpointAlignmentTime |
多输入 task 从收到第一个到最后一个 barrier 等了多久 | 值高说明输入进度不均或存在反压,需要定位最慢输入 |
numberOfFailedCheckpoints |
检查点失败是否在累积 | 只能说明症状,应结合失败详情和日志找原因 |
lastCheckpointRestoreTimestamp |
最近是否发生过从 checkpoint 恢复 | 说明发生过恢复,不等于恢复后的作业一定健康 |
启用增量 checkpoint 后,Web UI 中的 Checkpointed Data Size 可能只表示本次增量,而不是完整状态大小。因此判断“状态是不是越来越大”时,应优先看完整状态规模或连续多次 checkpoint 的趋势,避免把增量很小误判成总状态很小。([Apache Nightlies][2])
用 REST API 留下可比较的证据
Web UI 适合快速浏览,REST API 更适合把同一组指标定期采样。下面请求作业级 checkpoint 指标;先把 <HOST>、<PORT> 和 <JOB_ID> 替换成实际值,其中 REST 与 Web UI 通常由同一 JobManager Web 服务提供。
curl -s "http://<HOST>:<PORT>/jobs/<JOB_ID>/metrics?get=lastCheckpointDuration,lastCheckpointSize,lastCheckpointFullSize,numberOfFailedCheckpoints,lastCheckpointRestoreTimestamp"预期输出
[
  {"id":"lastCheckpointDuration","value":"<DURATION_MS>"},
  {"id":"lastCheckpointSize","value":"<CHECKPOINTED_BYTES>"},
  {"id":"lastCheckpointFullSize","value":"<FULL_BYTES>"},
  {"id":"numberOfFailedCheckpoints","value":"<COUNT>"},
  {"id":"lastCheckpointRestoreTimestamp","value":"<TIMESTAMP_MS>"}
]
实际数值和返回顺序可能不同;如果某个指标在当前作业或版本中未注册,它也可能不出现在结果中。Flink 的 Monitoring REST API 支持通过 /jobs/<jobid>/metrics 查询作业指标,也提供 /jobs/<jobid>/checkpoints 和单次 checkpoint 详情接口。([Apache Nightlies][3])
把恢复信号和当前健康状态分开
看到恢复时间戳时,不要直接得出“容错已经成功”的结论。还要确认 Job 当前处于 RUNNING,最近的 checkpoint 已重新稳定完成,并检查恢复后状态大小、处理吞吐和失败计数是否回到基线。恢复只证明作业尝试从某个快照重新启动,后续是否健康仍要靠新的运行指标验证。
一次有价值的观测至少应回答三个问题:最近 checkpoint 是否成功、耗时主要卡在哪一段、状态规模是否异常变化。把这三类证据同时保留下来,后续排障才不会陷入“只看到总耗时变长,却不知道为什么”的死胡同。