
大数据与流处理 / 系统课时
用稳定 UID 支持扩缩容
用稳定 UID 支持扩缩容
有状态作业扩缩容时,真正要保住的不是“第几个并行实例”,而是逻辑算子与其状态的身份。稳定 UID 负责把新旧作业图中的同一算子对应起来,Key Group 和 Operator State 的重分配机制则负责把状态交给新的并行实例。
学习目标
- 为有状态算子设置稳定且唯一的 UID,避免拓扑调整后无法匹配旧状态
- 解释并行度变化时 Keyed State 如何按 Key Group 重新分配
- 区分 List Operator State 的均分恢复与 Union List State 的全量恢复
先固定逻辑算子的身份
Flink 会为算子生成内部 Operator ID,但自动生成的 ID 与作业图结构有关。插入算子、调整链路或改写拓扑后,自动 ID 可能变化;恢复 savepoint 时,新作业便可能找不到原先那份状态。对需要跨版本恢复的有状态算子,应显式调用 uid(),并让这个值长期稳定。
下面的完整示例给有状态计数算子设置固定 UID,同时把最大并行度固定为 128。maxParallelism 决定 Key Group 的数量,同时也是可设置运行并行度的上限和后续 Keyed State 重分配的重要边界。
import org.apache.flink.api.common.state.ValueState;
import org.apache.flink.api.common.state.ValueStateDescriptor;
import org.apache.flink.api.common.typeinfo.Types;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.KeyedProcessFunction;
import org.apache.flink.util.CloseableIterator;
import org.apache.flink.util.Collector;

import java.util.ArrayList;
import java.util.Collections;
import java.util.List;

public class StableUidRescaleDemo {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();

        // 给参与恢复的逻辑算子设置稳定 UID,避免拓扑变化后身份漂移。
        var counts = env
                .fromElements("alice", "bob", "alice")
                .uid("events-source")
                .keyBy(value -> value)
                .process(new RunningCount())
                .uid("count-by-user")
                .setParallelism(2)
                // 最大并行度定义 Key Group 空间,不应在已有状态后随意修改。
                .setMaxParallelism(128);

        List<String> result = new ArrayList<>();
        try (CloseableIterator<String> it = counts.executeAndCollect()) {
            it.forEachRemaining(result::add);
        }

        Collections.sort(result);
        result.forEach(System.out::println);
    }

    static class RunningCount
            extends KeyedProcessFunction<String, String, String> {
        private transient ValueState<Integer> count;

        @Override
        public void open(org.apache.flink.api.common.functions.OpenContext context)
                throws Exception {
            // State 名称也要稳定,恢复时会用它定位算子内部的状态。
            count = getRuntimeContext().getState(
                    new ValueStateDescriptor<>("count", Types.INT));
        }

        @Override
        public void processElement(
                String value,
                Context ctx,
                Collector<String> out) throws Exception {
            Integer current = count.value();
            int next = current == null ? 1 : current + 1;
            count.update(next);
            out.collect(value + "=" + next);
        }
    }
}
预期输出
alice=1
alice=2
bob=1
这里最关键的不是输出内容,而是 uid("count-by-user")。只要升级后的作业仍把同一份状态绑定到这个 UID,Flink 才能在恢复时把旧算子状态映射给新算子。UID 在同一作业中应保持唯一,不要把会变化的类名、并行度或发布日期拼进 UID。
Keyed State 按 Key Group 搬家
Keyed State 不是按“旧 subtask 0 的状态直接交给新 subtask 0”恢复。Flink 会先把 key 映射到固定的 Key Group,再根据当前并行度把一段段 Key Group 范围分配给各个 subtask。扩容或缩容时,变化的是 Key Group 到 subtask 的归属,而同一个 key 仍落在确定的 Key Group 中。
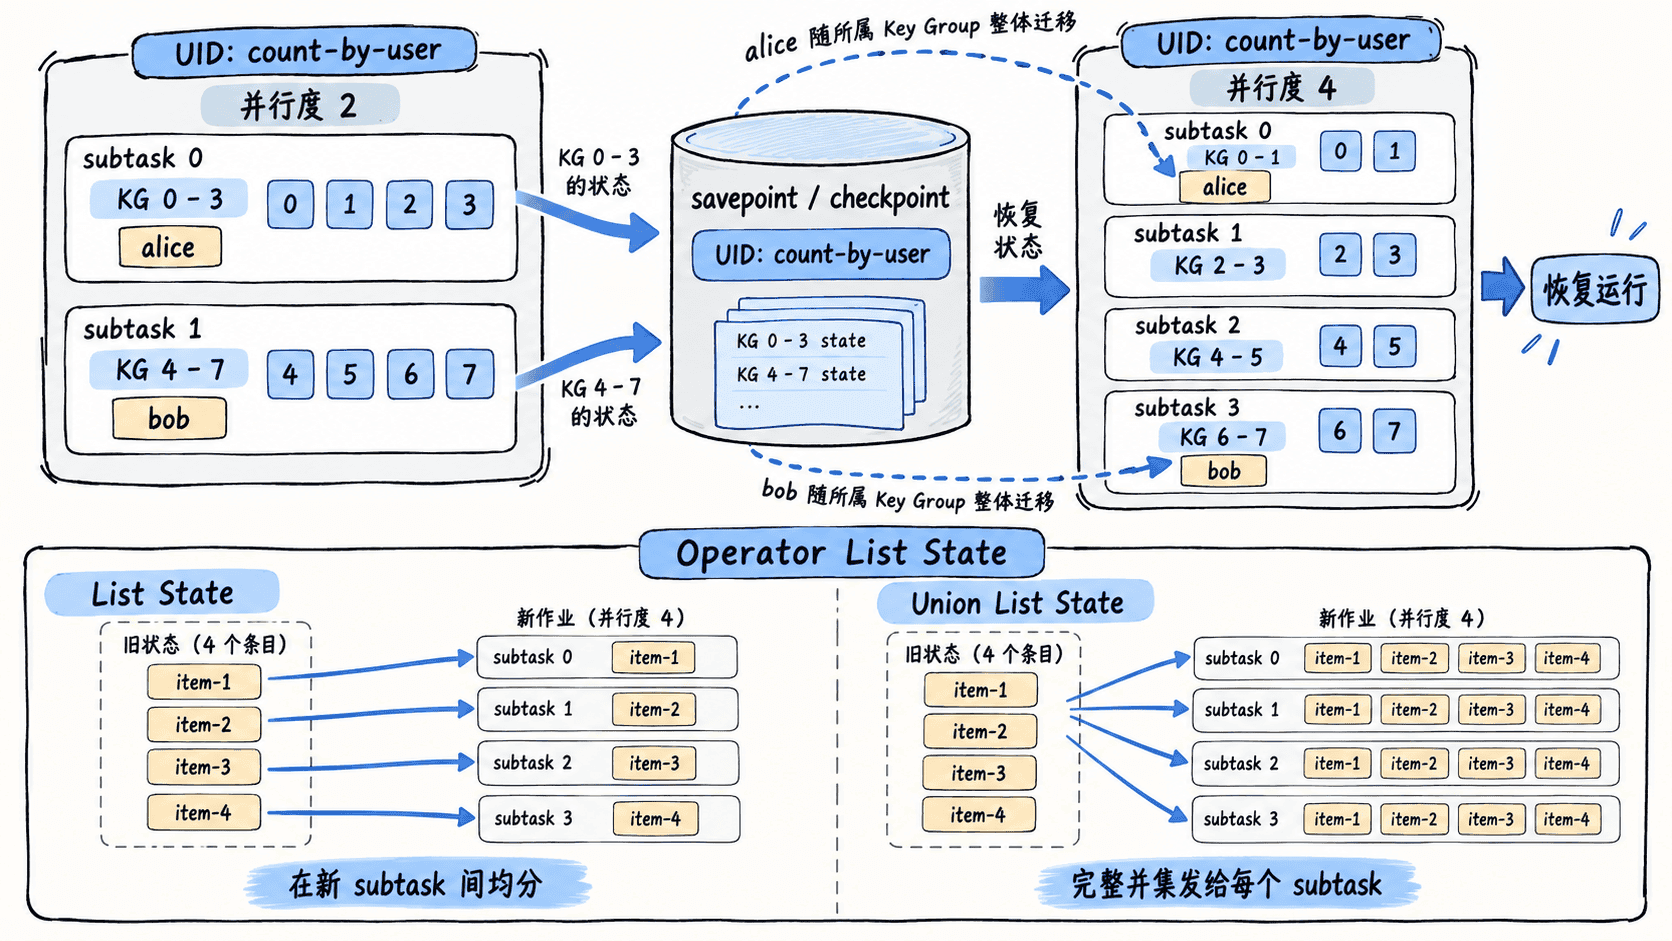
因此,普通扩缩容通常只需要调整运行并行度,而不应把 maxParallelism 当作随手可改的参数。它关系到 Key Group 空间和状态布局;已有状态的作业若确实需要调整,应基于目标 Flink 版本和真实 savepoint 做恢复验证,而不是只验证代码能否启动。
Operator State 的重分配方式不同
Operator State 不按 key 分区,而是绑定到算子的并行实例。使用 ListState 保存 Operator State 时,恢复策略取决于取得状态的方式。通过 getListState() 注册的列表状态会在新并行实例之间重新分摊;通过 getUnionListState() 注册的状态会先合并旧实例的全部条目,再把完整并集提供给每个新实例。
这两种语义不能互换。Kafka 分区分配、文件切片等“每个条目只应由一个实例继续负责”的数据更适合均分;每个实例都必须看到完整配置清单时才适合 union。若把大规模状态误用为 union,扩容后每个 subtask 都要恢复全量副本,恢复时间和内存占用会同步放大。
用 savepoint 验证扩缩容
发布前应从真实运行版本生成 savepoint,再用新并行度恢复,而不是只在空状态下启动新包。下面的命令把动态作业 ID、目录和 savepoint 路径留作占位,实际值可能不同。
bin/flink savepoint <JOB_ID> <SAVEPOINT_DIR>
bin/flink run -s <SAVEPOINT_PATH> -p 4 <PATH>/job.jar
预期结果
Savepoint completed. Path: <SAVEPOINT_PATH>
Job has been submitted with JobID <ID>
恢复后还应核对 keyed 计数、消费位点或业务状态是否连续,并检查是否出现“找不到旧 Operator ID”或未恢复状态的告警。稳定 UID 解决的是新旧逻辑算子的身份匹配;Key Group 与 Operator State 的再分配,才负责把已经匹配到的状态安全交给新的并行实例。