
大数据与流处理 / 系统课时
排查 Checkpoint 变慢与失败
排查 Checkpoint 变慢与失败
这一课给出一条固定排障顺序:先区分“完成但变慢”和“直接失败”,再依次检查反压、状态体积、存储吞吐、超时与并发快照。最终目标不是把 timeout 调大,而是找到哪个阶段真正拖住了 checkpoint。
学习目标
- 能根据 Checkpoint 详情和运行指标区分屏障传播慢、状态快照慢与持久化慢。
- 能按反压、状态体积、存储吞吐、超时配置和并发快照的顺序缩小根因范围。
- 能把修复动作与验证指标一一对应,避免用容错配置掩盖持续故障。
先把“慢”和“失败”分开
如果 checkpoint 最终是 COMPLETED,先比较端到端耗时相对历史基线增长了多少;如果是 FAILED,先打开失败详情确认是超时、I/O 异常、任务失败还是其他拒绝原因。两类现象可以共享根因,但排查入口不同:慢要拆时间花在哪,失败要先抓住失败原因,再用耗时与资源指标解释它。
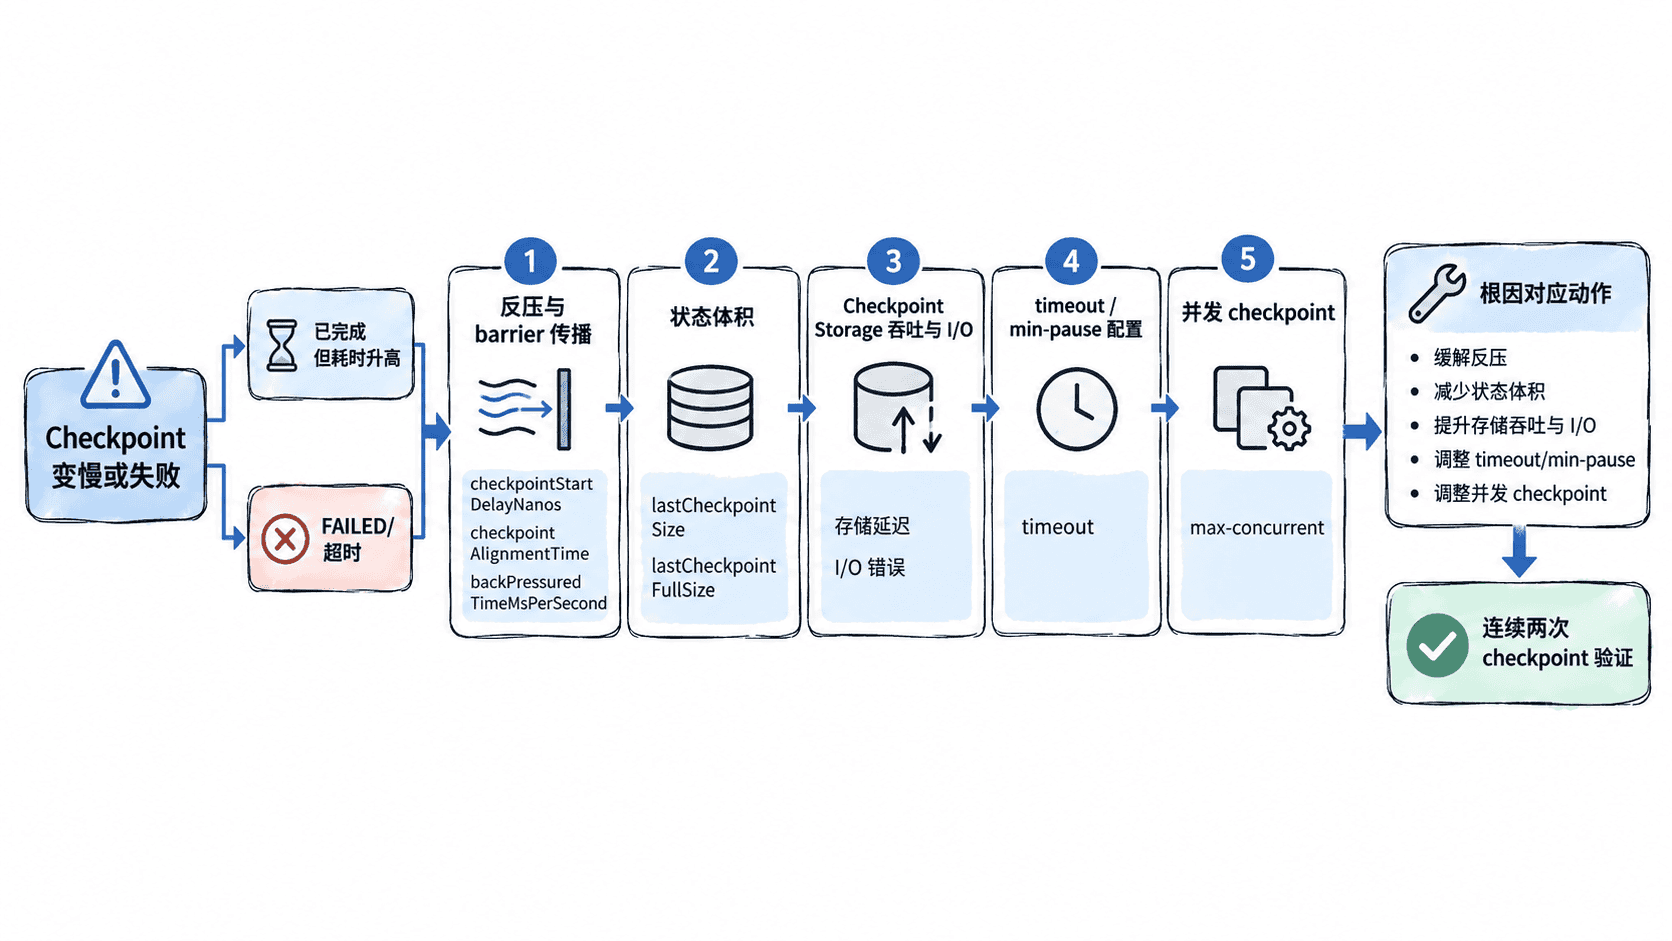
这条顺序的价值在于避免“看到 timeout 就先加 timeout”。如果 barrier 迟迟到不了下游,或者状态文件上传速度已经饱和,单纯放宽超时只会让失败更晚发生,并不能消除瓶颈。
按信号定位第一处瓶颈
先查反压。checkpointStartDelayNanos 很高,说明 checkpoint 创建后 barrier 很久才到达某个 task;checkpointAlignmentTime 很高,则说明多输入 task 在等待较慢输入的 barrier。若这些值和 backPressuredTimeMsPerSecond 同时升高,应优先定位造成反压的算子、数据倾斜或外部 Sink,而不是先调整状态后端。Flink 官方也把高 start delay 与 alignment time 作为反压下 checkpoint 传播受阻的重要信号。([Apache Nightlies][1])
再查状态体积。若 lastCheckpointFullSize 持续增长,同时 checkpoint 耗时同步上升,通常要继续检查 key 基数、无界状态、TTL 是否真正生效,以及当前 backend 是否适合大状态。启用增量 checkpoint 后,要同时看本次增量大小和完整状态大小,因为两者回答的是不同问题。([Apache Nightlies][2])
随后查存储吞吐。屏障已经快速到达,但各 subtask 长时间不能完成 acknowledgement,且 JobManager/TaskManager 日志出现对象存储、HDFS 或文件系统 I/O 延迟与异常时,瓶颈更可能在 checkpoint storage。此时应查看存储端吞吐、请求延迟、网络带宽和限流,而不是把责任归到 barrier alignment。
最后再看配置与并发。execution.checkpointing.timeout 只是 checkpoint 的最大允许时长;max_concurrent 过高可能让多个快照同时争用磁盘、网络和远端存储。若决定使用 unaligned checkpoint 缓解持续反压,应先确认作业是 exactly-once,并注意当前配置要求最大并发 checkpoint 为 1;unaligned 会把 in-flight 数据纳入 checkpoint,因此当真正瓶颈是存储 I/O 时并不一定有利。([Apache Nightlies][4])
拉取当前配置不要靠记忆
排障时先查询正在运行作业实际生效的 checkpoint 配置。下面命令使用 Flink 的 checkpoint config REST 接口;将 <HOST>、<PORT> 和 <JOB_ID> 替换为当前环境实际值。
curl -s "http://<HOST>:<PORT>/jobs/<JOB_ID>/checkpoints/config"预期输出
{
  "interval": <INTERVAL_MS>,
  "timeout": <TIMEOUT_MS>,
  "min_pause": <MIN_PAUSE_MS>,
  "max_concurrent": <COUNT>,
  "tolerable_failed_checkpoints": <COUNT>,
  "unaligned_checkpoints": <BOOLEAN>,
  "aligned_checkpoint_timeout": <ALIGNED_TIMEOUT_MS>,
  ...
}
实际返回还会包含当前版本支持的其他字段,数值也会因作业配置而不同。该接口用于读取运行作业的 checkpoint 配置,适合确认“代码里以为的值”和“实际生效的值”是否一致。([Apache Nightlies][3])
让修复动作和根因一一对应
| 已确认的根因 | 优先动作 | 修复后重点验证 |
|---|---|---|
| 反压导致 barrier 传播慢 | 优化瓶颈算子、处理数据倾斜、扩容;确有需要再评估 unaligned checkpoint | start delay、alignment time 与总耗时同时下降 |
| 状态规模持续膨胀 | 收紧状态生命周期、校验 TTL、减少无界 key 或不必要状态;大状态评估增量 checkpoint | full state size 增速下降,checkpoint 耗时趋稳 |
| checkpoint storage 吞吐不足 | 提升存储/网络吞吐,排查限流与 I/O 错误 | acknowledgement 更快,失败日志消失 |
| timeout 过紧但无其他瓶颈 | 在有基线证据后调整 timeout | checkpoint 能稳定完成,且耗时没有继续恶化 |
| 多个 checkpoint 重叠争用资源 | 降低并发 checkpoint,设置合理 min pause | I/O 峰值降低,单次 checkpoint 更稳定 |
tolerable_failed_checkpoints 可以改变连续失败时作业何时触发故障处理,但它不是修复手段。若失败次数在增长,应该保留失败原因、对应 checkpoint ID 和发生时刻,再验证真正的资源或配置问题是否消失。
修复后至少观察连续两次新的 checkpoint:都应成功完成,并且根因对应的指标同步改善。只有“状态变成 COMPLETED”而 start delay、状态规模或存储延迟仍在恶化,说明问题只是暂时被绕过,还没有真正解决。