
大数据与流处理 / 系统课时
使用聚合型 Keyed State
使用聚合型 Keyed State
当每条事件只是在当前 Key 的历史结果上继续做求和、最大值或平均值时,没有必要手工读取并回写 ValueState。ReducingState 与 AggregatingState 会在 add 时增量聚合,本课用总和与平均值对比两者,并给出选型边界。
学习目标
- 使用
ReducingState对同类型数据做增量归约 - 使用
AggregatingState通过累加器得到不同类型的输出 - 判断聚合型 State 与手工维护
ValueState的适用边界
两种聚合状态的核心差异
ReducingState<T> 接收 T,内部也保留一个 T 类型聚合值,适合求和、最大值、最小值等“输入与结果同类型”的归约。每次 add 都把新值与已有聚合值交给 ReduceFunction。
AggregatingState<IN, OUT> 更灵活:输入类型是 IN,内部真正保存的是 AggregateFunction 定义的累加器 ACC,读取时再通过 getResult 转成 OUT。平均值就是典型例子,因为内部至少要保存 sum 与 count,而最终只输出一个平均数。
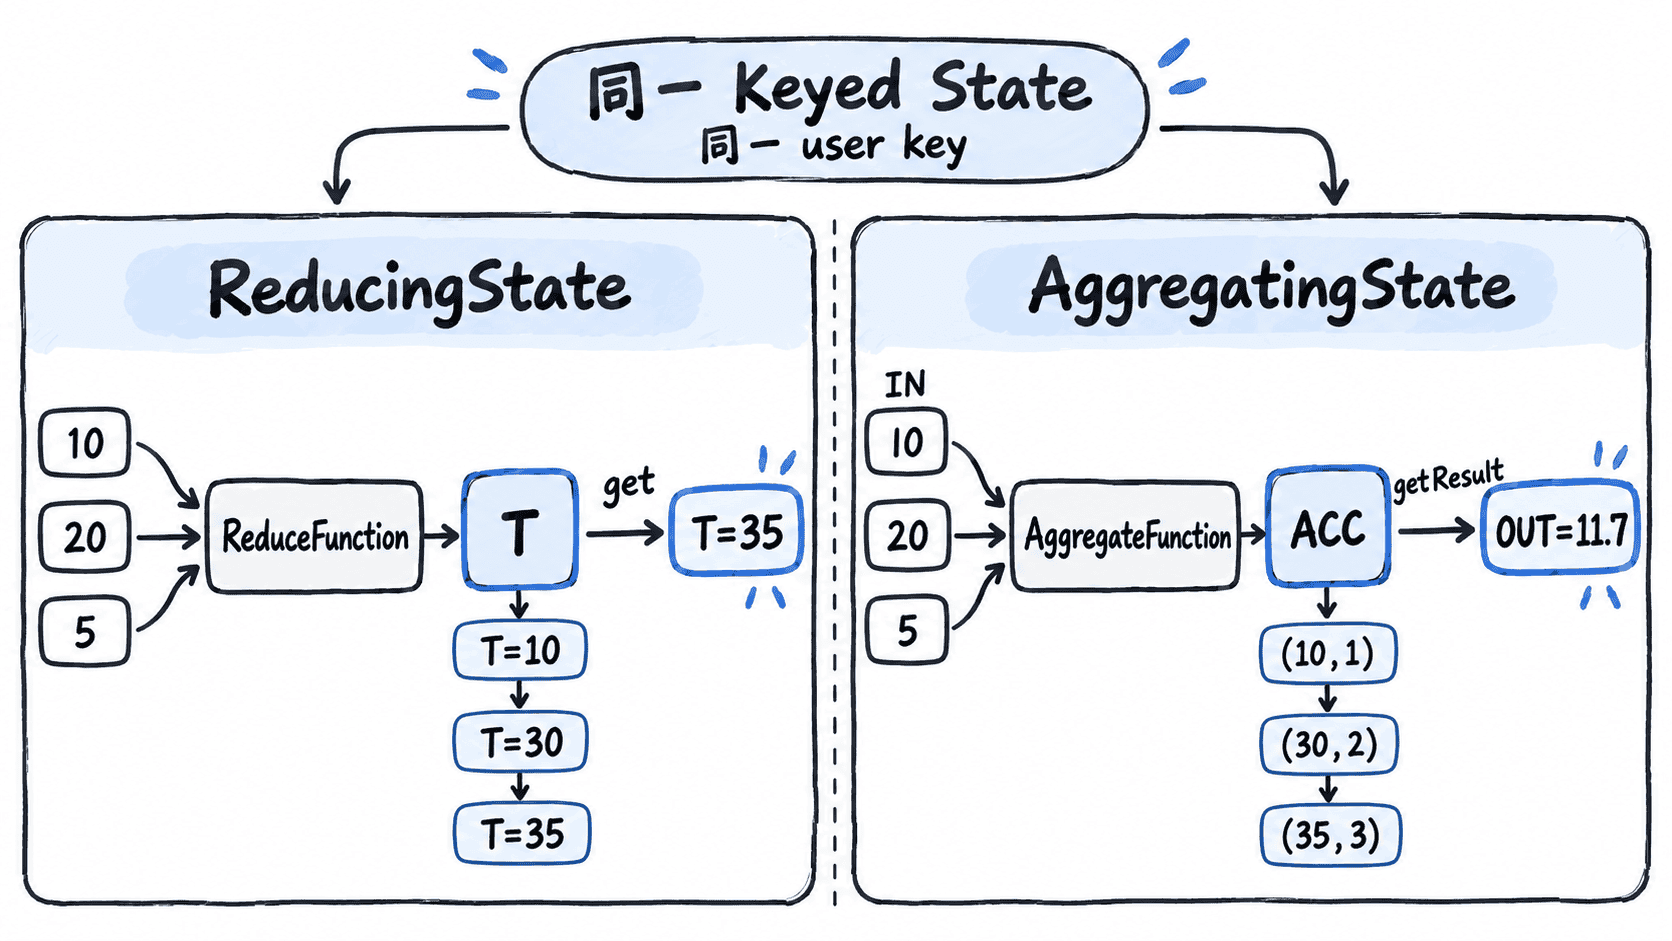
同时计算总和与平均值
下面的完整程序按 userId 分区。ReducingState<Integer> 维护累计金额;AggregatingState<Integer, Double> 接收整数金额,但内部保存 AvgAccumulator,读取时返回 Double 平均值。
import org.apache.flink.api.common.functions.AggregateFunction;
import org.apache.flink.api.common.functions.OpenContext;
import org.apache.flink.api.common.functions.RichFlatMapFunction;
import org.apache.flink.api.common.state.AggregatingState;
import org.apache.flink.api.common.state.AggregatingStateDescriptor;
import org.apache.flink.api.common.state.ReducingState;
import org.apache.flink.api.common.state.ReducingStateDescriptor;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.util.Collector;

import java.util.Locale;

public class AggregatingStateDemo {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        env.fromElements(
                        new Payment("alice", 10),
                        new Payment("alice", 20),
                        new Payment("bob", 7),
                        new Payment("alice", 5))
                .keyBy(payment -> payment.userId)
                .flatMap(new RichFlatMapFunction<Payment, String>() {
                    private transient ReducingState<Integer> total;
                    private transient AggregatingState<Integer, Double> average;

                    @Override
                    public void open(OpenContext openContext) throws Exception {
                        ReducingStateDescriptor<Integer> totalDescriptor =
                                new ReducingStateDescriptor<>(
                                        "total",
                                        (left, right) -> left + right,
                                        Integer.class);

                        AggregatingStateDescriptor<Integer, AvgAccumulator, Double>
                                averageDescriptor =
                                new AggregatingStateDescriptor<>(
                                        "average",
                                        new AverageAggregate(),
                                        AvgAccumulator.class);

                        total = getRuntimeContext()
                                .getReducingState(totalDescriptor);
                        average = getRuntimeContext()
                                .getAggregatingState(averageDescriptor);
                    }

                    @Override
                    public void flatMap(Payment payment, Collector<String> out)
                            throws Exception {
                        total.add(payment.amount);
                        average.add(payment.amount);

                        out.collect(String.format(
                                Locale.ROOT,
                                "%s total=%d avg=%.1f",
                                payment.userId,
                                total.get(),
                                average.get()));
                    }
                })
                .print();

        env.execute("aggregating-state-demo");
    }

    public static class AverageAggregate
            implements AggregateFunction<Integer, AvgAccumulator, Double> {

        @Override
        public AvgAccumulator createAccumulator() {
            return new AvgAccumulator();
        }

        @Override
        public AvgAccumulator add(Integer value, AvgAccumulator acc) {
            acc.sum += value;
            acc.count += 1;
            return acc;
        }

        @Override
        public Double getResult(AvgAccumulator acc) {
            return acc.count == 0 ? 0.0 : (double) acc.sum / acc.count;
        }

        @Override
        public AvgAccumulator merge(
                AvgAccumulator left,
                AvgAccumulator right) {
            left.sum += right.sum;
            left.count += right.count;
            return left;
        }
    }

    public static class AvgAccumulator {
        public long sum;
        public long count;

        public AvgAccumulator() {
        }
    }

    public static class Payment {
        public String userId;
        public int amount;

        public Payment() {
        }

        public Payment(String userId, int amount) {
            this.userId = userId;
            this.amount = amount;
        }
    }
}
预期输出
alice total=10 avg=10.0
alice total=30 avg=15.0
bob total=7 avg=7.0
alice total=35 avg=11.7
Alice 与 Bob 的聚合结果彼此独立,因为两个状态都绑定在 keyBy(payment -> payment.userId) 之后。每次事件只向状态追加一个新值,不需要先把所有历史记录取出来再重新聚合。
在三种状态之间做选择
| 需求 | 更合适的状态 | 原因 |
|---|---|---|
| 求和、最大值等,输入与聚合值同类型 | ReducingState<T> |
归约函数最简单,状态只保留一个 T |
| 平均值、比率、复合统计,内部状态与输出不同 | AggregatingState<IN, OUT> |
可把 ACC 与最终 OUT 分离 |
| 更新逻辑包含替换、条件分支、多个业务阶段 | ValueState<T> |
可以显式读取、判断并整体写回 |
例如平均值若用 ValueState,也可以手工保存 sum 与 count,但聚合规则会散落在处理函数中。AggregatingState 把 createAccumulator、add、getResult 和 merge 集中到一个 AggregateFunction,更适合稳定的增量统计逻辑。
写聚合函数时守住边界
聚合函数应只依赖当前输入和累加器,避免读取外部可变对象或把网络调用放进 add。这样恢复、重放或扩缩容时,状态结果才更容易保持可解释和可重复。
如果业务需要“到某个事件就重置”,可以在处理函数中对当前状态调用 clear,再开始新的聚合周期。若规则要求撤回历史单条记录、按复杂条件修改旧贡献,简单的增量聚合可能不够,此时应改用能表达这些业务语义的状态结构。
聚合型 Keyed State 的价值不只是少写几行代码,而是让“如何累加”成为状态定义的一部分:简单同类型归约用 ReducingState,需要独立累加器与结果投影时用 AggregatingState。