
大数据与流处理 / 系统课时
理解增量 Checkpoint 取舍
理解增量 Checkpoint 取舍
RocksDB 增量 Checkpoint 的价值不只是“每次少传一点数据”。真正需要权衡的是新生成 SST 的上传量、跨 Checkpoint 共享文件、故障恢复读取量,以及旧快照删除时的引用关系。理解这些关系后,才能判断它是否真的改善了大状态作业。
学习目标
- 解释 RocksDB 增量 Checkpoint 如何复用已经上传的 SST 文件
- 区分增量上传、完整逻辑状态与恢复依赖,避免把它理解成日志链
- 根据写放大、恢复速度和存储保留策略判断是否适合开启增量快照
增量保存的不是半份状态
RocksDB 会把键控状态组织成 SST 文件。首次可用的增量 Checkpoint 通常需要上传当前状态涉及的文件;后续 Checkpoint 如果仍引用相同 SST,就可以复用远端已有文件,只上传新生成或被压实后替换的 SST 以及新的元数据。
因此,“增量”描述的是本次新增上传的数据量,不是说某个 Checkpoint 只代表一部分状态。任意一个成功 Checkpoint 的元数据,都必须能够描述恢复该时刻完整状态所需的文件集合。
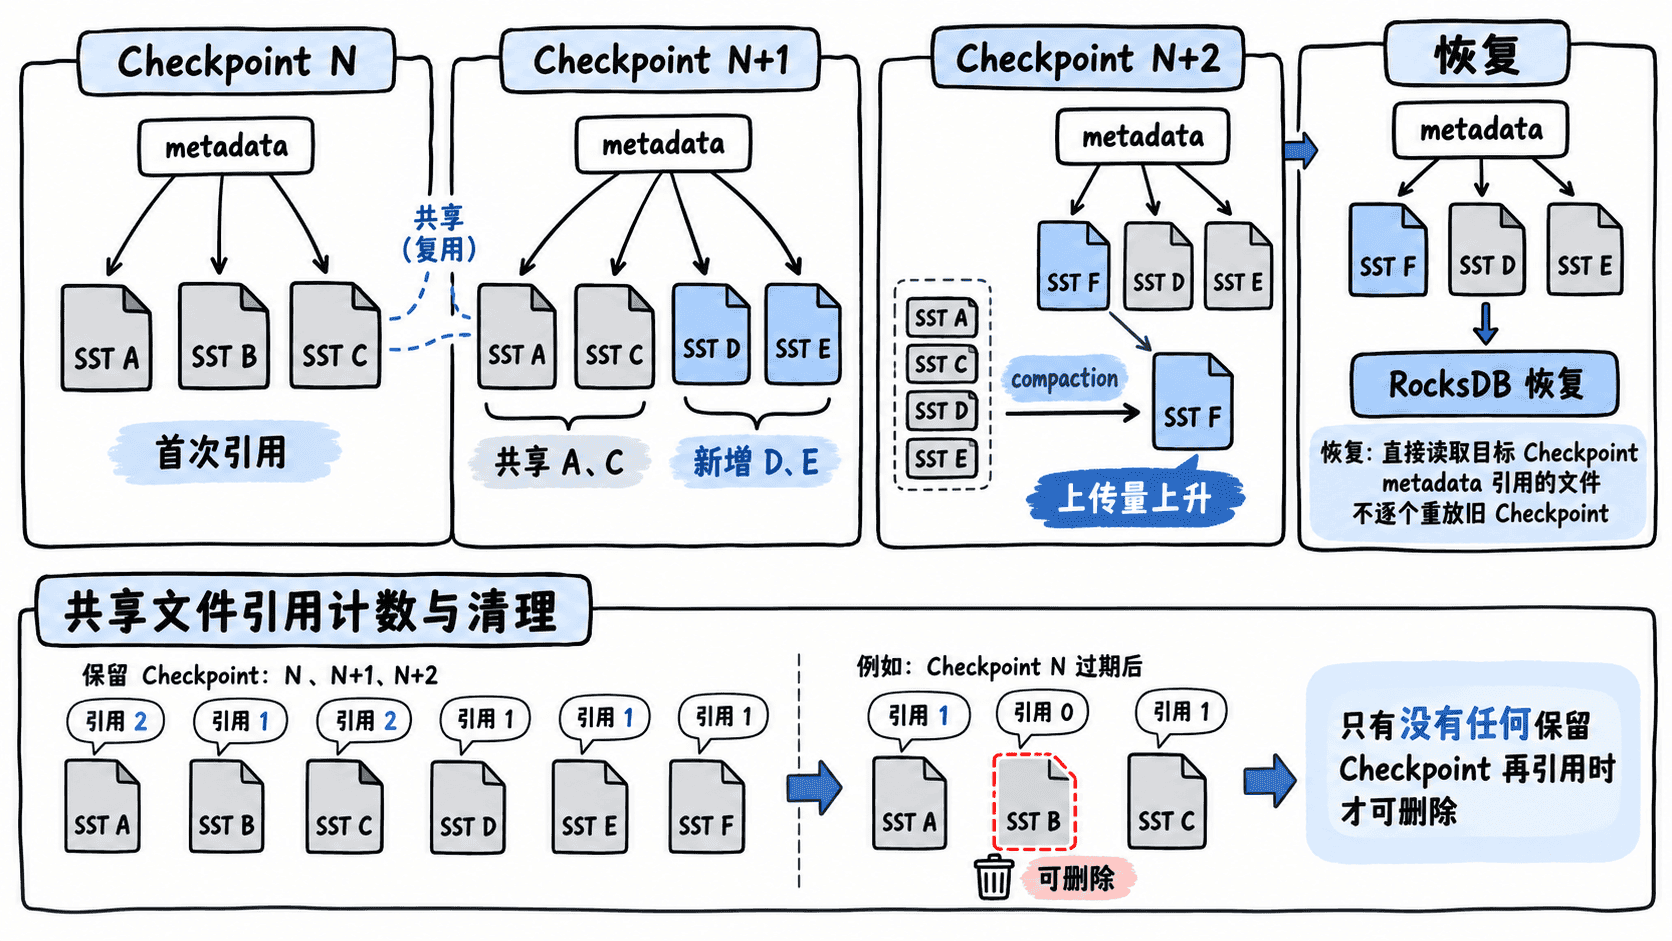
上传量会随 compaction 波动
如果工作集稳定、很多 SST 在相邻 Checkpoint 之间保持不变,增量快照能显著减少远端写入量和 Checkpoint 持续时间。相反,持续更新热点键、频繁 compaction 或大范围 TTL 清理都可能产生大量新 SST,使某一次增量 Checkpoint 接近重新上传大批状态文件。
所以不要只看“状态总量”。更有意义的是连续观察多次已完成 Checkpoint 的新增上传字节、持续时间和失败率,并把尖峰与 RocksDB compaction、写入速率及状态过期行为对齐。增量快照优化的是常态成本,不保证每次快照都很小。
恢复不是逐个重放旧 Checkpoint
一个常见误解是:增量 Checkpoint 越多,恢复时就要从第一个快照开始逐个重放。RocksDB 增量快照不是这种日志重放模型。恢复某个 Checkpoint 时,Flink 根据该 Checkpoint 的元数据定位它引用的共享与私有状态文件,再恢复出该时刻的完整 RocksDB 状态。
这也解释了另一个取舍:上传量变小,不代表恢复读取量同样按比例变小。大状态作业在恢复时仍可能需要读取大量被共享的 SST,恢复速度还受远端存储吞吐、并行度、本地缓存以及文件数量影响。
共享文件会延后真正删除
共享 SST 可能同时被多个已保留 Checkpoint 引用。旧 Checkpoint 被丢弃时,不能简单删除它曾使用的全部文件;只有当某个共享文件不再被任何保留快照引用时,状态存储才能安全回收它。
这意味着保留更多外部化 Checkpoint 会提高可回退能力,但也可能让共享文件存活更久。容量规划应同时考虑状态增长速度、Checkpoints 保留数量、失败恢复窗口和对象存储清理延迟,而不是按“单次增量大小 × 保留次数”做线性估算。
开启后要验证是否真的受益
下面是片段示例,假设现有作业已经创建 StreamExecutionEnvironment。EmbeddedRocksDBStateBackend(true) 表示启用 RocksDB 增量 Checkpoint,检查点仍应写入具备持久性的存储;示例中的本地路径只适合开发验证。
import org.apache.flink.contrib.streaming.state.EmbeddedRocksDBStateBackend;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

env.enableCheckpointing(30_000);
env.setStateBackend(new EmbeddedRocksDBStateBackend(true));
env.getCheckpointConfig()
        .setCheckpointStorage("file:///tmp/flink-checkpoints");
生效后不要只确认配置“能启动”。应先让作业稳定运行多个 Checkpoint,再比较连续快照的新增上传量与总状态规模;随后制造一次可恢复故障,确认恢复时长仍在目标范围内。如果上传量长期接近完整状态大小,或恢复被海量小文件拖慢,增量 Checkpoint 就未必是当前负载下的最佳选择。