
大数据与流处理 / 系统课时
认识有状态 DataStream 作业
认识有状态 DataStream 作业
DataStream 一旦需要“记住之前发生过什么”,就进入有状态计算:计数、去重、窗口聚合、规则匹配都依赖状态。本课建立最小心智模型,区分无状态转换、托管状态与检查点,并说明故障后怎样恢复到一致结果。
学习目标
- 判断一个 DataStream 算子是否需要保存跨记录信息
- 理解托管状态、检查点与故障恢复之间的关系
- 区分算子状态与外部系统数据,明确 Flink 能恢复什么
从无状态到有状态
无状态算子只根据当前输入产生当前输出。例如把字符串转成大写,处理第 100 条记录时不需要知道前 99 条发生了什么。这样的算子即使失败重启,只要重新读取输入,就能再次计算结果。
有状态算子不同。按用户累计点击次数时,处理 alice 的新事件必须知道她此前已经出现多少次;做去重时,也要记住哪些业务 ID 已经见过。这个“跨记录保留的信息”就是状态。状态是否正确,直接决定输出是否正确。
Flink 为什么要托管状态
如果把计数放进普通 Java 字段,字段虽然能在进程存活期间保存值,却无法自动参与分区、持久化和恢复。并行度变化后,哪些键应该把状态搬到哪个并行实例,也需要额外处理。
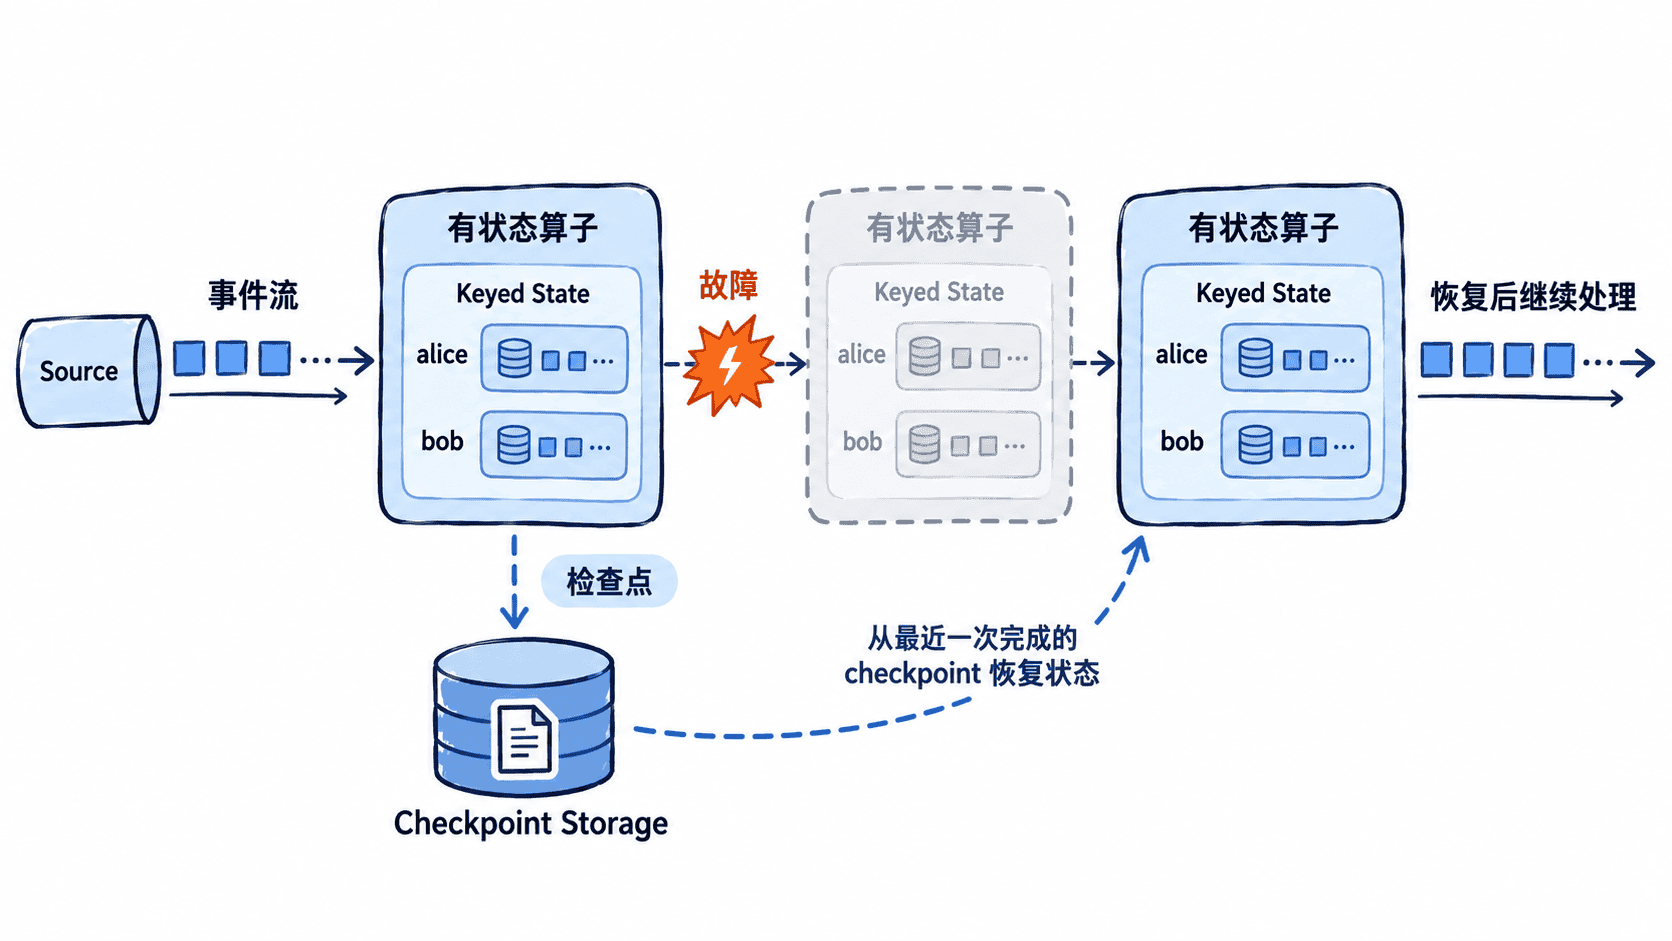
Flink 的托管状态把这些职责交给运行时。典型的 Keyed State 会跟随 key 的分区归属存放在对应并行实例中;Flink 负责状态访问、快照和重新分配。开发者关注“保存什么”,运行时负责“怎样可靠保存和恢复”。
检查点保存的是一致处理位置
状态本身只是内存或状态后端中的当前值。为了让失败后的结果仍然正确,Flink 需要周期性生成 checkpoint,把各个有状态算子的快照与输入处理进度组合成一个可恢复的一致点。
例如某次完成的 checkpoint 记录了 alice=7,并且输入源的恢复位置也对应“前七次相关事件已经纳入计算”。失败后若只恢复状态、不恢复输入位置,就可能漏算;只重放输入、不恢复状态,又可能重复累计。容错依赖两者协同,而不是单独保存一个计数值。
故障恢复的目标
发生 TaskManager、算子实例或进程故障时,Flink 会让相关任务重新启动,并从最近一次成功完成的 checkpoint 恢复托管状态。可恢复输入源还会回到与该 checkpoint 对齐的位置,然后重新处理之后的数据。
这不意味着所有外部副作用都会自动回滚。写数据库、调用 HTTP 接口、发送消息等动作位于 Flink 状态之外,是否能与 checkpoint 保持一致,要看连接器是否支持事务、幂等或两阶段提交等机制。托管状态可恢复与端到端恰好一次不是同一个概念。
先建立正确的排查边界
遇到恢复后结果异常时,可以先按三层边界定位:状态是否真的由 Flink 托管,checkpoint 是否成功完成,外部系统写入是否具备与 checkpoint 对齐的语义。只要其中一层不成立,就不能仅凭“开启了 checkpoint”推断结果一定正确。
后续编写状态代码时,应优先使用 Flink 提供的状态抽象,并把“状态、输入位置、外部副作用”作为三个独立对象检查。这样才能判断一个有状态 DataStream 作业在失败前后是否保持了同一份业务事实。