
大数据与流处理 / 系统课时
排查状态膨胀与恢复失败
排查状态膨胀与恢复失败
有状态作业最棘手的两类问题,一类是状态持续变大,最终拖慢 Checkpoint 和恢复;另一类是已有 Checkpoint 或 Savepoint 无法 Restore。本课用一条固定诊断链,把 TTL、热点 key、序列化兼容、UID 映射和缺失状态逐项排除。
学习目标
- 根据 Checkpoint 体积、耗时和 key 分布判断状态膨胀的主要来源。
- 区分 TTL 未生效、热点 key、序列化不兼容和 UID 变化造成的不同故障。
- 用稳定 UID 和受控 Restore 验证修复结果,避免带病恢复。
先把现象分成状态增长与恢复失败
状态膨胀先看趋势,不要只看某一次 Checkpoint 的绝对大小。若已完成 Checkpoint 的体积、持续时间和后端本地状态占用同步上升,说明作业正在积累更多有效状态,或过期状态没有及时完成物理清理。若只有单个 subtask 明显更大,则优先怀疑 key 倾斜。
Restore 失败则先固定“恢复源”和“当前作业图”:记录使用的 Checkpoint 或 Savepoint 路径、作业版本、并行度、算子 UID,以及最近一次状态数据结构改动。这样才能判断问题来自状态内容,还是来自新旧作业图无法建立映射。
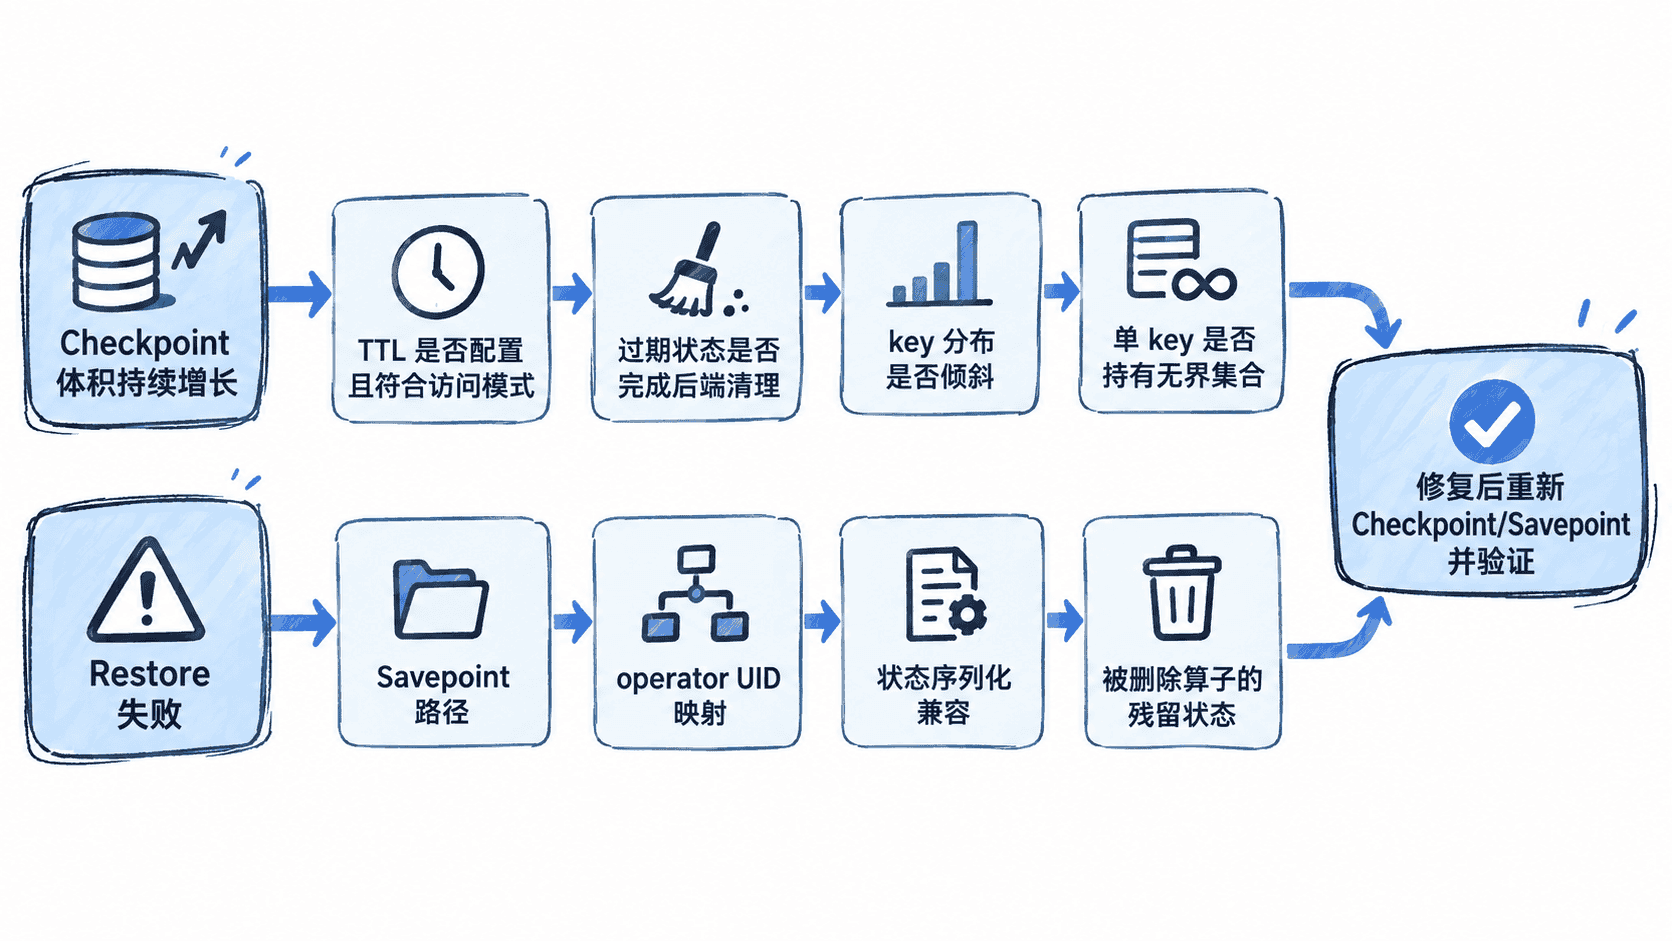
排查状态为何持续增长
TTL 的第一个检查点不是“配没配”,而是“刷新条件是否符合业务”。下面的片段示例给 keyed ValueState 配置两小时 TTL,并只在创建和写入时刷新过期时间。它依赖一个运行在 keyed stream 上的 ValueStateDescriptor。
StateTtlConfig ttlConfig = StateTtlConfig
        .newBuilder(Duration.ofHours(2))
        .setUpdateType(StateTtlConfig.UpdateType.OnCreateAndWrite)
        .setStateVisibility(StateTtlConfig.StateVisibility.NeverReturnExpired)
        .build();

ValueStateDescriptor<Long> descriptor =
        new ValueStateDescriptor<>("order-count", Long.class);
descriptor.enableTimeToLive(ttlConfig);

ValueState<Long> orderCount =
        getRuntimeContext().getState(descriptor);
这段配置的生效行为是:状态超过 TTL 后不再对业务代码可见,但“逻辑过期”不等于存储字节立刻下降。不同 State Backend 的物理清理时机不同,因此验证时要同时观察业务读取结果和连续多轮 Checkpoint 的体积趋势,不能看到 TTL 就直接排除膨胀问题。
如果只有少数 subtask 变大,再检查 key 分布。常见根因包括低基数字段作为 key、某个租户或设备流量远高于其他 key,以及单个 key 内保存不断追加的 ListState、MapState。这类问题即使配置 TTL,也可能在过期窗口内形成很大的瞬时状态。
排查 Restore 为什么失败
Restore 的关键是“新作业中的算子能否找到旧状态,并用兼容的序列化方式读出来”。最常见的四类证据如下。
| 现象 | 优先检查 | 处理方向 |
|---|---|---|
| 提示存在无法映射的 operator state | 算子 UID 是否变化或算子被删除 | 恢复原 UID;确认状态确实废弃后再考虑忽略未恢复状态 |
| 提示 serializer/schema incompatible | 状态类型、字段、Serializer 是否变更 | 使用兼容迁移方案,不要直接覆盖原状态定义 |
| 某些 key 恢复后像“丢失” | 是否恢复了错误的 Savepoint、UID 是否映射到错误算子 | 对照作业版本、路径和 UID 清单 |
| 扩缩容后恢复失败 | keyed 算子的 maxParallelism 是否被破坏性修改 |
保持可兼容的 max parallelism,再做并行度调整 |
对长期存在的有状态算子,应显式设置稳定 UID,而不是依赖框架根据拓扑自动生成标识。算子名称可以调整,UID 则应当视为状态恢复协议的一部分。
DataStream<String> result = input
        .keyBy(Event::userId)
        .process(new StatefulProcessor())
        .name("user-aggregate")
        .uid("user-aggregate-v1");
上面是片段示例,依赖已经存在的 input、Event 和 StatefulProcessor。验证方法不是看编译是否通过,而是从同一个 Savepoint 启动新版本,并确认该算子能够接回原状态。
用受控恢复验证修复
修复 UID 或序列化问题后,先用明确的 Savepoint 路径做一次受控启动,不要同时改并行度、状态结构和业务逻辑。下面的命令假设已经存在可提交的作业 JAR,并把动态路径放进变量。
FLINK_HOME="<PATH>"
JOB_JAR="<PATH>/stateful-job.jar"
SAVEPOINT_PATH="<PATH>/savepoint-<ID>"

"$FLINK_HOME/bin/flink" run -d -s "$SAVEPOINT_PATH" -c com.example.StatefulJob "$JOB_JAR"
预期输出
Job has been submitted with JobID <ID><PATH> 和 <ID> 会随环境变化。若仍失败,应回到同一份 Savepoint 和同一版作业图继续定位,不要不断生成新的恢复源。只有在确认某个旧算子的状态已经永久废弃时,才考虑 --allowNonRestoredState;它会跳过无法映射的状态,不能用来掩盖 UID 配错或状态误删。
最终验收至少要同时满足三件事:连续多轮 Checkpoint 体积趋于稳定;从指定 Savepoint 能成功启动;恢复后抽查几个已知 key 的聚合值与故障前一致。这样才能证明“作业跑起来了”同时也是“状态恢复正确了”。