
大数据与流处理 / 系统课时
理解 Barrier 与一致性快照
理解 Barrier 与一致性快照
Checkpoint 的关键并不是“定时把内存复制一份”,而是让分布式数据流在没有全局停机的情况下,记录同一逻辑时刻的 source position 与算子状态。本课沿着 Barrier 的传播路径理解一致快照如何形成,以及恢复时为什么能够从同一个检查点继续处理。
学习目标
- 说明 Checkpoint Barrier 如何划分检查点之前和之后的数据。
- 理解多输入算子的 Barrier 对齐与状态快照关系。
- 判断 Flink 状态一致性与端到端 Exactly-Once 的边界。
Barrier 标记逻辑切面
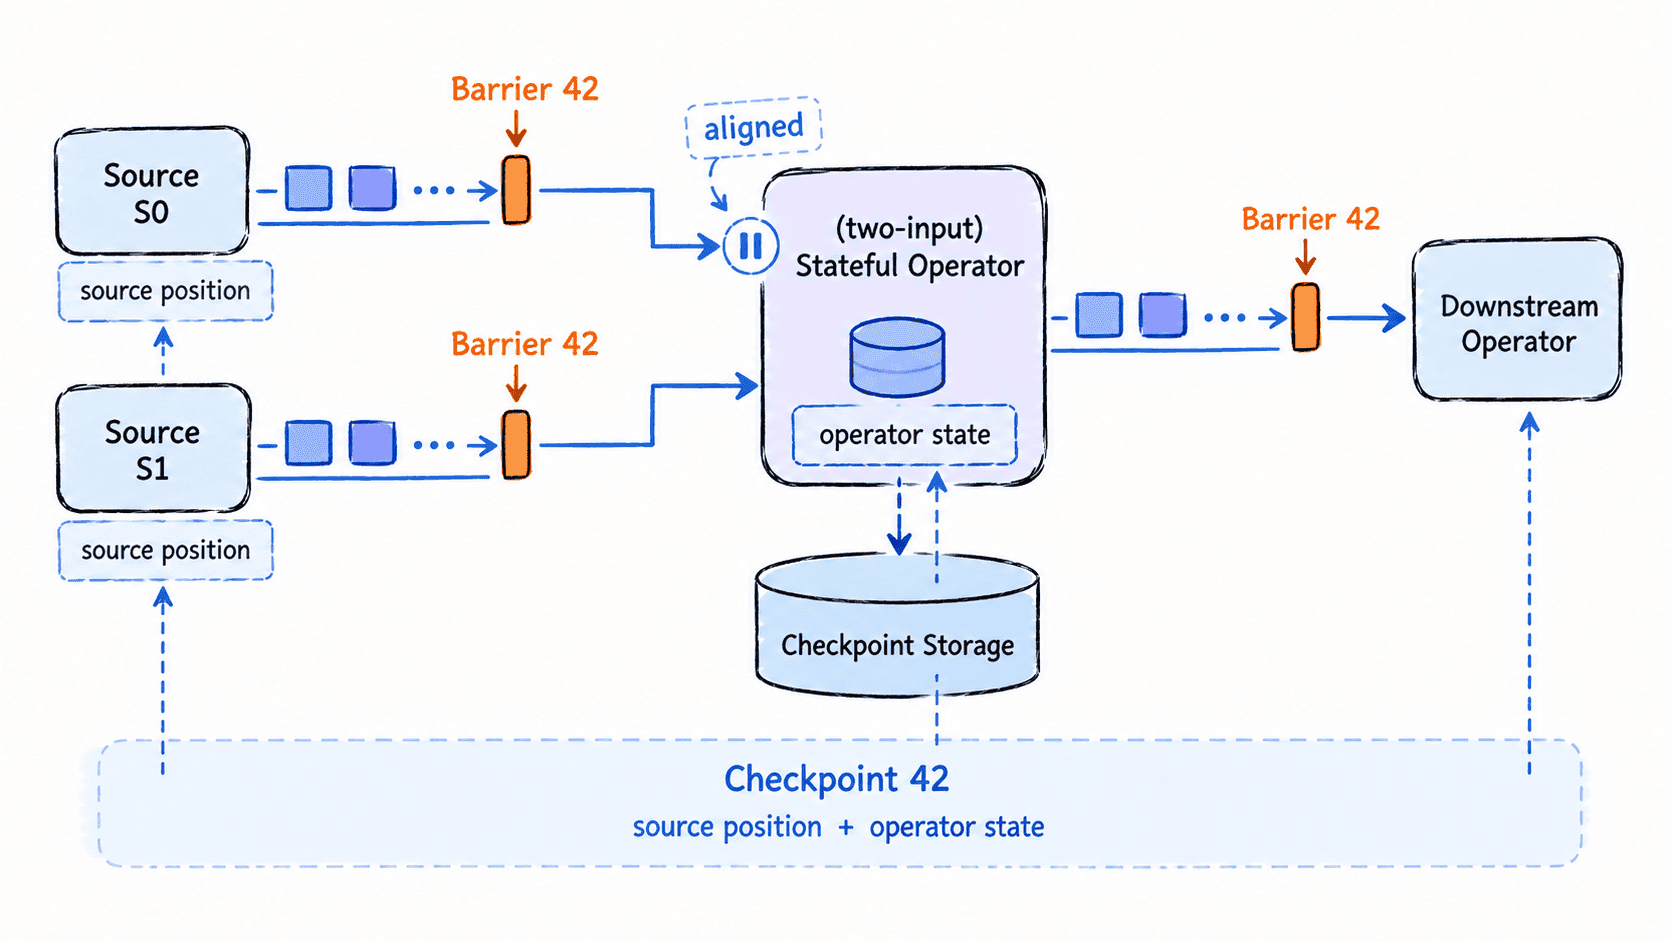
JobManager 中的 Checkpoint Coordinator 发起一次检查点后,Source 会为这次检查点记录可恢复的位置,并向输出数据流插入带编号的 Checkpoint Barrier。Barrier 不会替代业务记录,它与记录一起沿数据流向下游传播。
假设 Barrier 42 出现在两条记录之间,那么它表达的是一个逻辑边界:Barrier 之前的记录属于检查点 42 已经观察到的数据,Barrier 之后的记录属于该逻辑切面之后的数据。恢复时,Source position 必须与算子在同一个检查点编号下保存的状态配套使用。
多输入算子为什么要对齐
单输入算子收到 Barrier 后,可以直接在这个边界附近完成本次状态快照。多输入算子更麻烦:同一个检查点的 Barrier 可能以不同速度到达各个输入。如果算子在第一条输入的 Barrier 到达后仍继续消费该输入的新数据,同时另一条输入还停留在 Barrier 之前,就可能把两个逻辑时刻的数据混入同一份状态。
默认的 aligned checkpoint 会解决这个问题。当 Barrier 42 先从输入 A 到达时,算子暂时停止继续消费 A 中 Barrier 之后的数据,但仍处理输入 B,直到 B 的 Barrier 42 也到达。此时所有输入都跨过了同一个逻辑边界,算子才能为检查点 42 保存状态并继续处理后续记录。
Flink 还支持 unaligned checkpoint。它主要用于降低反压场景下的对齐等待,会把部分在途数据纳入检查点,因此快照内容和开销与 aligned checkpoint 不同。理解基础一致性模型时,应先掌握默认对齐模式,再决定是否需要启用 unaligned checkpoint。
快照里必须同时保存什么
一次可恢复的 Checkpoint 至少要让数据位置与状态属于同一个检查点编号。对 Source 来说,关键是能够恢复消费位置;对有状态算子来说,关键是恢复 Keyed State、Operator State 等托管状态。多个 Task 的快照完成后,Coordinator 才会把这次 Checkpoint 视为成功完成。
发生故障后,作业从某个已完成 Checkpoint 恢复:Source 回到该检查点记录的位置,算子恢复对应状态,然后继续处理后续数据。如果只恢复算子状态而不恢复 Source position,可能重新处理过多数据;如果只恢复 Source position 而没有匹配的算子状态,则状态与输入进度会脱节。
一致快照不等于端到端 Exactly-Once
Barrier 和状态快照解决的是 Flink 作业内状态与输入进度的一致恢复问题。最终外部结果是否仍然 Exactly-Once,还取决于 Sink 能否和检查点协议协作。例如事务型 Sink 可以在检查点成功后提交对应事务;只做普通外部写入且没有事务或幂等保证的 Sink,在故障恢复后仍可能出现重复结果。
因此判断一致性时,应把问题拆成两层:先确认 Source position 与 operator state 能否在同一个 Checkpoint 中一致恢复,再检查 Sink 是否提供与所需语义匹配的提交机制。Barrier 提供的是分布式快照的逻辑边界,而完整的端到端语义必须由 Source、状态恢复与 Sink 共同成立。