
大数据与流处理 / 系统课时
理解状态快照与恢复链路
理解状态快照与恢复链路
有状态作业发生故障后,并不是把内存里的状态原样“接回来”。Flink 依赖已完成的 checkpoint,同时恢复算子状态和输入位置,再从该位置继续消费,才能把故障前后的计算接成一条一致的处理链。
学习目标
- 串起工作状态、输入位置、checkpoint、故障重启与恢复的因果关系
- 说明一致性快照为什么必须覆盖同一逻辑时刻的状态和输入进度
- 判断故障后哪些数据会重放,以及外部输出为什么还需要配合一致性语义
运行中的状态不是恢复点
作业正常运行时,算子会持续修改工作状态,例如累计计数、窗口内容或定时器。与此同时,Source 也在不断推进输入位置。内存中的“当前值”只代表此刻正在运行的状态;一旦进程或机器故障,这些内存内容可能全部丢失。
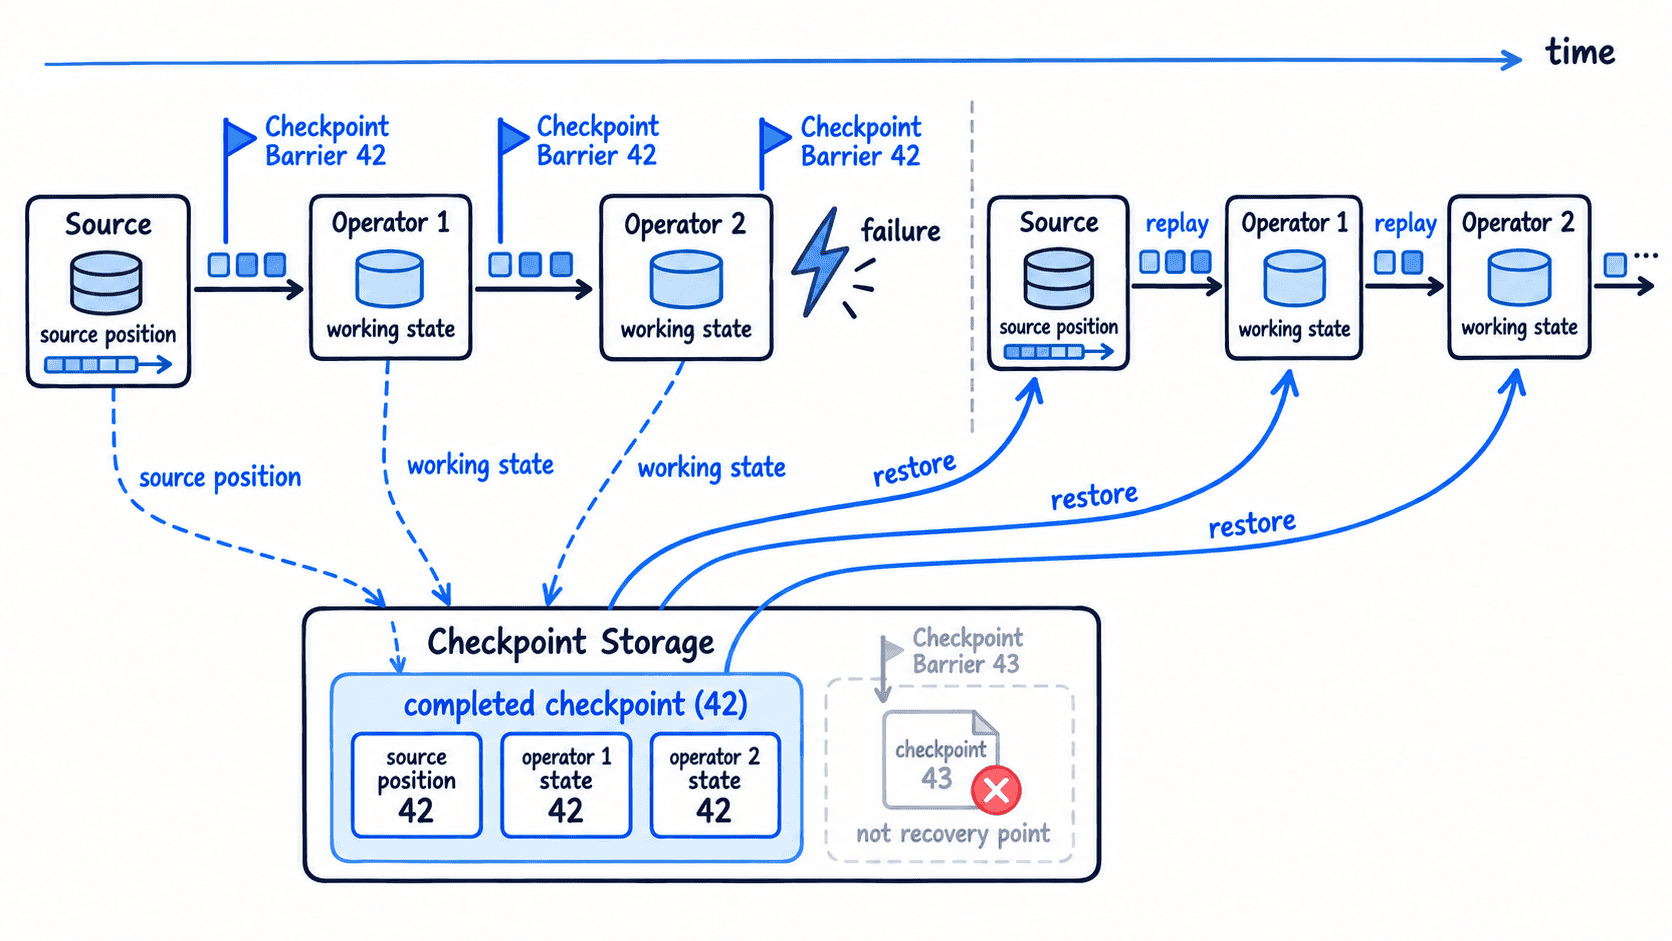
checkpoint 的作用是周期性把某个一致切面持久化下来。这个切面不仅包含算子的状态快照,还要能确定 Source 对应的输入位置。只有两者匹配,恢复后才能知道“状态已经计算到哪里”以及“接下来应从哪里继续读”。
一致快照怎样形成
checkpoint 触发后,Source 会把 checkpoint barrier 注入数据流。barrier 随记录向下游传播,算子据此协调本次快照边界,并把属于该 checkpoint 的状态持久化到 checkpoint storage。对于有多个输入的算子,运行时还要确保快照对应一个一致的输入切面。
因此,一个“已完成 checkpoint”可以理解为一组能够一起恢复的元数据和状态:Source 位置、各有状态算子的快照,以及运行时完成该 checkpoint 所需的信息。只有当整个 checkpoint 成功完成,它才会成为可靠恢复点;中途失败或未完成的 checkpoint 不应被当作恢复依据。
故障后为什么要重放
假设最近完成的 checkpoint 记录 Source 已处理到位置 100,算子状态也对应位置 100 之前的输入。之后作业继续处理到位置 130,但在下一次 checkpoint 完成前发生故障,那么恢复时会回到位置 100 对应的状态。
重启后,Source 从 checkpoint 记录的位置继续读取,因此 101 到 130 这段数据可能再次进入算子。因为算子状态也一起回退到了同一个 checkpoint,这些记录对状态来说并不是“重复计算旧结果”,而是在恢复丢失的那段计算进度。
这就是状态与输入位置必须成对恢复的原因。如果只恢复状态、不回退输入位置,会漏算;如果只回退输入位置、却保留故障前更靠后的状态,则可能把同一批记录重复计入状态。
Exactly-once 还需要哪些条件
Flink 内部的 checkpoint 可以让状态恢复到一致切面,但端到端 exactly-once 还取决于 Source 和 Sink 的能力。Source 需要能够从已保存的位置重放;Sink 如果把结果写到外部系统,也必须以事务、两阶段提交、幂等写入或其他兼容机制处理恢复期间的重放。
因此,不能把“checkpoint 成功”直接等同于“所有外部副作用天然不会重复”。例如算子在 checkpoint 之后调用一个普通 HTTP 接口,接口已经产生副作用,但作业随后失败并从旧 checkpoint 重放,这次调用可能再次发生。
用一条因果链检查恢复设计
排查恢复问题时,可以按顺序确认:最近成功完成的是哪个 checkpoint,Source 保存了什么输入位置,算子从哪个状态快照恢复,恢复后哪些记录会重放,Sink 是否能正确处理这些重放。任意一环不匹配,都可能表现为漏数据、重复结果或状态跳变。
完整链路可以压缩成一句话:运行时持续更新工作状态 → checkpoint 固化一致的状态与输入位置 → 故障后回到最近完成的 checkpoint → Source 从对应位置重放 → 算子基于恢复后的状态继续计算。理解这条链,后续分析 checkpoint 配置、状态后端和端到端一致性都会更直接。