
大数据与流处理 / 系统课时
让定时器随状态一致恢复
让定时器随状态一致恢复
在有状态流处理中,超时判断不能只保存业务状态,还要保存“何时触发”的定时信息。本课用 KeyedProcessFunction 实现每个 key 在 5 秒无新事件后超时,并说明 checkpoint 如何让状态与定时器一起恢复。
学习目标
- 使用事件时间或处理时间定时器驱动按 key 的延迟逻辑。
- 理解定时器与 Keyed State 一同快照、故障恢复后的触发语义。
- 避免重复定时器、过期定时器与状态清理不同步。
把状态和定时器视为同一恢复单元
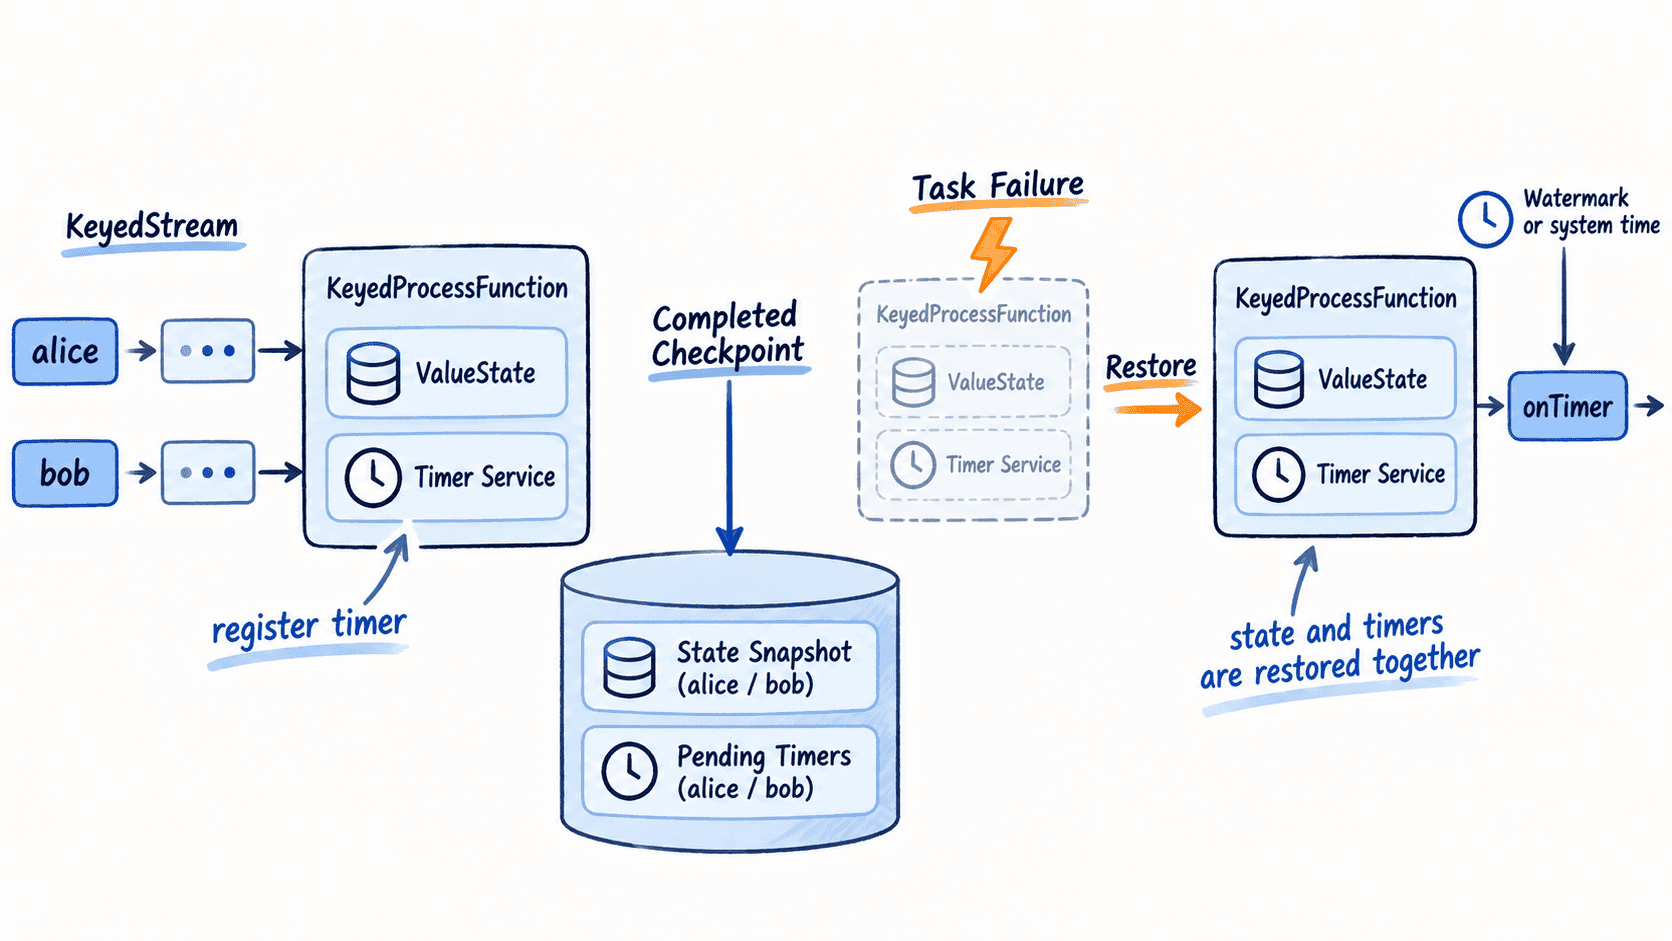
KeyedProcessFunction 只有应用在 KeyedStream 上时,才能同时访问 Keyed State 和按 key 隔离的 Timer Service。注册定时器后,Flink 会把尚未触发的定时器作为容错状态的一部分参与 checkpoint;从已完成 checkpoint 恢复时,业务状态与对应定时器一起回到该快照时刻。
如果故障发生在某条记录已经更新状态、注册定时器,但下一次 checkpoint 尚未完成之后,恢复会回退到上一个已完成 checkpoint。可重放的上游记录会再次执行相同逻辑,因此不要把“注册成功”误认为已经形成独立于 checkpoint 的持久副作用。
用事件时间实现空闲超时
下面的完整示例把事件中的毫秒时间戳作为事件时间。每来一条记录,都删除该 key 之前的超时定时器,再注册“最后事件时间 + 5 秒”的新定时器;这样一个 key 只保留当前真正需要的超时点。
import java.time.Duration;

import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.api.common.functions.OpenContext;
import org.apache.flink.api.common.state.ValueState;
import org.apache.flink.api.common.state.ValueStateDescriptor;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.KeyedProcessFunction;
import org.apache.flink.util.Collector;

public class RecoverableTimerDemo {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);
        env.enableCheckpointing(10_000);

        DataStream<Tuple2<String, Long>> events = env
                .fromElements(
                        Tuple2.of("alice", 1_000L),
                        Tuple2.of("bob", 2_000L),
                        Tuple2.of("alice", 3_000L))
                .assignTimestampsAndWatermarks(
                        WatermarkStrategy
                                .<Tuple2<String, Long>>forBoundedOutOfOrderness(Duration.ZERO)
                                .withTimestampAssigner(
                                        (event, previousTimestamp) -> event.f1));

        events.keyBy(event -> event.f0)
                .process(new InactivityTimeout(5_000L))
                .print();

        env.execute("recoverable-timer-demo");
    }

    static class InactivityTimeout
            extends KeyedProcessFunction<String, Tuple2<String, Long>, String> {

        private final long timeoutMillis;
        private transient ValueState<Long> timerTimestamp;

        InactivityTimeout(long timeoutMillis) {
            this.timeoutMillis = timeoutMillis;
        }

        @Override
        public void open(OpenContext openContext) throws Exception {
            timerTimestamp = getRuntimeContext().getState(
                    new ValueStateDescriptor<>("timer-ts", Long.class));
        }

        @Override
        public void processElement(
                Tuple2<String, Long> event,
                Context ctx,
                Collector<String> out) throws Exception {

            Long oldTimer = timerTimestamp.value();
            if (oldTimer != null) {
                // 旧超时点已经失效,先删除再注册新的超时点。
                ctx.timerService().deleteEventTimeTimer(oldTimer);
            }

            long newTimer = event.f1 + timeoutMillis;
            ctx.timerService().registerEventTimeTimer(newTimer);
            timerTimestamp.update(newTimer);
        }

        @Override
        public void onTimer(
                long timestamp,
                OnTimerContext ctx,
                Collector<String> out) throws Exception {

            out.collect(ctx.getCurrentKey()
                    + " timeout at event-time " + timestamp);
            // 定时器触发后清理辅助状态,避免把旧时间戳带入后续记录。
            timerTimestamp.clear();
        }
    }
}
预期输出
bob timeout at event-time 7000
alice timeout at event-time 8000
示例是有界输入,结束时会推进最终 Watermark,因此两个事件时间定时器都能触发。真实长流中,事件时间定时器只有在 Watermark 推进到相应时间戳后才会触发;仅仅墙上时钟过去了 5 秒,并不会让事件时间定时器自动执行。
区分事件时间与处理时间恢复语义
事件时间定时器适合“业务时间到了再处理”的场景,它依赖 Watermark。恢复后,定时器仍在,但要等恢复后的数据流重新推进 Watermark 才会继续触发。
处理时间定时器使用 registerProcessingTimeTimer(...),依赖 TaskManager 的处理时间。若某个已随 checkpoint 保存的处理时间定时器在故障期间已经过期,那么任务恢复时它可能立即触发。因此,onTimer 应当具备幂等性,不能假设恢复后还会获得完整的剩余等待时间。
同一个 key、同一种时间域、同一个时间戳重复注册,不应该被当成多个独立回调来设计。需要“推迟超时”时,应像示例一样在状态里保存当前时间戳,并显式删除旧定时器。
用故障边界检查设计
检查定时逻辑时,重点看三个边界:定时器是否与正确的 key 绑定、更新业务状态时是否同步更新定时器、onTimer 是否在输出后清理或推进相关状态。只要状态和触发时间共同受 checkpoint 管理,恢复才不会出现“状态回来了,但触发时机永久丢失”的断裂。