
大数据与流处理 / 系统课时
配置 State TTL 过期策略
配置 State TTL 过期策略
Keyed State 如果长期不清理,会让状态规模随着 key 数持续增长。State TTL 用处理时间为状态设置“多久未按规则刷新就过期”的边界,并把“读取时是否可见”和“底层何时真正删除”分开控制。
学习目标
- 为 Keyed State 配置 TTL,并选择合适的更新时间语义
- 区分过期状态的可见性与物理清理时机
- 用可运行示例验证状态过期后重新初始化的行为
TTL 控制可见性,不是精确定时删除
TTL 适用于各类 Keyed State;对 ListState、MapState 这类集合状态,元素或条目可以独立过期。当前 TTL 以处理时间为时间尺度,因此它回答的是“这个状态从运行时视角是否已经过期”,而不是事件时间窗口何时结束。
状态达到 TTL 后,不代表后端会在那个毫秒立刻删除字节。读取状态时,Flink 会根据 TTL 判断它是否过期;物理清理则可能发生在后续访问、后台清理、Heap 的增量扫描或 RocksDB compaction 中。低流量 key 因此可能在存储中多停留一段时间。
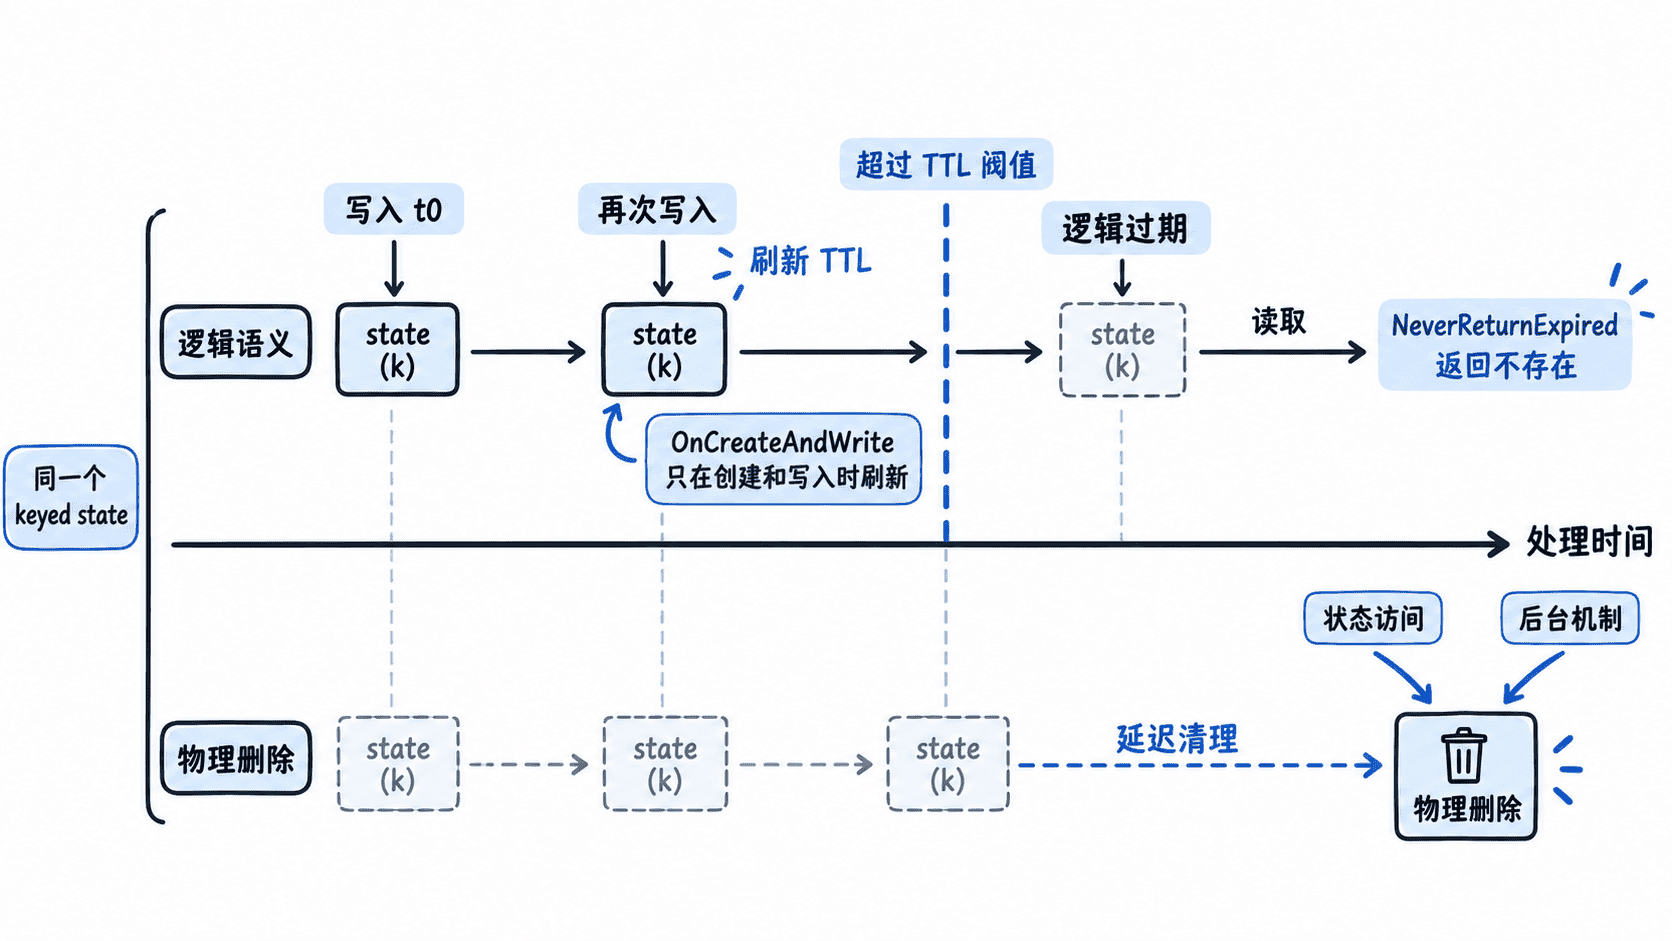
配置更新时间与可见性
StateTtlConfig.UpdateType.OnCreateAndWrite 只在创建或写入状态时刷新 TTL,适合“多久没有新业务更新就失效”的状态。OnReadAndWrite 连读取也会续期,热点 key 可能因为频繁查询而长期存活,只有确实把“被读取”视为活跃行为时才应使用。
StateVisibility.NeverReturnExpired 会让过期值表现得像不存在,即使底层尚未清走;这是更容易推理的默认选择。ReturnExpiredIfNotCleanedUp 允许在物理清理前读到过期值,会弱化 TTL 的严格可见性边界,不适合把 TTL 当作数据不可见期限的场景。
下面的示例把 TTL 设为 300 毫秒。第三条 alice 事件到达前故意等待 500 毫秒,因此旧值已经过期。示例中的 Thread.sleep 只用于制造可观察的处理时间间隔,生产算子不要用阻塞睡眠控制业务节奏。
import java.time.Duration;

import org.apache.flink.api.common.functions.OpenContext;
import org.apache.flink.api.common.state.StateTtlConfig;
import org.apache.flink.api.common.state.ValueState;
import org.apache.flink.api.common.state.ValueStateDescriptor;
import org.apache.flink.api.common.typeinfo.TypeInformation;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.RichFlatMapFunction;
import org.apache.flink.util.Collector;

public class StateTtlDemo {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        env.fromData(
                        TypeInformation.of(Event.class),
                        new Event("alice", 0),
                        new Event("alice", 100),
                        new Event("alice", 500))
                .keyBy(event -> event.user)
                .flatMap(new TtlCounter())
                .print();

        env.execute("state-ttl-demo");
    }

    public static class TtlCounter extends RichFlatMapFunction<Event, String> {
        private transient ValueState<Long> count;

        @Override
        public void open(OpenContext openContext) throws Exception {
            StateTtlConfig ttlConfig = StateTtlConfig
                    .newBuilder(Duration.ofMillis(300))
                    .setUpdateType(StateTtlConfig.UpdateType.OnCreateAndWrite)
                    .setStateVisibility(StateTtlConfig.StateVisibility.NeverReturnExpired)
                    .build();

            ValueStateDescriptor<Long> descriptor =
                    new ValueStateDescriptor<>("count", Long.class);
            descriptor.enableTimeToLive(ttlConfig);
            count = getRuntimeContext().getState(descriptor);
        }

        @Override
        public void flatMap(Event event, Collector<String> out) throws Exception {
            // 仅用于教学:让处理时间跨过 TTL,不要在生产算子里这样限速。
            Thread.sleep(event.delayMillis);

            Long current = count.value();
            long next = current == null ? 1L : current + 1L;
            count.update(next);
            out.collect(event.user + " -> " + next);
        }
    }

    public static class Event {
        public String user;
        public long delayMillis;

        public Event() {}

        public Event(String user, long delayMillis) {
            this.user = user;
            this.delayMillis = delayMillis;
        }
    }
}
预期输出
alice -> 1
alice -> 2
alice -> 1
第三行重新变成 1,说明读取时旧状态已经不可见。实际任务调度会有少量时间抖动,因此验证 TTL 时应让测试间隔明显大于 TTL,不要依赖几毫秒的临界差值。
选择清理策略时看后端而不是看秒表
默认情况下,过期值可在状态读取时被显式移除,并在后端支持时由后台机制继续回收。Heap 后端可以用 cleanupIncrementally 做增量扫描;RocksDB 后端则可通过 compaction filter 清理。清理越积极,通常会换来更多遍历、CPU、JNI 或 compaction 开销。
如果希望完整快照不携带已经过期的状态,可以考虑 cleanupFullSnapshot();但它不是“到点立即清理”的定时器,而且对 RocksDB 增量 checkpoint 不适用。生产配置应同时观察状态大小、checkpoint 时长、恢复时间和处理延迟,再决定是否加强清理。
把 TTL 当作状态语义的一部分
设计 TTL 时先回答三个问题:什么操作代表状态仍活跃、过期后是否允许再次读到旧值、底层回收可以延迟多久。只要把这三件事分开,TTL 就不会被误用成窗口定时器或精确删除任务,而能真正用于约束长期状态规模和可见性。