
大数据与流处理 / 系统课时
使用 MapState 保存映射
使用 MapState 保存映射
当一个业务主键下面还需要维护多个可独立更新的子项时,MapState 比把整张 Map 塞进 ValueState 更直接。本课用“用户 → 商品 → 计数”示例完成按项读取、更新、删除,并用 TTL 与显式清理控制状态规模。
学习目标
- 理解
keyBy的外层 Key 与MapState内层 Key 的两级关系 - 使用
get、put、remove完成单项读写,不遍历整张映射 - 用业务删除和 TTL 限制长期运行作业中的状态增长
把外层 Key 与内层映射分开
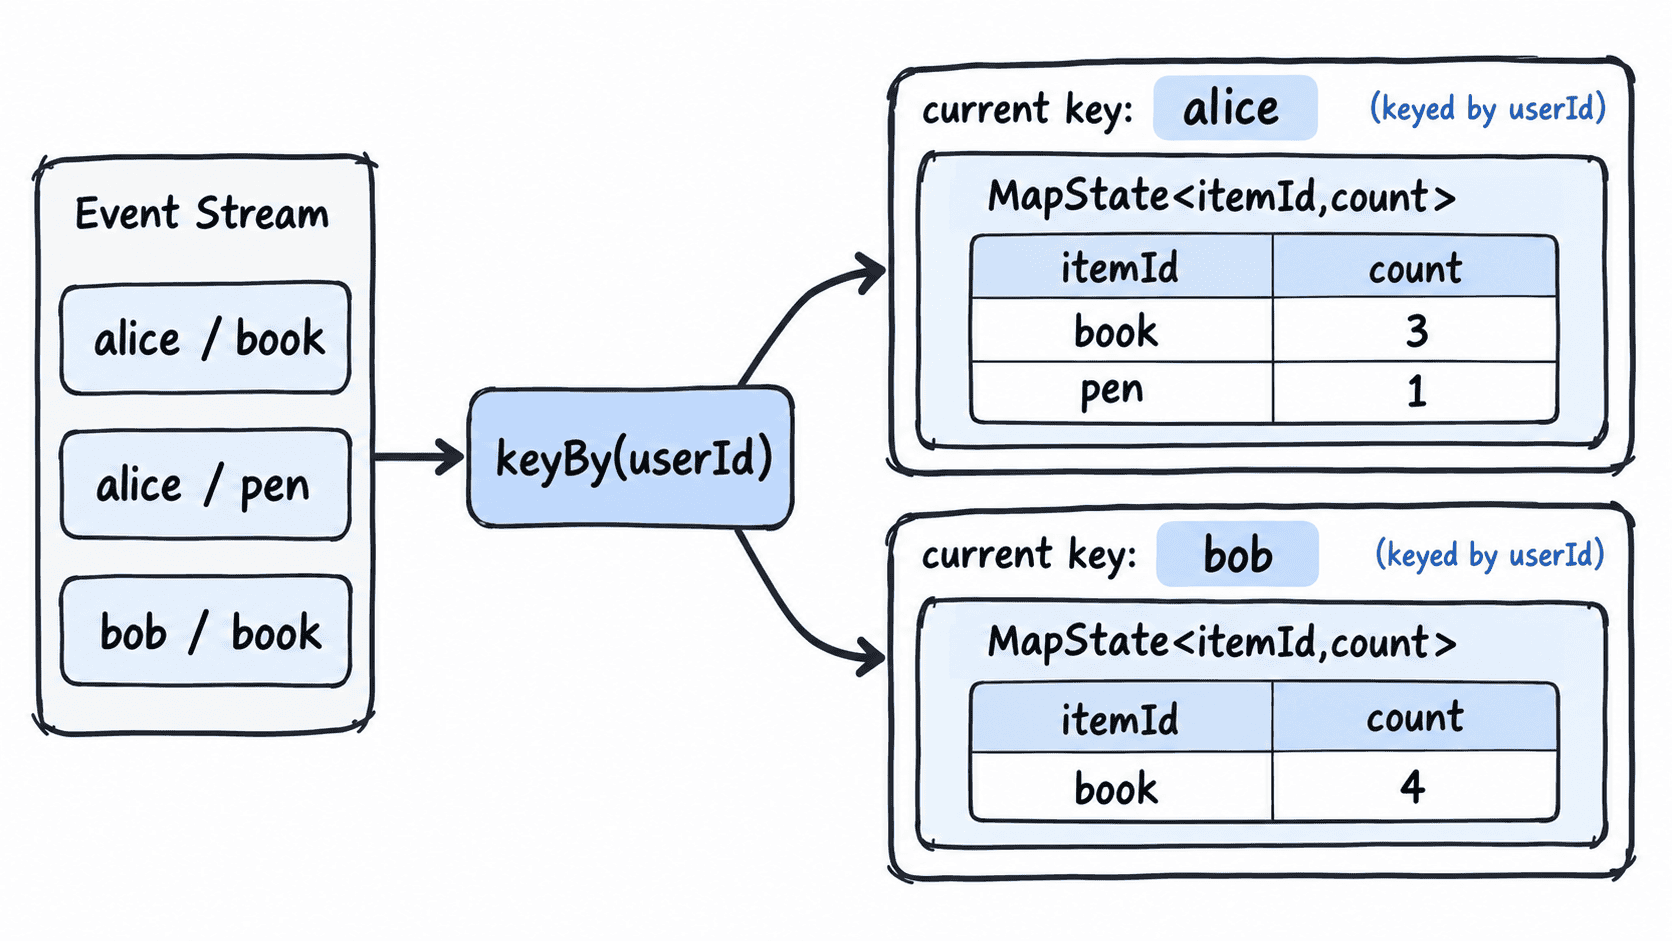
MapState<UK, UV> 只能在 Keyed Stream 上使用。流先通过 keyBy(userId) 选出当前用户,Flink 再让函数访问这个用户对应的状态;MapState 自己的 UK 则是第二级键,例如 itemId。
因此,MapState<String, Integer> 在本例里不是“所有用户共用的一张商品表”,而是每个 userId 都有一份逻辑独立的 itemId → count 映射。代码不需要把 userId 再塞进 MapState 的键。
用一个状态完成按项读写与删除
下面的程序按 userId 分区,使用 itemId 作为 MapState 的内部键。正数 delta 增加计数;更新后小于等于 0 时直接删除该条目。描述符同时配置 30 分钟 TTL,使长期不再写入的 map 条目可以过期。
import org.apache.flink.api.common.functions.OpenContext;
import org.apache.flink.api.common.functions.RichFlatMapFunction;
import org.apache.flink.api.common.state.MapState;
import org.apache.flink.api.common.state.MapStateDescriptor;
import org.apache.flink.api.common.state.StateTtlConfig;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.util.Collector;

import java.time.Duration;

public class MapStateDemo {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        env.fromElements(
                        new Action("alice", "book", 1),
                        new Action("alice", "book", 2),
                        new Action("alice", "pen", 1),
                        new Action("alice", "book", -3),
                        new Action("bob", "book", 4))
                .keyBy(action -> action.userId)
                .flatMap(new RichFlatMapFunction<Action, String>() {
                    private transient MapState<String, Integer> itemCounts;

                    @Override
                    public void open(OpenContext openContext) throws Exception {
                        StateTtlConfig ttlConfig = StateTtlConfig
                                .newBuilder(Duration.ofMinutes(30))
                                .setUpdateType(
                                        StateTtlConfig.UpdateType.OnCreateAndWrite)
                                .setStateVisibility(
                                        StateTtlConfig.StateVisibility.NeverReturnExpired)
                                .build();

                        MapStateDescriptor<String, Integer> descriptor =
                                new MapStateDescriptor<>(
                                        "item-counts",
                                        String.class,
                                        Integer.class);
                        descriptor.enableTimeToLive(ttlConfig);
                        itemCounts = getRuntimeContext().getMapState(descriptor);
                    }

                    @Override
                    public void flatMap(Action action, Collector<String> out)
                            throws Exception {
                        Integer oldValue = itemCounts.get(action.itemId);
                        int next = (oldValue == null ? 0 : oldValue) + action.delta;

                        if (next <= 0) {
                            itemCounts.remove(action.itemId);
                            out.collect(action.userId + "/" + action.itemId
                                    + "=<removed>");
                        } else {
                            itemCounts.put(action.itemId, next);
                            out.collect(action.userId + "/" + action.itemId
                                    + "=" + next);
                        }
                    }
                })
                .print();

        env.execute("map-state-demo");
    }

    public static class Action {
        public String userId;
        public String itemId;
        public int delta;

        public Action() {
        }

        public Action(String userId, String itemId, int delta) {
            this.userId = userId;
            this.itemId = itemId;
            this.delta = delta;
        }
    }
}
预期输出
alice/book=1
alice/book=3
alice/pen=1
alice/book=<removed>
bob/book=4
这里的 get、put 和 remove 都只针对当前 userId 下的一个 itemId。Alice 删除 book 不会碰到 Bob 的 book,这正是两级键模型带来的隔离。
控制 MapState 的增长
显式删除应当优先表达业务事实:订单关闭、会话结束、引用计数归零等场景,一旦子项不再需要,就调用 remove;如果整个当前 Key 的映射都失效,再调用 clear。
TTL 适合兜底清理长时间不活跃的数据。集合状态中的 map 条目可以独立过期,本例使用 OnCreateAndWrite,读取不会延长存活时间。TTL 基于处理时间,因此不要把它当成事件时间窗口或严格业务截止时间。
还要避免在每条事件上调用 entries()、keys() 再全量扫描。映射越大,遍历成本越高;如果业务只修改一个子项,应始终优先按内部键直接访问。对于可能不断出现新 itemId 的流,还应设置业务上限、过期策略或主动淘汰规则。
什么时候选 MapState
当一个外层 Key 下存在大量可独立增删的子项,并且处理逻辑经常按子键随机访问时,MapState 最合适。若每个 Key 只需要一个总量、一个对象或一个聚合结果,ValueState、ReducingState 或 AggregatingState 通常更简单。
选择状态类型时不要只看“能不能存进去”,而要看最常见的更新粒度。需要单项读写就让状态结构直接表达单项读写,状态规模和清理策略也会更容易控制。