
大数据与流处理 / 系统课时
分析对齐 Checkpoint 的阻塞
分析对齐 Checkpoint 的阻塞
对齐 Checkpoint 变慢时,问题往往不在状态快照本身,而是某些输入通道的 Barrier 迟迟到不了。理解 Barrier Alignment 如何阻塞已到达 Barrier 的通道,就能把 Checkpoint 延迟与反压、数据倾斜和下游瓶颈联系起来定位。
学习目标
- 解释多输入算子进行 Barrier Alignment 时哪些通道会被暂时阻塞
- 判断反压为什么会拖慢 Barrier,并进一步放大 Checkpoint 完成时间
- 按数据处理、对齐和状态快照三个阶段定位 Checkpoint 延迟来源
Barrier 为什么需要对齐
Exactly-Once Checkpoint 要得到同一个逻辑时间点的状态。对于拥有多个输入通道的算子,Checkpoint Barrier 会随数据沿各通道向下游传播。算子只有收齐同一个 Checkpoint 的 Barrier,才能确定此前的数据都属于本次快照之前。
假设算子有两个输入通道。通道 A 的 Barrier 已经到达,而通道 B 仍在处理更早的数据,此时 A 在 Barrier 之后到达的数据不能继续参与当前状态计算,否则快照边界会被打乱。因此 A 会被暂时阻塞,B 则继续消费,直到对应 Barrier 到达。
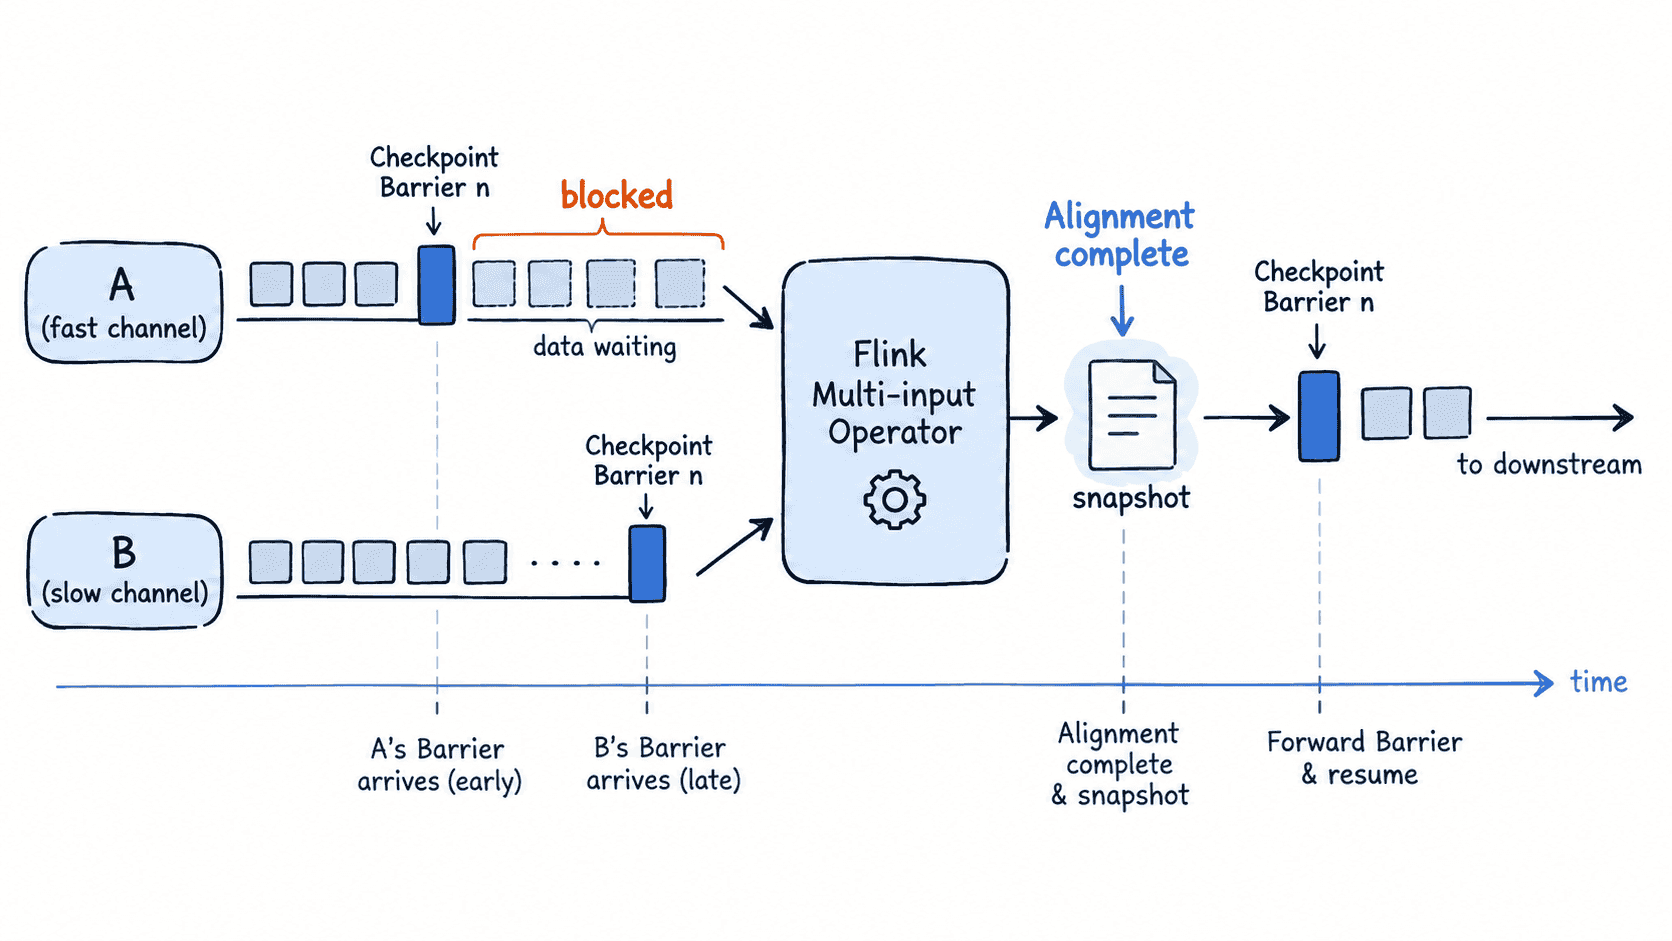
对齐本身并不意味着数据丢失,只是把部分输入暂时停在一致性边界上。真正值得关注的是停了多久,以及为什么还有通道的 Barrier 没有到达。
建立一个明确的对齐基线
分析问题时先确认作业确实使用 Exactly-Once,并暂时保持 Unaligned Checkpoint 关闭,这样观察到的等待时间才对应传统 Barrier Alignment。下面是配置阶段的片段示例,应放在创建数据流之后、调用 env.execute() 之前,依赖已经创建好的 StreamExecutionEnvironment env。
import org.apache.flink.streaming.api.CheckpointingMode;
import org.apache.flink.streaming.api.environment.CheckpointConfig;

// 每 10 秒触发一次 Exactly-Once Checkpoint。
env.enableCheckpointing(10_000L, CheckpointingMode.EXACTLY_ONCE);

CheckpointConfig checkpointConfig = env.getCheckpointConfig();
checkpointConfig.setCheckpointTimeout(60_000L);
checkpointConfig.setMaxConcurrentCheckpoints(1);
// 保持传统对齐模式,便于观察 Barrier Alignment。
checkpointConfig.disableUnalignedCheckpoints();
这段配置不会单独产生控制台输出。生效后,应在运行中的作业里看到周期性 Checkpoint;当输入存在明显反压时,对齐阶段可能占据较长时间,而总 Checkpoint 超过 60 秒会按照超时规则失败。
反压怎样放大对齐时间
Barrier 与普通记录共享输入通道的顺序语义。某条通道发生持续反压时,已经进入网络缓冲区的数据需要先被消费,后面的 Barrier 才能推进到算子,因此慢通道的 Barrier 会明显落后。
与此同时,已经收到 Barrier 的快通道进入阻塞状态。它停止继续向当前算子输送 Barrier 之后的数据,这种等待还可能向上游传播,使更多缓冲区堆积。于是一次局部的吞吐瓶颈,会表现为“慢通道 Barrier 更慢、快通道等待更久、Checkpoint 总耗时继续上升”的放大过程。
常见根因包括数据倾斜造成单个并行实例过载、算子执行耗时过长、外部 Sink 吞吐不足,以及下游持续反压传回上游。它们都可能拖慢 Barrier,但修复位置并不相同。
按阶段定位真正的瓶颈
遇到 Checkpoint 变慢,不要先修改 Checkpoint 间隔或超时。更有效的顺序是先确认作业是否正在反压,再定位是哪些算子或分区成为瓶颈,最后区分等待 Barrier 与真正执行状态快照的时间。
如果普通数据处理已经持续受阻,同时多输入算子的对齐等待显著增长,应优先处理吞吐瓶颈,例如消除热点 key、提高合适算子的并行度、减少同步外部调用或提升 Sink 写入能力。只有对齐等待高而状态快照本身正常时,才说明主要问题位于 Barrier 传播路径。
相反,如果 Barrier 很快收齐,但快照和持久化阶段仍然很慢,应转向检查状态规模、状态后端以及 Checkpoint Storage,而不是继续追查 Alignment。
什么时候考虑改变 Checkpoint 策略
短暂反压偶尔导致一次 Alignment 变长,并不意味着必须切换策略。先修复可消除的吞吐瓶颈,通常能同时改善业务延迟和 Checkpoint。
如果作业长期处于高反压,Barrier 经常被大量在途数据挡住,而业务又需要稳定完成 Checkpoint,那么传统对齐机制本身就可能成为恢复保障链路上的主要等待点。这时再评估 Unaligned Checkpoint,才能针对真正的问题改变一致性快照策略,而不是用配置掩盖普通性能故障。