
大数据与流处理 / 系统课时
配置 HashMapStateBackend
配置 HashMapStateBackend
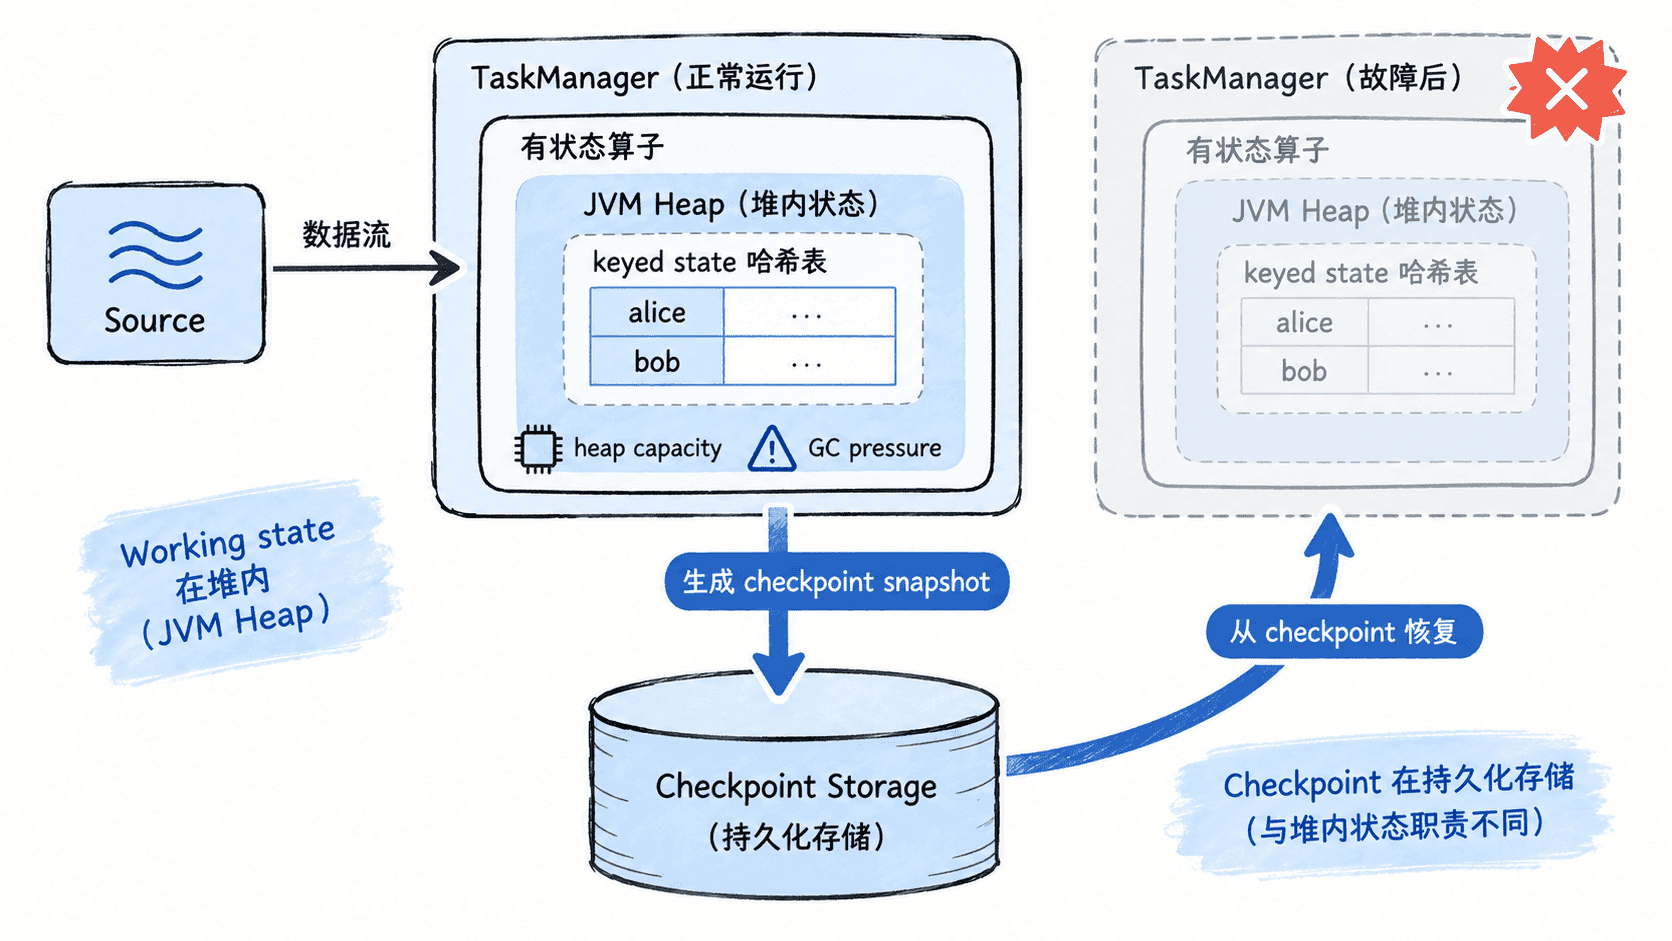
HashMapStateBackend 把运行中的 keyed state 与 operator state 直接保存在 TaskManager JVM 堆内,访问路径短、延迟低,但容量和稳定性会受到堆大小与 GC 影响。本篇完成后,你能正确配置它,并知道何时该继续用、何时该换后端。
学习目标
- 配置
HashMapStateBackend与独立的 checkpoint 存储。 - 理解堆内对象状态为何访问快,以及它对 GC 和容量的影响。
- 根据状态规模、对象数量与恢复需求判断它是否合适。
堆内状态与 checkpoint 是两件事
HashMapStateBackend 管的是作业运行时的工作状态:状态对象存在 JVM 堆里,算子读写时不需要像 RocksDB 那样先把每次访问转换成序列化字节。这使它适合状态量可控、希望降低状态访问开销的作业。
但“状态在堆里”不等于“checkpoint 也在堆里”。启用 checkpoint 后,快照仍应写入独立的持久化存储。TaskManager 进程丢失时,恢复依赖已完成的 checkpoint,而不是已经消失的堆内对象。
用代码显式配置后端
下面的 Java 示例使用 HashMapStateBackend,并为 checkpoint 指定文件存储位置。为了让输出稳定,示例将并行度设为 1;实际项目应把 checkpoint 目录换成集群可访问、具备持久性的存储。
package demo;

import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.runtime.state.hashmap.HashMapStateBackend;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class HashMapBackendJob {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        // 运行中的状态对象直接保存在 TaskManager JVM 堆内。
        env.setStateBackend(new HashMapStateBackend());

        // checkpoint 必须有独立存储位置,不能把进程内存当恢复介质。
        env.enableCheckpointing(10_000);
        env.getCheckpointConfig().setCheckpointStorage(
                "file:///tmp/flink-hashmap-checkpoints");

        env.fromElements(
                Tuple2.of("alice", 1),
                Tuple2.of("alice", 2),
                Tuple2.of("bob", 5))
            .keyBy(value -> value.f0)
            .sum(1)
            .print();

        env.execute("hashmap-backend-demo");
    }
}
预期输出:
(alice,1)
(alice,3)
(bob,5)
这个有界示例通常会在第一次 10 秒 checkpoint 到来前结束,因此输出验证的是状态聚合逻辑与后端配置可以正常运行。长运行生产作业还应在 Flink 的 checkpoint 指标中确认成功次数、持续时间与失败原因。
容量上限首先由 JVM 堆决定
HashMapStateBackend 的优势也是它的边界:状态以 Java 对象形式占用堆。状态条目增多时,不只是业务字段本身消耗内存,哈希表、对象头、引用和序列化前的对象结构也会产生额外开销。因此不能只按“原始数据大小”估算状态容量。
GC 是第二个约束。大量长生命周期对象会扩大老年代压力;如果 key 数量持续增长或单个 value 很大,GC 暂停和 Full GC 风险会随之上升。生产环境应同时观察 JVM heap 使用率、GC pause、状态大小和 checkpoint duration,而不是只看吞吐量。
checkpoint 压力会随总状态增长
HashMapStateBackend 不提供 EmbeddedRocksDBStateBackend 那种基于 SST 文件复用的增量 checkpoint。状态越大,快照需要处理的数据通常越多,因此 checkpoint 的耗时、网络与存储压力都会随状态规模上升。
这意味着它最适合“小到中等、可预估”的状态:例如有限时间窗口、受 TTL 控制的 keyed state,或 key 基数明确且单值较小的聚合。若状态持续增长到数 GB 乃至更大,并开始频繁触发长 GC 或 checkpoint 超时,就应重新评估后端选择,而不是只增加 checkpoint 间隔。
什么时候继续使用它
当状态能稳定装入 JVM 堆、访问延迟比超大容量更重要,并且 GC 指标健康时,HashMapStateBackend 往往是简单而高效的选择。上线前至少做一次接近生产 key 基数和状态大小的压测,确认峰值堆占用仍有余量,checkpoint 能在预期时间内完成。
如果你的主要矛盾已经变成“状态放不下”“GC 难以控制”或“完整快照成本过高”,就不应继续把问题归结为堆参数调优;这通常说明需要转向可利用本地磁盘并支持增量 checkpoint 的 EmbeddedRocksDBStateBackend。