
大数据与流处理 / 系统课时
分清 StateBackend 与 CheckpointStorage
分清 StateBackend 与 CheckpointStorage
排查状态作业时,最常见的误区是把“任务运行时把状态放在哪里”和“checkpoint 最终持久化到哪里”当成同一个配置。StateBackend 与 CheckpointStorage 已经是两层职责,分开理解后才能正确选择性能路径和容灾位置。
学习目标
- 能分别说明 StateBackend 与 CheckpointStorage 管理的对象和生命周期。
- 能判断 HashMap、RocksDB 与文件系统检查点目录分别解决什么问题。
- 能用一组最小配置验证工作状态与持久化快照没有混在一起。
两个组件分别负责什么
StateBackend 决定算子在运行期间怎样保存和访问 managed state,以及生成快照时采用什么实现方式。例如,HashMapStateBackend 主要把工作状态放在 JVM 堆内;EmbeddedRocksDBStateBackend 则使用本地 RocksDB 管理较大的状态,并支持增量 checkpoint 等能力。
CheckpointStorage 负责 checkpoint 的持久化位置与相关元数据。它决定已生成的 checkpoint 数据放在 JobManager 内存还是外部文件系统,而不是决定 ValueState、MapState 在每条记录到来时从哪里读写。
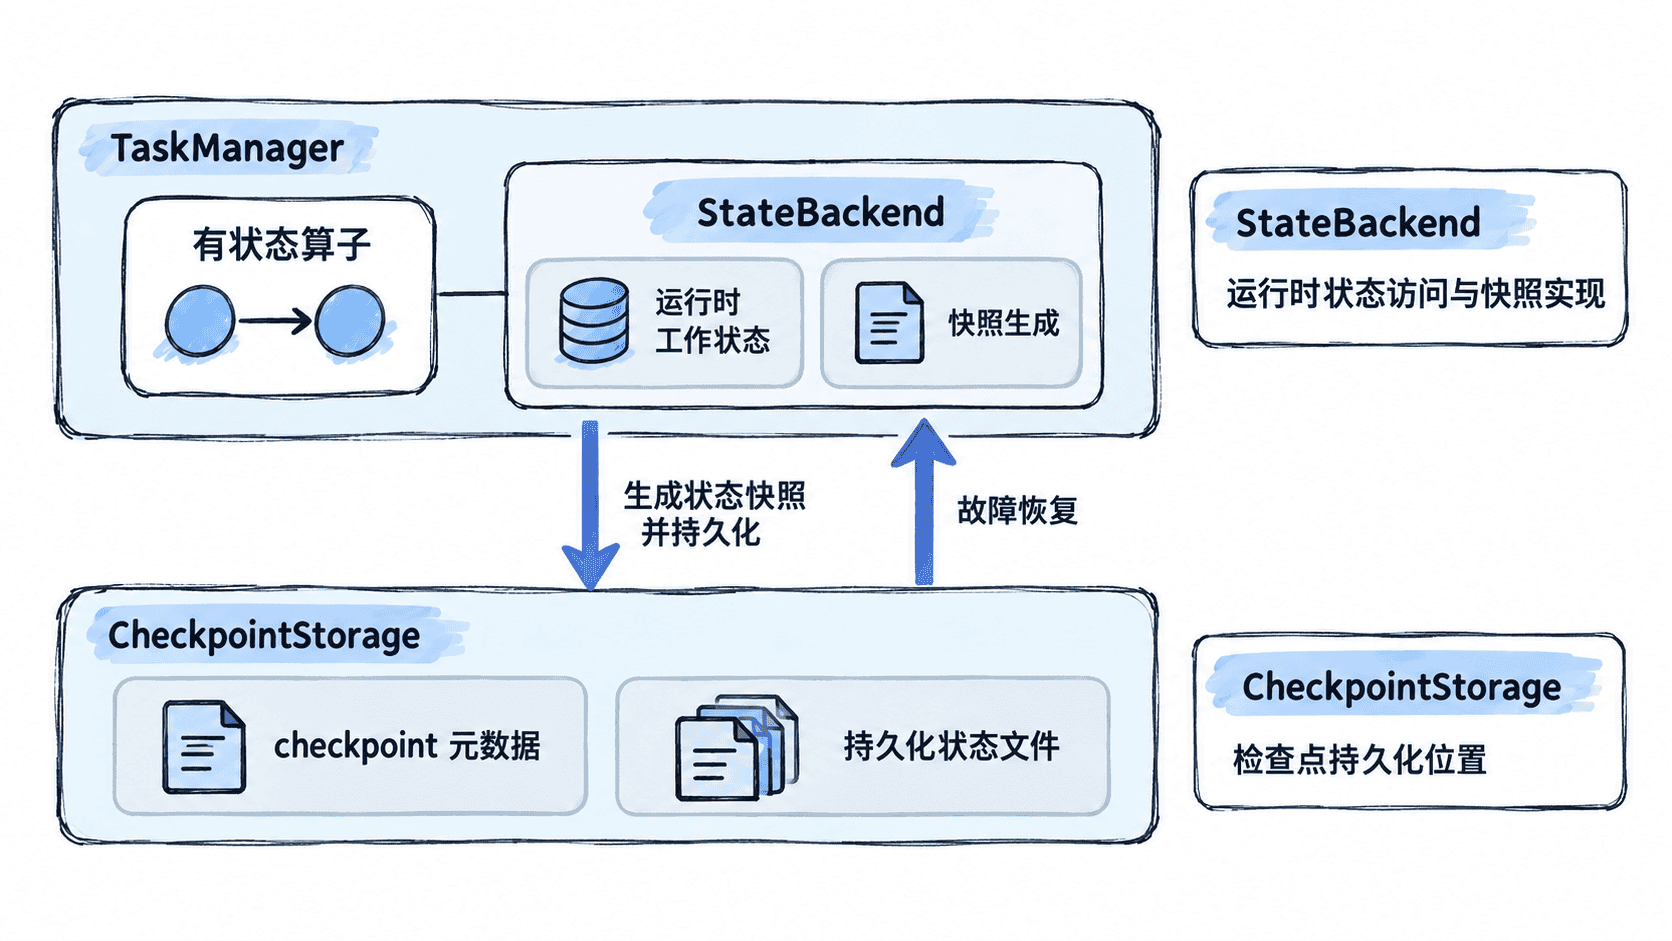
可以把它们理解成两道问题:状态活着的时候怎么存、怎么访问,由 StateBackend 回答;形成 checkpoint 后把恢复材料放在哪里,由 CheckpointStorage 回答。两者会协作,但配置维度不同。
用最小配置把职责拆开
下面以本地验证环境为例,选择 HashMapStateBackend,同时把 checkpoint 持久化到文件系统目录。生产环境不应把高可用恢复点放在会随 TaskManager 消失的临时本地盘上,应改为所有恢复节点都能访问的持久化存储。
state.backend.type: hashmap
execution.checkpointing.storage: filesystem
execution.checkpointing.dir: file:///tmp/flink-checkpoints
这段配置的生效行为是:运行时 managed state 采用 HashMapStateBackend;完成的 checkpoint 写入 /tmp/flink-checkpoints。是否真的产生 checkpoint 还取决于作业是否启用了 checkpoint。
在至少一个 checkpoint 完成后,可以检查目录结构。
find /tmp/flink-checkpoints -maxdepth 2 -type d | sort预期输出类似下面的结构,<JOB_ID> 与 <ID> 是运行时动态值,实际值会不同。
/tmp/flink-checkpoints
/tmp/flink-checkpoints/<JOB_ID>
/tmp/flink-checkpoints/<JOB_ID>/chk-<ID>
如果目录完全没有出现,优先检查作业是否调用了 enableCheckpointing 或是否通过配置启用了周期性 checkpoint,而不是先怀疑 StateBackend。
不要把 RocksDB 本地目录当成恢复点
选择 EmbeddedRocksDBStateBackend 后,任务会在本地维护 RocksDB 工作数据,但这些本地文件本身不是跨节点容灾的最终恢复依据。节点丢失时,Flink 仍需要从最近一次成功的 checkpoint 或 savepoint 重建状态。
因此,“用了 RocksDB”不能替代“配置可靠的 CheckpointStorage”。反过来,把 checkpoint 写到对象存储或分布式文件系统,也不会自动把运行时状态改成 RocksDB;运行时状态访问方式仍由 StateBackend 决定。
选择时按两个问题分别决策
状态规模较小、追求低延迟并且堆内存可控时,可以优先考虑 HashMapStateBackend;状态很大、需要降低 JVM 堆压力或利用 RocksDB 能力时,再评估 EmbeddedRocksDBStateBackend。这个选择主要面向运行时状态特征。
CheckpointStorage 则要围绕恢复目标选择:开发环境可以使用简单存储,生产环境应优先保证持久化、共享可访问和足够的吞吐。只要把“工作状态实现”和“恢复材料位置”分成两张清单,StateBackend 与 CheckpointStorage 就不会再被混为一谈。