
大数据与流处理 / 系统课时
配置 EmbeddedRocksDBStateBackend
配置 EmbeddedRocksDBStateBackend
EmbeddedRocksDBStateBackend 把状态编码为字节后交给内嵌 RocksDB 管理,可利用本地磁盘承载远大于 JVM 堆的状态,并支持增量 checkpoint。代价是序列化、RocksDB 访问和本地 I/O 开销。本篇会完成可运行配置,并建立容量、内存与恢复之间的正确边界。
学习目标
- 配置
EmbeddedRocksDBStateBackend并开启增量 checkpoint。 - 理解序列化访问、RocksDB 内存、本地磁盘与远端 checkpoint 的职责分工。
- 根据状态规模、磁盘和恢复成本判断它是否优于堆内后端。
先分清四个存储层次
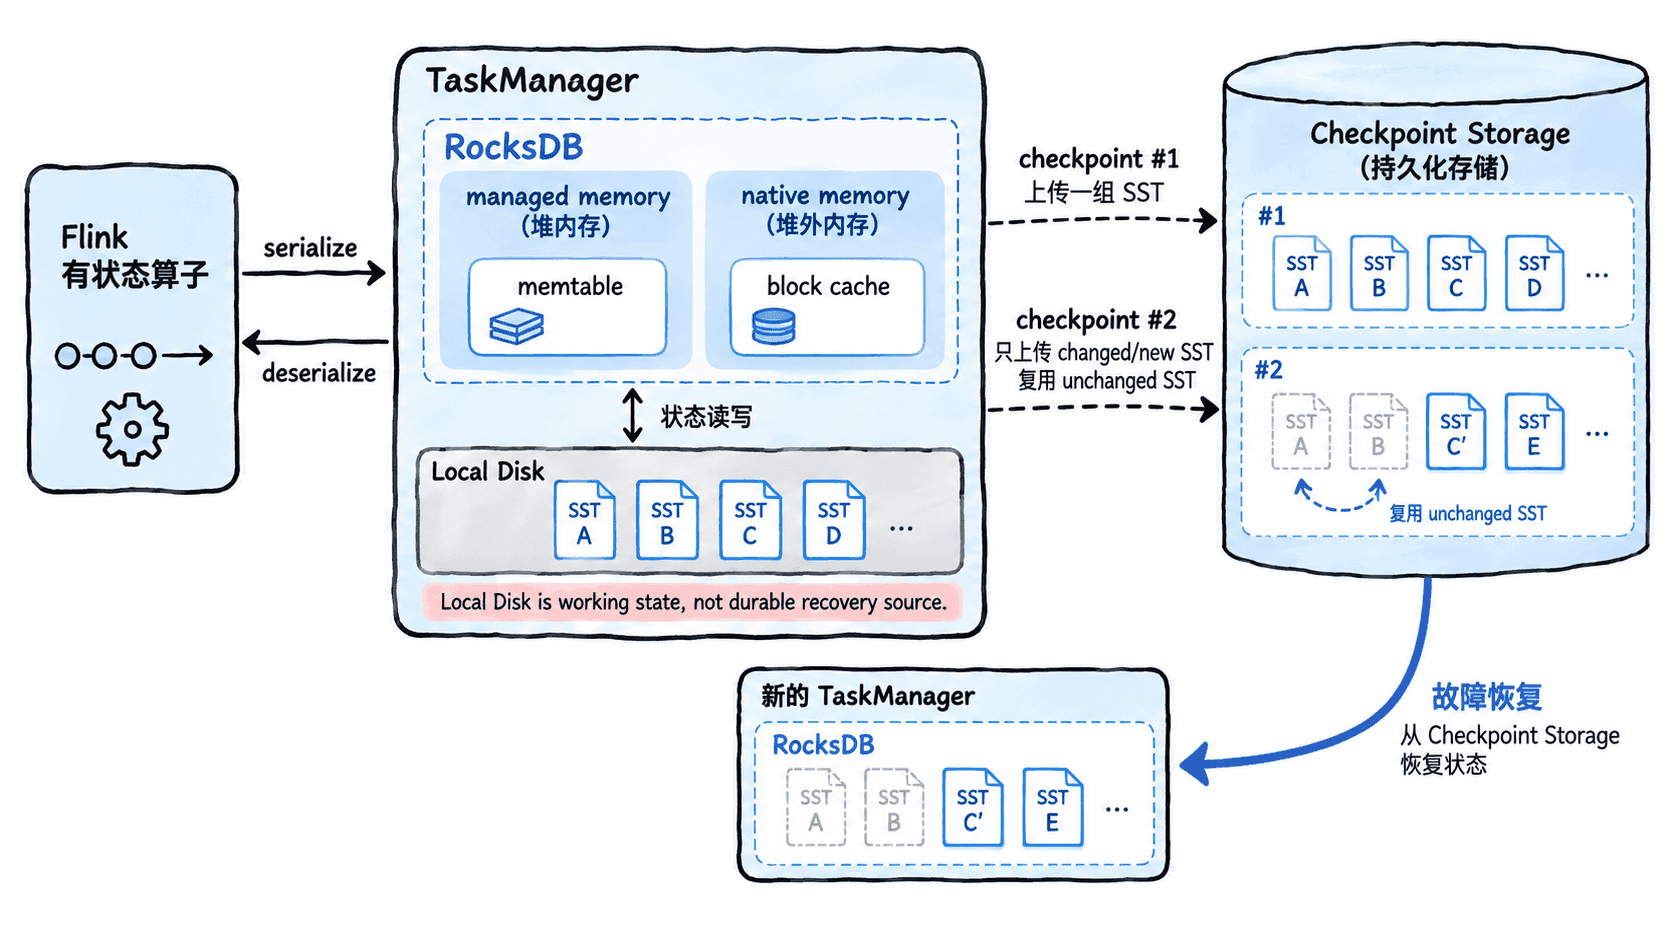
算子访问 RocksDB 状态时,key 和 value 需要以序列化形式进入 RocksDB。热点数据可能命中内存中的 memtable 或 block cache,更多数据则落在本地 SST 文件中,因此状态总量不再受 JVM 堆容量直接限制。
本地 RocksDB 目录只是运行时工作集,不是可靠备份。机器或容器丢失后,真正用于恢复的是已经完成的 checkpoint。开启增量 checkpoint 后,后续快照可以复用先前已上传的 SST 文件,只上传新增或变化的文件,从而降低大状态反复做完整快照的成本。
用代码开启 RocksDB 与增量快照
示例假设项目已经按所用 Flink 版本引入 DataStream 依赖和 flink-statebackend-rocksdb 模块。EmbeddedRocksDBStateBackend(true) 中的 true 表示启用增量 checkpoint;checkpoint 存储仍然单独配置。
package demo;

import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.state.rocksdb.EmbeddedRocksDBStateBackend;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class RocksDbBackendJob {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        // true 表示启用增量 checkpoint。
        env.setStateBackend(new EmbeddedRocksDBStateBackend(true));
        env.enableCheckpointing(10_000);

        // 生产环境应改成所有 TaskManager 都可访问的持久化存储。
        env.getCheckpointConfig().setCheckpointStorage(
                "file:///tmp/flink-rocksdb-checkpoints");

        env.fromElements(
                Tuple2.of("alice", 1),
                Tuple2.of("alice", 2),
                Tuple2.of("bob", 5))
            .keyBy(value -> value.f0)
            .sum(1)
            .print();

        env.execute("rocksdb-backend-demo");
    }
}
预期输出:
(alice,1)
(alice,3)
(bob,5)
同样地,这个有界示例可能在第一个 checkpoint 触发前就结束;它用于验证 RocksDB 后端能够驱动状态算子正常运行。要验证增量 checkpoint,应在长运行作业中连续完成至少两个 checkpoint,再比较快照中新增文件与复用文件的情况。
性能成本来自序列化和本地 I/O
与 HashMapStateBackend 直接访问堆内对象不同,RocksDB 状态读写需要序列化和反序列化。热点数据若命中缓存,延迟仍可接受;缓存未命中时则可能访问本地磁盘。因此它通常用“更高的单次访问成本”换取“更大的可承载状态”。
磁盘质量会直接影响尾延迟与 checkpoint 稳定性。生产环境应优先使用低延迟本地 SSD,并避免让 RocksDB 工作目录与其他高 I/O 任务争抢同一块盘。还要保留足够的本地磁盘空间,因为 compaction 会产生临时文件,磁盘占满可能让任务直接失败。
托管内存不是 JVM 堆
RocksDB 的 block cache、memtable 等主要使用本地内存。Flink 可以把这部分纳入 TaskManager 的 managed memory 预算,使同一个 slot 中多个 RocksDB 实例共享受控内存,减少彼此无上限争抢的风险。
这并不意味着“启用 managed memory 后就不会 OOM”。JNI、线程栈、压缩库和其他 native 开销仍可能存在于预算之外,因此排查内存问题时要同时看 JVM heap、managed memory、process resident memory 与容器限制,不能只盯 Java 堆。
增量 checkpoint 适合大状态但不是免费午餐
增量 checkpoint 会复用未变化的 SST 文件,因此当总状态很大而每个周期只改变其中一部分时,上传量通常明显小于完整快照。但 RocksDB compaction 会重写 SST 文件,这些新文件也会成为后续 checkpoint 的新增内容,所以增量大小并不等于“业务更新字节数”。
评估效果时应看连续多个 checkpoint 的 uploaded data、duration、alignment/processing delay 与恢复时间。若 checkpoint 很小但恢复过慢,问题可能来自远端存储吞吐、并发下载或本地磁盘,而不是快照模式本身。
什么时候选择 RocksDB
当 keyed state 已经接近或超过可安全使用的 JVM 堆、key 基数很高、窗口或 TTL 允许状态长期存在,或者完整 checkpoint 成本过高时,EmbeddedRocksDBStateBackend 通常更合适。选择它之前应确认 TaskManager 有稳定的本地 SSD、足够的本地磁盘余量,并为 checkpoint 准备可靠的持久化存储。
如果状态始终很小、GC 压力低,而且你更关心最低状态访问延迟,那么 RocksDB 的序列化与 I/O 开销可能没有必要;后端选择的核心不是“哪个更高级”,而是让运行时状态规模、内存模型和恢复目标匹配。