
大数据与流处理 / 系统课时
完成有状态容错综合演练
完成有状态容错综合演练
这次演练把状态、TTL、Checkpoint、故障恢复、Savepoint 扩缩容和 Kafka Exactly-Once 串成一条可验证链路。最终你会得到一个按 key 累加的 DataStream 作业,并用故障注入证明状态与输出都能在恢复后保持一致。
学习目标
- 实现带
ValueState与 TTL 的 keyed 聚合作业,并开启 Exactly-Once Checkpoint。 - 注入一次可恢复故障,验证 Checkpoint 回滚与 Kafka Exactly-Once 输出。
- 从 Savepoint 将并行度从 2 调整到 4,并确认 keyed state 正确重分配。
明确演练链路与验收口径
准备两个全新的 Kafka topic:输入 topic 每行格式为 user,delta,输出 topic 写入 user,sum。作业按 user 分区,用 ValueState<Long> 保存累计值;TTL 设为 2 分钟,便于在实验环境观察过期;当某个 key 的累计值首次达到 100 时,算子在第一次执行尝试中主动抛异常。
故障恢复后,Kafka Source 从最近一次成功 Checkpoint 的 offset 继续,状态也从同一 Checkpoint 恢复。Kafka Sink 使用事务提交并设置 EXACTLY_ONCE,因此使用 read_committed 读取时,不应看到故障前未提交事务造成的重复记录。
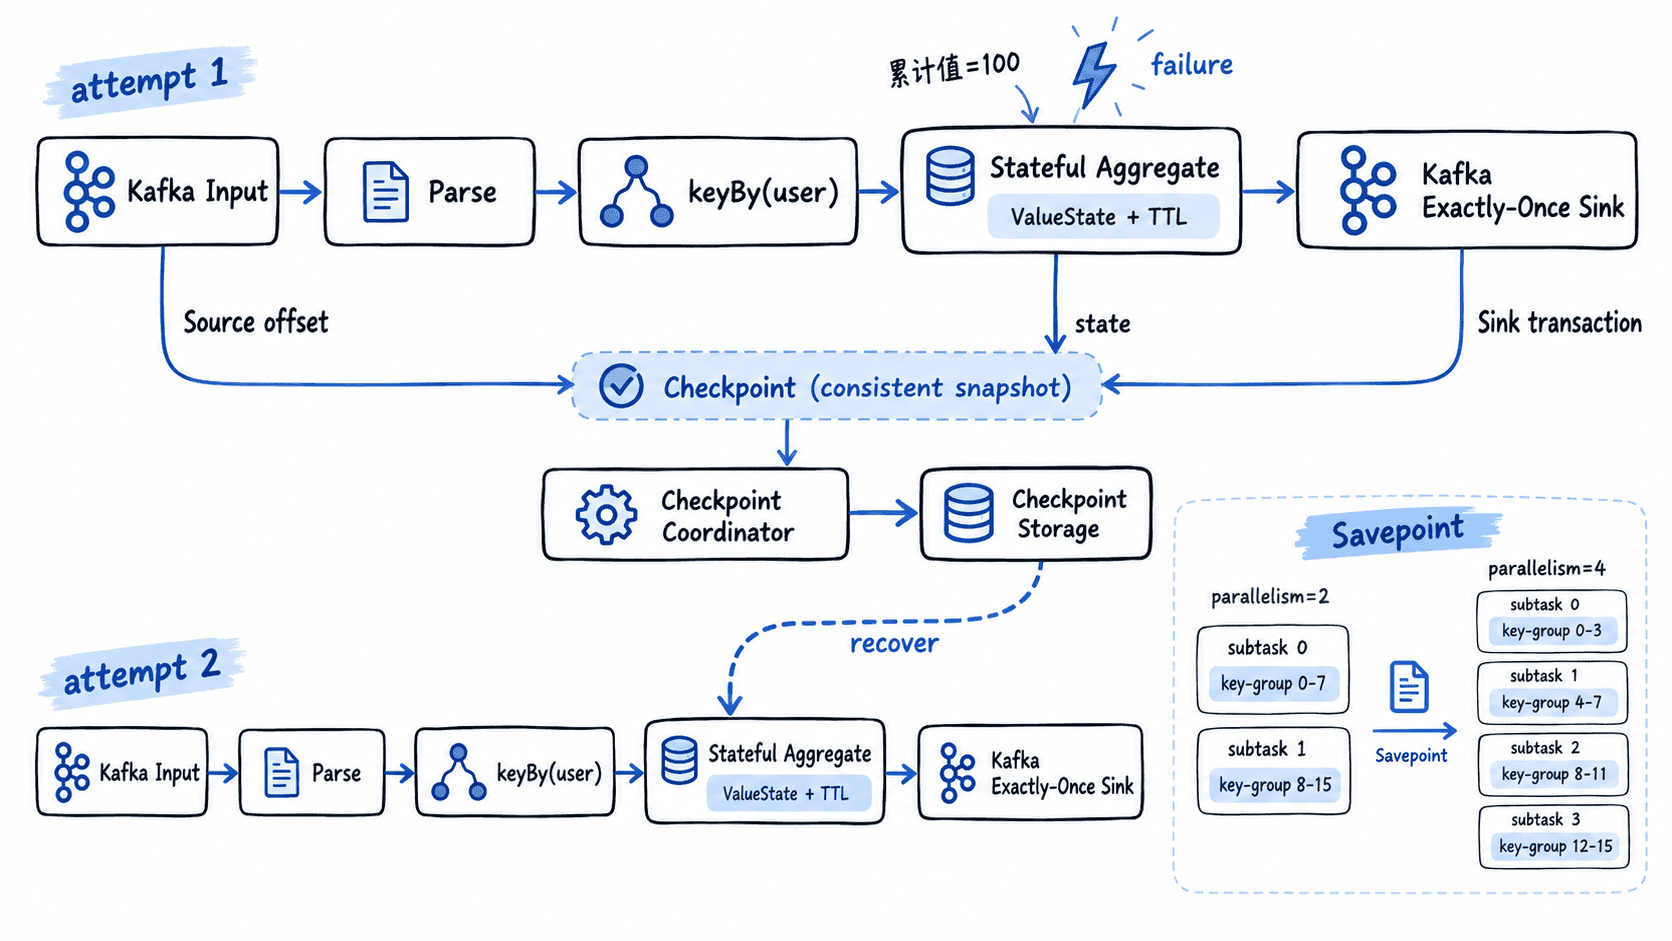
验收时不要只看 Job 状态为 RUNNING,而要检查四个结果:故障后累计值延续而不是从零开始;输出 topic 在 read_committed 下没有重复提交;TTL 到期后的 key 会从空状态重新累计;Savepoint 恢复到并行度 4 后历史 key 仍保持原值。
实现带 TTL 和故障注入的作业
下面是完整主示例。它要求工程已经加入 Flink DataStream 与 Kafka Connector 依赖;checkpointDir 必须是所有 TaskManager 都能访问的持久化 URI。生产环境通常使用对象存储或分布式文件系统,本地单机实验可以使用 file:///...。
package com.example;

import java.time.Duration;

import org.apache.flink.api.common.functions.OpenContext;
import org.apache.flink.api.common.restartstrategy.RestartStrategies;
import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.api.common.state.StateTtlConfig;
import org.apache.flink.api.common.state.ValueState;
import org.apache.flink.api.common.state.ValueStateDescriptor;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.connector.base.DeliveryGuarantee;
import org.apache.flink.connector.kafka.sink.KafkaRecordSerializationSchema;
import org.apache.flink.connector.kafka.sink.KafkaSink;
import org.apache.flink.connector.kafka.source.KafkaSource;
import org.apache.flink.connector.kafka.source.enumerator.initializer.OffsetsInitializer;
import org.apache.flink.streaming.api.CheckpointingMode;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.KeyedProcessFunction;
import org.apache.flink.util.Collector;

public class StatefulFaultToleranceJob {

    public static void main(String[] args) throws Exception {
        if (args.length != 4) {
            throw new IllegalArgumentException(
                    "args: <bootstrapServers> <inputTopic> <outputTopic> <checkpointDir>");
        }

        String bootstrapServers = args[0];
        String inputTopic = args[1];
        String outputTopic = args[2];
        String checkpointDir = args[3];

        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.enableCheckpointing(10_000, CheckpointingMode.EXACTLY_ONCE);
        env.getCheckpointConfig().setCheckpointStorage(checkpointDir);
        env.setRestartStrategy(RestartStrategies.fixedDelayRestart(3, 1_000L));

        KafkaSource<String> source = KafkaSource.<String>builder()
                .setBootstrapServers(bootstrapServers)
                .setTopics(inputTopic)
                .setGroupId("state-ft-lab")
                .setStartingOffsets(OffsetsInitializer.earliest())
                .setValueOnlyDeserializer(new SimpleStringSchema())
                .build();

        KafkaSink<String> sink = KafkaSink.<String>builder()
                .setBootstrapServers(bootstrapServers)
                .setRecordSerializer(
                        KafkaRecordSerializationSchema.builder()
                                .setTopic(outputTopic)
                                .setValueSerializationSchema(new SimpleStringSchema())
                                .build())
                .setDeliveryGuarantee(DeliveryGuarantee.EXACTLY_ONCE)
                .setTransactionalIdPrefix("state-ft-lab-")
                .build();

        SingleOutputStreamOperator<Tuple2<String, Long>> parsed = env
                .fromSource(source,
                        org.apache.flink.api.common.eventtime.WatermarkStrategy.noWatermarks(),
                        "kafka-source")
                .uid("kafka-source-v1")
                .map(line -> {
                    String[] parts = line.split(",", 2);
                    return Tuple2.of(parts[0], Long.parseLong(parts[1]));
                })
                .returns(org.apache.flink.api.common.typeinfo.Types.TUPLE(
                        org.apache.flink.api.common.typeinfo.Types.STRING,
                        org.apache.flink.api.common.typeinfo.Types.LONG))
                .name("parse");

        parsed
                .keyBy(value -> value.f0)
                .process(new SumWithTtlAndOneFailure())
                .name("sum-with-ttl")
                .uid("sum-with-ttl-v1")
                .setMaxParallelism(128)
                .sinkTo(sink)
                .name("kafka-exactly-once-sink")
                .uid("kafka-exactly-once-sink-v1");

        env.execute("state-fault-tolerance-lab");
    }

    static final class SumWithTtlAndOneFailure
            extends KeyedProcessFunction<String, Tuple2<String, Long>, String> {

        private transient ValueState<Long> sum;

        @Override
        public void open(OpenContext openContext) throws Exception {
            StateTtlConfig ttl = StateTtlConfig
                    .newBuilder(Duration.ofMinutes(2))
                    .setUpdateType(StateTtlConfig.UpdateType.OnCreateAndWrite)
                    .setStateVisibility(StateTtlConfig.StateVisibility.NeverReturnExpired)
                    .build();

            ValueStateDescriptor<Long> descriptor =
                    new ValueStateDescriptor<>("sum", Long.class);
            descriptor.enableTimeToLive(ttl);
            sum = getRuntimeContext().getState(descriptor);
        }

        @Override
        public void processElement(
                Tuple2<String, Long> value,
                Context context,
                Collector<String> out) throws Exception {

            Long previous = sum.value();
            long next = (previous == null ? 0L : previous) + value.f1;
            sum.update(next);

            // 只在第一次执行尝试中注入故障,避免重启后再次进入失败循环。
            if (getRuntimeContext().getTaskInfo().getAttemptNumber() == 0
                    && next >= 100L) {
                throw new RuntimeException("injected failure");
            }

            out.collect(value.f0 + "," + next);
        }
    }
}
这段程序的关键不在异常本身,而在三个稳定边界:聚合算子的 UID 固定为 sum-with-ttl-v1;其 maxParallelism 固定为 128,为后续并行度调整保留 key-group 空间;Kafka Sink 使用事务语义,提交结果与 Checkpoint 对齐。
运行并验证故障恢复
先以并行度 2 提交作业,再发送三条输入。将 <PATH> 替换为本机实际目录;Checkpoint 路径应提前创建并具备写权限。
FLINK_HOME="<PATH>"
KAFKA_HOME="<PATH>"
JOB_JAR="<PATH>/state-ft-lab.jar"
CHECKPOINT_URI="file:///tmp/flink-state-ft-checkpoints"

"$FLINK_HOME/bin/flink" run -d -p 2 -c com.example.StatefulFaultToleranceJob "$JOB_JAR" localhost:9092 input-state-ft output-state-ft "$CHECKPOINT_URI"
printf 'alice,40\nalice,30\n' | "$KAFKA_HOME/bin/kafka-console-producer.sh" --bootstrap-server localhost:9092 --topic input-state-ft
sleep 15
printf 'alice,50\n' | "$KAFKA_HOME/bin/kafka-console-producer.sh" --bootstrap-server localhost:9092 --topic input-state-ft
预期输出
Job has been submitted with JobID <ID>示例中的 15 秒用于给 10 秒 Checkpoint 周期留出完成时间;环境较慢时应以实际出现至少一个成功 Checkpoint 为准。第三条记录把 alice 的累计值推到 120,会在第一次 attempt 中触发异常。Flink 重启后应从最近一次成功 Checkpoint 恢复;等待新的 Checkpoint 完成后,用只读已提交事务的消费者检查输出。
KAFKA_HOME="<PATH>"

"$KAFKA_HOME/bin/kafka-console-consumer.sh" --bootstrap-server localhost:9092 --topic output-state-ft --from-beginning --isolation-level read_committed --timeout-ms 20000
预期结果
alice,40
alice,70
alice,120
若测试 topic 是全新的,以上三条结果应各出现一次。若看到重复记录,先确认消费者是否使用 read_committed,再检查 Sink 是否仍为 EXACTLY_ONCE、事务 ID 前缀是否与其他并发作业冲突,以及 Checkpoint 是否持续成功。
用 Savepoint 完成扩缩容
在作业稳定运行后先触发 Savepoint。命令完成时会返回真实路径,把它保存为后续恢复使用的 <SAVEPOINT_PATH>。
FLINK_HOME="<PATH>"
JOB_ID="<ID>"
SAVEPOINT_DIR="<PATH>"

"$FLINK_HOME/bin/flink" savepoint "$JOB_ID" "$SAVEPOINT_DIR"
预期输出
Savepoint completed. Path: <SAVEPOINT_PATH>随后取消旧作业,并从该 Savepoint 以并行度 4 启动。扩缩容期间不要修改 sum-with-ttl-v1 的 UID 或 maxParallelism。
FLINK_HOME="<PATH>"
JOB_ID="<ID>"
JOB_JAR="<PATH>/state-ft-lab.jar"
SAVEPOINT_PATH="<PATH>/savepoint-<ID>"

"$FLINK_HOME/bin/flink" cancel "$JOB_ID"
"$FLINK_HOME/bin/flink" run -d -p 4 -s "$SAVEPOINT_PATH" -c com.example.StatefulFaultToleranceJob "$JOB_JAR" localhost:9092 input-state-ft output-state-ft file:///tmp/flink-state-ft-checkpoints
预期结果
旧作业进入 CANCELED。
新作业提交成功,JobID 为 <ID>。
恢复后继续向 alice 和其他 key 写入数据。如果 alice 在 TTL 到期前继续写入,新的累计值应接着 120 增长;如果超过 2 分钟没有写入导致状态过期,下一条 alice 事件会从空状态重新累计。至此,Checkpoint 负责故障恢复,Savepoint 负责受控迁移,稳定 UID 与 max parallelism 负责状态映射,而 Kafka 事务 Sink 负责把端到端 Exactly-Once 落到可观察结果上。