
大数据与流处理 / 系统课时
规划检查点存储与本地恢复
规划检查点存储与本地恢复
检查点要解决的是“节点丢了还能恢复”,本地恢复解决的是“节点还在时恢复得更快”。这两者不能互相替代。本节把持久化检查点目录、保留策略和 task-local recovery 放在同一张恢复链路里规划,避免把高速本地盘误当成容灾存储。
学习目标
- 区分状态后端、Checkpoint Storage 与本地恢复副本的职责
- 为生产作业选择可共享、可持久化的检查点目录和保留策略
- 判断 task-local recovery 能否缩短恢复时间,以及它会增加哪些磁盘成本
先把三种存储角色分开
状态后端决定运行时状态怎样组织和访问;Checkpoint Storage 决定检查点快照最终持久化到哪里;task-local recovery 则在 TaskManager 本地保留可复用的 keyed state 文件,作为恢复加速路径。生产容灾必须依赖前两者中的持久化检查点,而不能依赖本地副本。
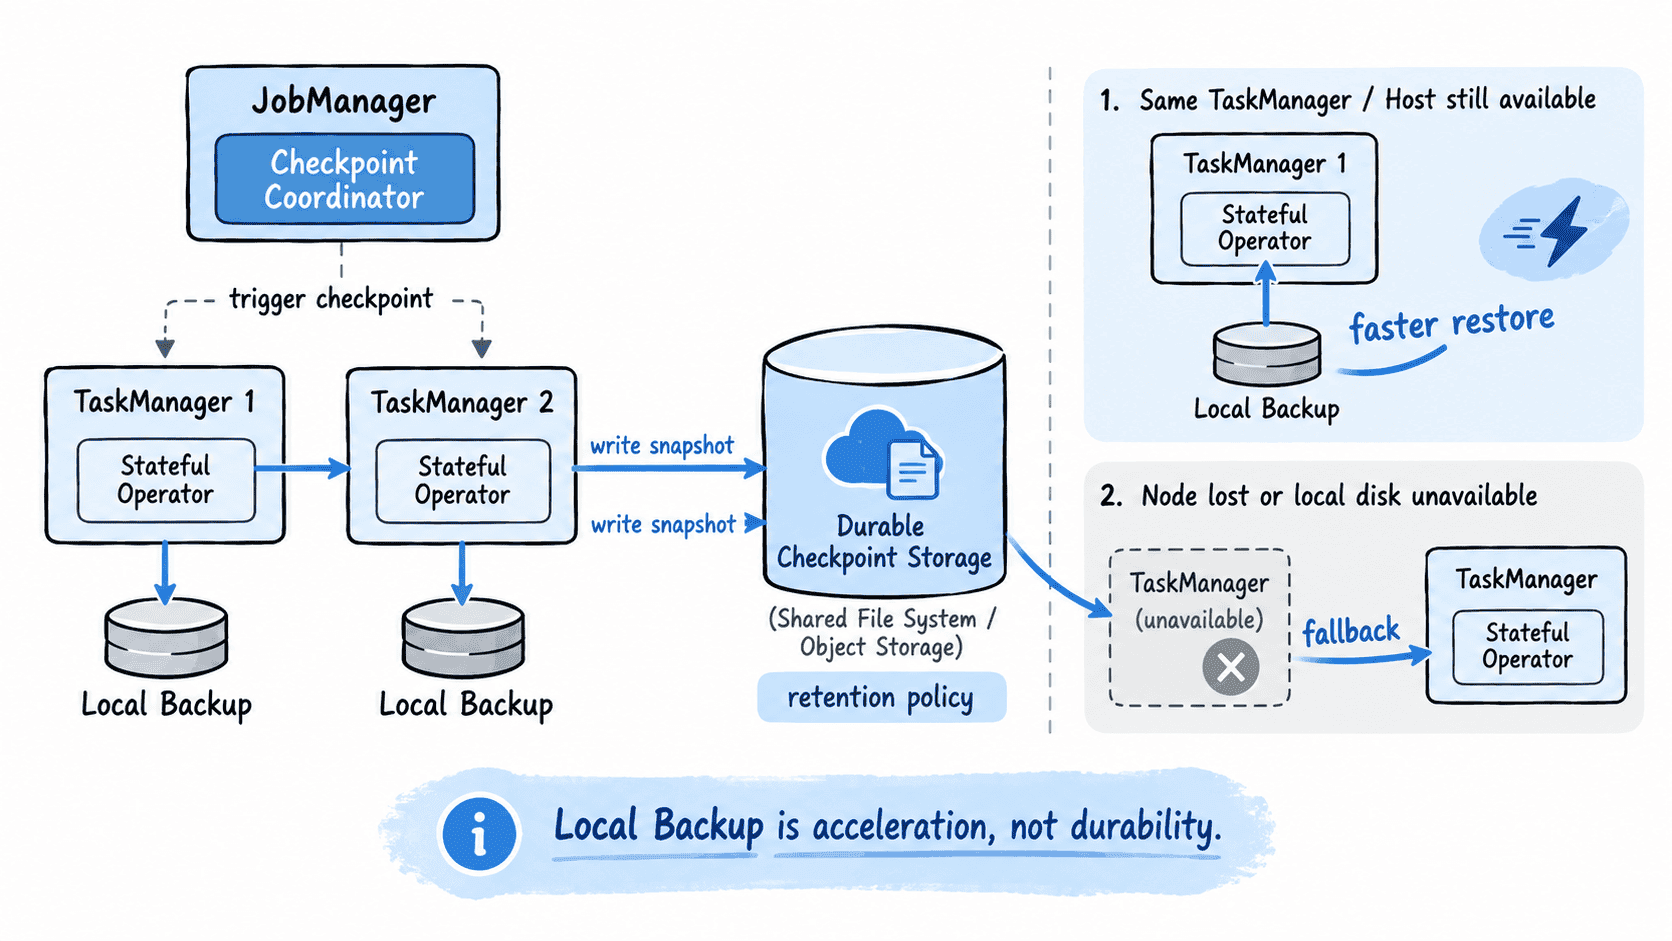
持久化目录必须能被所有参与恢复的 JobManager 和 TaskManager 访问,并且在单机、进程或节点故障后仍然存在。因此生产环境通常使用 HDFS、对象存储或其他真正共享且持久化的文件系统;普通节点上的 file:///... 目录不具备这个前提。
规划目录与保留策略
检查点根目录应按环境和权限域规划,例如生产与测试分开、不同团队使用不同前缀,并为 Flink 运行身份配置最小读写权限。不要把 savepoint、业务数据和临时文件混在同一路径下,否则清理策略很容易误删恢复资产。
execution.checkpointing.num-retained 控制作业运行期间最多保留多少个已完成检查点。数量越高,回退窗口越大,但远端存储占用也会上升。若选择在取消作业后继续保留 externalized checkpoint,则必须把人工或自动清理流程一起设计好,否则“保留用于救急”会变成长期堆积。
配置持久化检查点与本地恢复
下面给出一组适合作为生产评审起点的配置。<BUCKET> 是实际对象存储桶占位符,本地目录应替换为 TaskManager 节点上的独立数据盘路径。
execution.checkpointing.interval: 30 s
execution.checkpointing.storage: filesystem
execution.checkpointing.dir: s3://<BUCKET>/flink-checkpoints
execution.checkpointing.num-retained: 3
execution.checkpointing.externalized-checkpoint-retention: RETAIN_ON_CANCELLATION
execution.checkpointing.local-backup.enabled: true
execution.checkpointing.local-backup.dirs: /data/flink-local
这段配置的生效行为是:检查点状态与元数据进入共享文件系统;正常运行时最多保留三个已完成检查点;取消作业后 externalized checkpoint 仍保留;同时为支持本地恢复的 keyed state 保存本地备份。实际对象名、作业 ID 和检查点 ID 都会变化。
本地恢复会额外占用 TaskManager 磁盘和 I/O,因此 /data/flink-local 不能只按“当前工作状态大小”预留空间。还要为本地备份、状态后端自己的本地文件、峰值 checkpoint 活动以及磁盘水位留出余量,并建立磁盘告警。
用故障场景验证设计
验证时不要只看一次 checkpoint 是否显示 COMPLETED,而要覆盖恢复路径。先让作业稳定产生多个检查点并记录远端目录增长;随后触发一次不会丢失本地盘的 Task 失败,观察恢复是否能复用本地状态;最后模拟节点丢失或把任务调度到其他节点,确认它仍能从持久化检查点恢复。
如果同节点失败很快、跨节点恢复也能成功,说明“本地加速 + 远端兜底”的层次成立。若关闭本地盘就无法恢复,说明检查点目录没有真正持久化或不可被新节点访问;若恢复一直从远端读取,本地恢复命中率低,则需要检查调度位置、本地目录生命周期和节点重建策略。
task-local recovery 只覆盖 keyed state,并且只有本地文件仍在、恢复任务能够利用这些文件时才有收益。在会频繁销毁节点本地盘的容器环境里,它的命中机会可能较低;这时应优先保证远端检查点吞吐与恢复带宽,再决定是否值得为本地副本支付磁盘成本。