
大数据与流处理 / 系统课时
验证端到端 Exactly-Once
验证端到端 Exactly-Once
Checkpoint 能保证 Flink 内部状态在故障后回到一致位置,但这还不等于外部结果没有重复或丢失。端到端 Exactly-Once 必须让 source 的读取位置、算子状态和 sink 的提交协议共同对齐到同一次成功 Checkpoint,并用真实故障验证。
学习目标
- 区分 Flink 内部状态一致性与端到端 Exactly-Once
- 用 Kafka source、键控状态和事务型 Kafka sink 组成可验证链路
- 通过故障前后数据与
read_committed结果判断是否出现重复或丢失
三段必须对齐到同一个 Checkpoint
端到端 Exactly-Once 至少要求三件事同时成立:source 能在恢复时回到已确认的读取位置;算子状态能恢复到同一 Checkpoint;sink 能把未完成 Checkpoint 对应的外部写入隐藏、回滚或去重,并只提交已经完成的那一批结果。
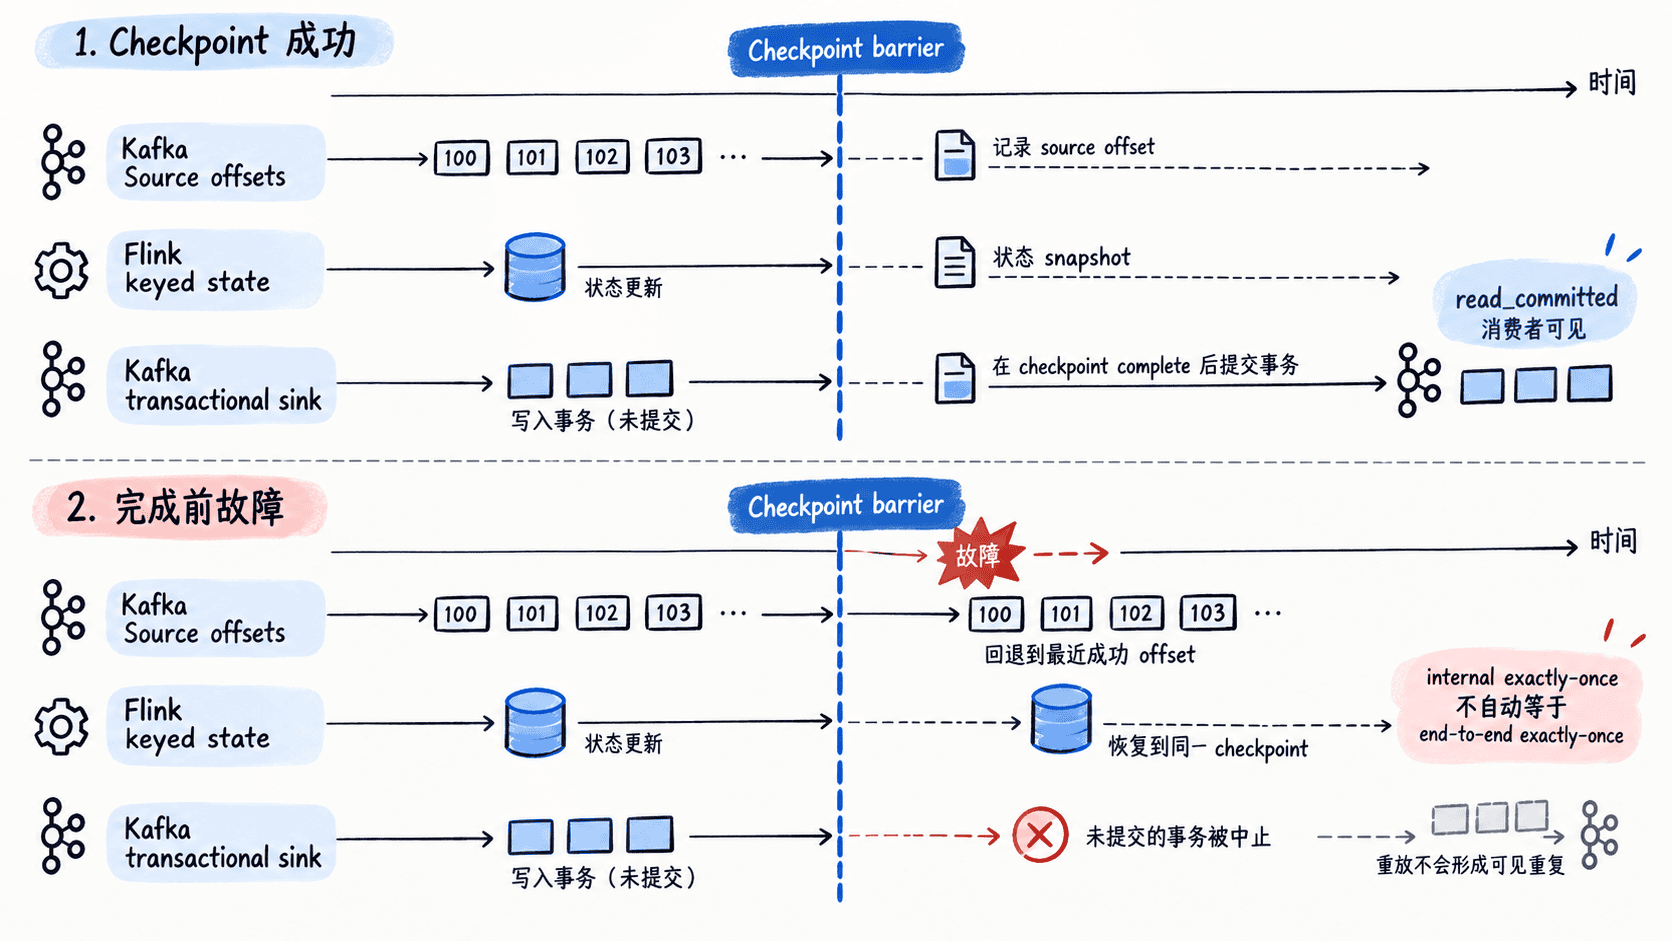
Kafka Source 的关键点是:故障恢复依赖 Flink Checkpoint 中保存的分区 offset,而不是把 Kafka consumer group 的已提交 offset 当作唯一恢复依据。Kafka Sink 使用事务保证某个 Checkpoint 之前的结果要么整体对 read_committed 消费者可见,要么在失败后保持不可见。
用一个有状态作业建立验证链路
下面的完整示例把输入行 用户,事件 读取为 (用户, 1),按用户聚合计数,再写入事务型 Kafka Sink。sum(1) 使用键控状态,因此一次故障能够同时检验 source 位置、内部状态和 sink 提交。为便于核对输出,示例把并行度固定为 1。
运行前需要准备匹配 Flink 运行时版本的 Kafka Connector,并创建空的单分区主题 eo-input 与 eo-output。集群还必须允许作业在 TaskManager 故障后自动重启;Kafka broker 的事务超时应大于一次可能的 Checkpoint 加故障恢复窗口。
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.api.common.typeinfo.Types;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.connector.base.DeliveryGuarantee;
import org.apache.flink.connector.kafka.sink.KafkaRecordSerializationSchema;
import org.apache.flink.connector.kafka.sink.KafkaSink;
import org.apache.flink.connector.kafka.source.KafkaSource;
import org.apache.flink.connector.kafka.source.enumerator.initializer.OffsetsInitializer;
import org.apache.flink.streaming.api.CheckpointingMode;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class ExactlyOnceKafkaDemo {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();

        // 固定单并行度只为让实验输出顺序可直接核对。
        env.setParallelism(1);
        env.enableCheckpointing(10_000, CheckpointingMode.EXACTLY_ONCE);
        env.getCheckpointConfig().setCheckpointTimeout(60_000);

        KafkaSource<String> source = KafkaSource.<String>builder()
                .setBootstrapServers("<HOST>:<PORT>")
                .setTopics("eo-input")
                .setGroupId("eo-demo")
                .setStartingOffsets(OffsetsInitializer.earliest())
                .setValueOnlyDeserializer(new SimpleStringSchema())
                .build();

        KafkaSink<String> sink = KafkaSink.<String>builder()
                .setBootstrapServers("<HOST>:<PORT>")
                .setRecordSerializer(
                        KafkaRecordSerializationSchema.builder()
                                .setTopic("eo-output")
                                .setValueSerializationSchema(new SimpleStringSchema())
                                .build())
                // 同时运行多个作业实例时,前缀必须彼此唯一,避免事务 fencing。
                .setTransactionalIdPrefix("eo-demo-")
                .setDeliveryGuarantee(DeliveryGuarantee.EXACTLY_ONCE)
                .build();

        env.fromSource(source, WatermarkStrategy.noWatermarks(), "kafka-source")
                .map(
                        value -> {
                            String[] parts = value.split(",", 2);
                            return Tuple2.of(parts[0], 1L);
                        },
                        Types.TUPLE(Types.STRING, Types.LONG))
                .keyBy(value -> value.f0)
                .sum(1)
                .map(value -> value.f0 + "," + value.f1)
                .sinkTo(sink);

        env.execute("exactly-once-kafka-demo");
    }
}
预期结果
作业保持 RUNNING;业务结果不会打印到标准输出,而是等待 Checkpoint 完成后以已提交事务写入 eo-output。在 Checkpoint 两侧注入故障
先向输入主题写入四条记录。<HOST> 与 <PORT> 替换为实际 Kafka 地址。
printf 'alice,a\nalice,b\nbob,c\nalice,d\n' | \
  kafka-console-producer.sh \
  --bootstrap-server <HOST>:<PORT> \
  --topic eo-input
预期输出
<无业务输出;命令成功结束>确认前四条记录已经被处理,并等待其后的至少一个 Checkpoint 显示为 COMPLETED,然后终止一个承载该作业的 TaskManager,并确认作业已经自动恢复为 RUNNING。不同部署方式的故障注入命令不同,不应为了统一示例伪造一条通用命令。
恢复完成后再写入两条记录,并等待下一次 Checkpoint 完成,使对应 Kafka 事务提交。
printf 'bob,e\nalice,f\n' | \
  kafka-console-producer.sh \
  --bootstrap-server <HOST>:<PORT> \
  --topic eo-input
预期输出
<无业务输出;命令成功结束>最后从头读取输出主题,但只读取已经提交的事务。单分区、单并行度前提下,六条输入应对应六条可见输出。
kafka-console-consumer.sh \
  --bootstrap-server <HOST>:<PORT> \
  --topic eo-output \
  --from-beginning \
  --max-messages 6 \
  --consumer-property isolation.level=read_committed
预期输出
alice,1
alice,2
bob,1
alice,3
bob,2
alice,4
用三类证据判断是否成立
验证时不能只看“作业恢复成功”。source 证据是故障后没有跳过输入,也没有从错误位置继续;状态证据是 alice 从 3 继续到 4、bob 从 1 继续到 2,而不是计数重置;sink 证据是 read_committed 只看到六条最终已提交记录,没有因重放出现额外重复。
如果改用不支持事务或幂等提交的外部 sink,即使 Flink 内部仍以 EXACTLY_ONCE 做 Checkpoint,外部系统也可能看到重复写入。同样,如果消费者使用 read_uncommitted,它可能看到尚未完成 Checkpoint 的 Kafka 事务数据,这不能作为端到端 Exactly-Once 的验收口径。
端到端语义的验收标准应落到外部可观察结果:在真实故障发生后,source 能重放、状态能回滚到一致点、sink 能屏蔽未提交结果,三者缺一都只能算局部一致性。