
大模型应用开发 / 系统课时
采集网页知识
采集网页知识
本课解决 RAG 知识库接入网页资料时噪声过多的问题,通过抓取网页正文、清理无关元素,并保存标题、地址和更新时间等信息,构建适合后续检索的网页知识来源。
学习目标
- 理解网页采集在 RAG 数据准备阶段的作用。
- 掌握网页抓取与正文清洗的基本流程。
- 学会保存网页来源信息,提升检索结果可追溯性。
网页采集在知识库中的流程
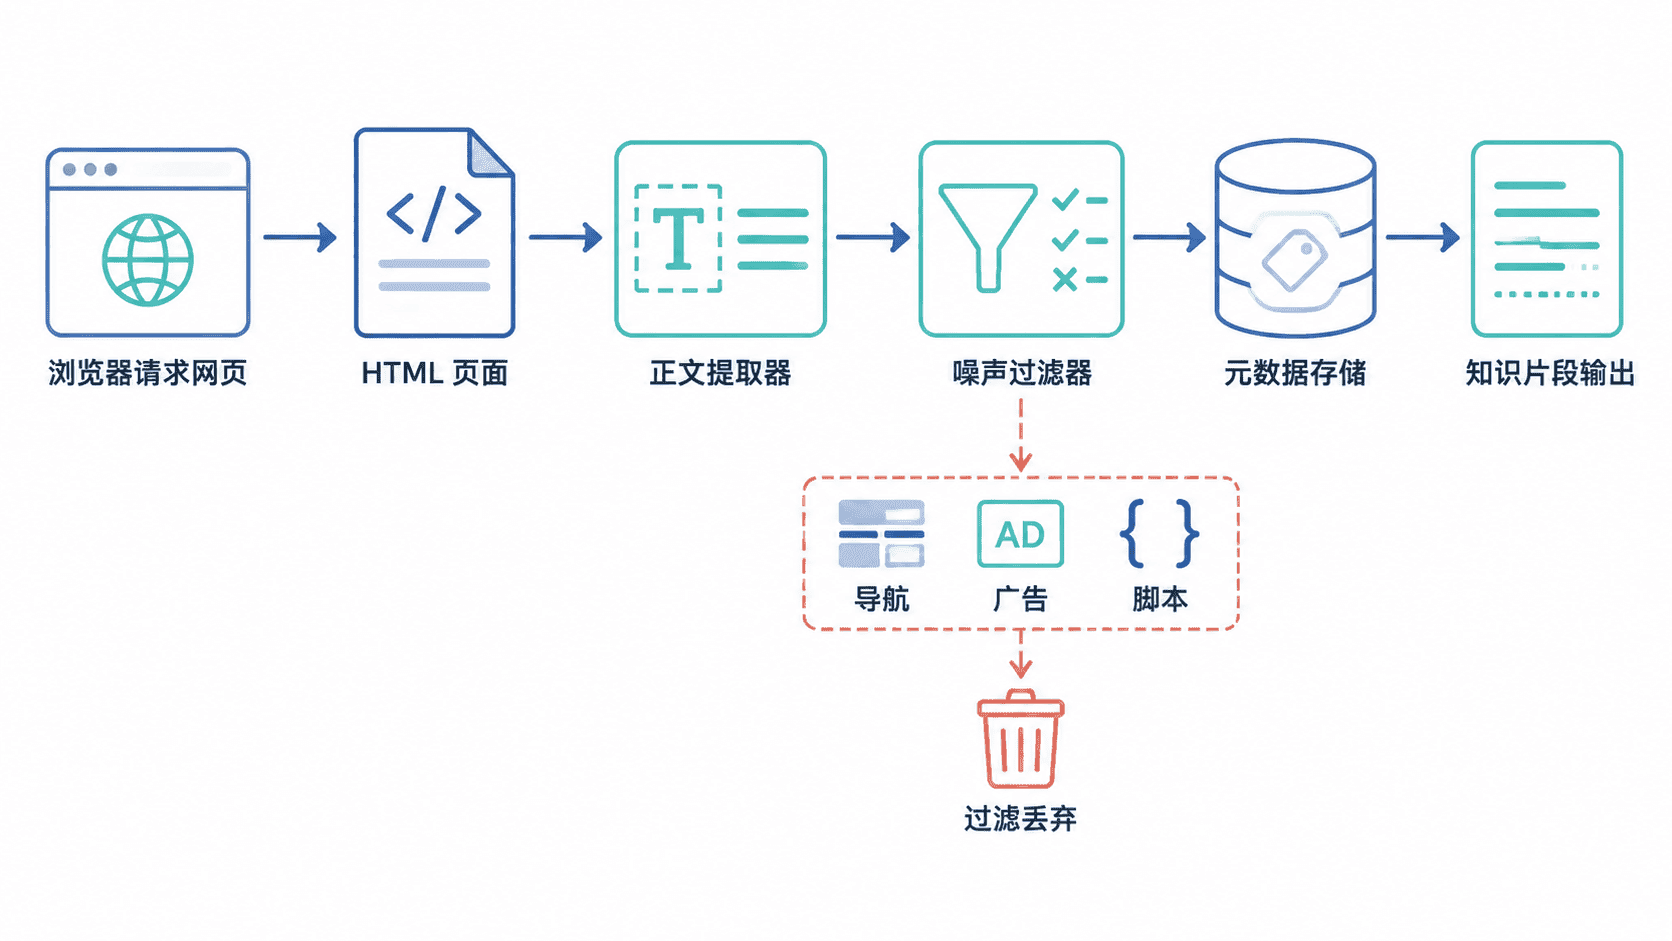
网页内容通常包含正文、导航菜单、广告、脚本、版权声明等大量非知识信息。如果直接把 HTML 转换为文本,会产生大量无效片段,影响向量检索质量。
一个完整网页采集流程通常包括请求页面、解析 HTML、提取正文、清理噪声、保存元数据几个步骤。
使用 Python 抓取网页内容
网页采集需要考虑访问频率、编码格式和异常响应。简单场景可以使用 requests 获取 HTML,再通过解析器提取文本。
下面示例展示基础采集过程,实际生产环境通常还需要增加 robots.txt 检查、缓存和重试机制。
python
import requests
from bs4 import BeautifulSoup

url = "https://example.com"
response = requests.get(url, timeout=10)
response.raise_for_status()

# 提取页面可见文本,去除 HTML 标签
soup = BeautifulSoup(response.text, "html.parser")
content = soup.get_text(" ", strip=True)

result = {
    "title": soup.title.text if soup.title else "",
    "url": url,
    "content": content
}

print(result["title"])
预期输出
text
Example Domain示例中的 URL 仅用于演示请求流程,实际项目应替换为允许采集的目标地址。
清理网页噪声并保留元数据
网页正文提取不能只关注文本数量,更重要的是保留内容上下文。标题可以帮助判断主题,更新时间可以辅助处理过期知识,URL 可以作为回答引用来源。常见保存字段包括:
| 字段 | 作用 |
|---|---|
| title | 标识页面主题 |
| url | 定位原始来源 |
| updatedAt | 判断内容新旧 |
| content | 参与切片和检索 |
清洗阶段通常会删除 script、style、导航菜单和重复区域,只保留用户真正阅读的信息。
网页采集的边界与失败处理
网页采集可能遇到动态渲染、访问限制和页面结构变化。普通 HTTP 请求只能获取服务器返回的 HTML,依赖 JavaScript 生成内容的网站可能需要浏览器自动化工具。
当采集失败时,应先确认响应状态码、页面编码和解析规则,而不是直接增加重试次数。错误的数据进入知识库,会比采集失败带来更大的问题。
按自己的节奏,确认真正理解。