
大模型应用开发 / 系统课时
容器化项目服务
容器化项目服务
本节将完成 RAG 知识库项目的容器化部署,把 API 服务、向量数据库和依赖组件放入统一运行环境中。通过 Docker Compose 管理网络、数据持久化、环境变量和启动顺序,使项目可以稳定迁移到测试或生产环境。
学习目标
- 理解 RAG 服务容器化时需要拆分的组件边界
- 掌握 Docker Compose 管理服务网络、卷和环境变量的方法
- 能够验证容器启动状态并处理常见启动依赖问题
容器化 RAG 项目的整体结构
RAG 应用通常包含多个运行单元,例如提供接口的 API 服务、保存向量数据的向量数据库,以及负责存储配置的环境层。容器化的核心不是简单打包代码,而是明确每个服务的运行边界。
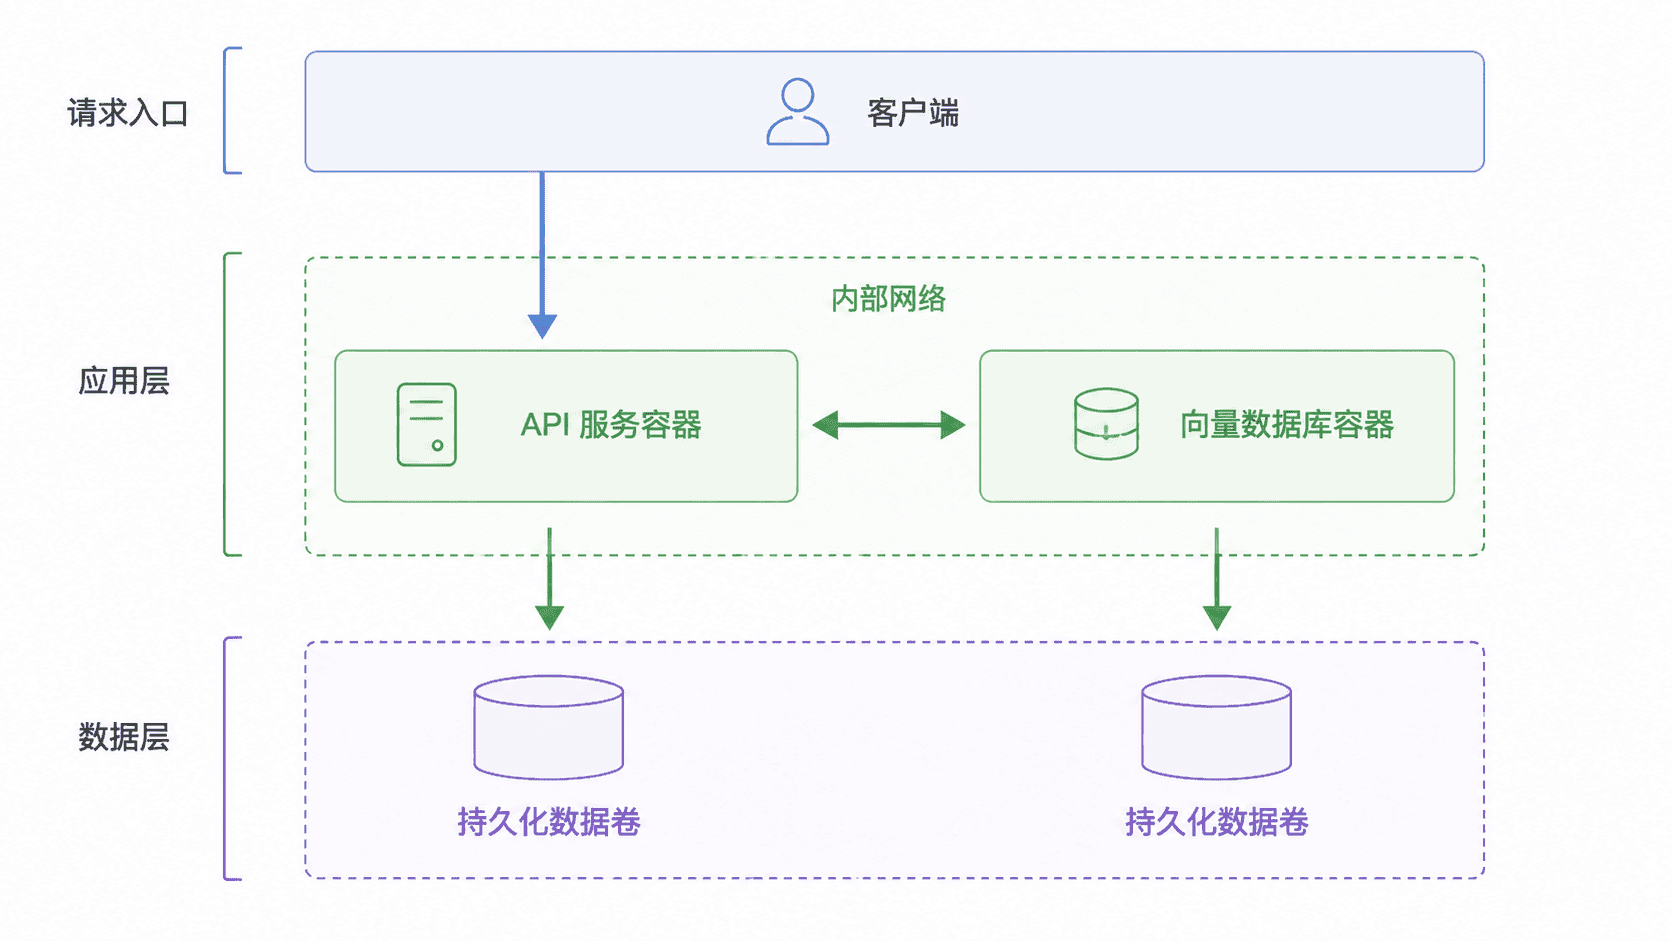
API 容器负责接收查询请求并调用检索、生成流程;向量数据库容器负责保存和检索 embedding 数据。两个容器通过 Docker 网络通信,数据通过 Volume 保留,避免容器删除导致索引丢失。
使用 Docker Compose 定义运行环境
Docker Compose 适合描述多服务应用。它可以统一声明镜像、端口、环境变量、网络和启动依赖,让开发和部署环境保持一致。
services:
  api:
    build: ./api
    ports:
      - "<PORT>:8000"
    environment:
      VECTOR_DB_URL: http://vector-db:6333
    depends_on:
      - vector-db

  vector-db:
    image: qdrant/qdrant:latest
    volumes:
      - vector-data:/qdrant/storage

volumes:
  vector-data:
预期结果
Compose 配置文件成功定义 api 和 vector-db 两个服务。
api 服务可以通过 vector-db 服务名访问向量数据库。
这里使用服务名作为连接地址,而不是固定 IP。Docker Compose 会自动创建内部 DNS,使服务之间能够通过名称发现。
管理环境变量与敏感配置
RAG 服务通常依赖模型密钥、数据库地址、运行模式等配置。生产环境中不应该把敏感信息直接写入镜像或代码仓库。
docker compose --env-file <PATH> up -d预期输出
Container api Started
Container vector-db Started实际部署时,<PATH> 应替换为环境变量文件路径。通过外部配置注入,可以在不同环境复用同一套镜像。
验证容器运行状态
启动后需要确认服务是否正常运行,包括容器状态、网络连接和数据卷挂载。
docker compose ps预期输出
NAME             SERVICE       STATUS
api              api           running
vector-db        vector-db     running
如果 API 启动失败,应优先检查环境变量、依赖服务状态和日志,而不是直接重新创建容器。
常见启动问题处理
容器化 RAG 项目常见问题包括端口冲突、数据库未就绪和数据卷权限错误。排查顺序应从基础环境到应用依赖逐层确认。
端口冲突可以修改映射端口;数据库未启动可以检查 depends_on 配置和健康检查;数据卷异常则需要确认宿主机权限和挂载路径。