
大模型应用开发 / 系统课时
构建增量接入流程
构建增量接入流程
本节解决知识库重复处理效率低的问题,通过文件指纹、更新时间和处理状态记录判断哪些文档发生变化,只对新增或修改内容执行解析、切分和向量化。
学习目标
- 理解增量接入相比全量处理的核心区别
- 掌握基于文件指纹判断文档变化的方法
- 能够设计简单可靠的增量同步流程
增量接入的核心思路
知识库数据持续变化,如果每次同步都重新读取全部文件,会造成大量重复解析和向量计算。增量接入的目标是识别变化集合,只处理新增、修改或删除的知识源。
常见判断依据包括文件路径、修改时间、文件大小和内容哈希。其中内容指纹最可靠,因为文件名不变时,内容仍可能被修改。
使用文件指纹记录变化
文件指纹通常保存文档当前状态。当下一次扫描知识源时,将新计算的指纹与历史记录比较,决定是否进入后续处理流程。
下面示例使用 Python 模拟文档扫描和指纹计算流程。
python
import hashlib
from pathlib import Path

def calculate_fingerprint(file_path):
    # 使用内容哈希保证同内容文件具有相同指纹
    content = Path(file_path).read_bytes()
    return hashlib.sha256(content).hexdigest()

document = "<PATH>/guide.md"
fingerprint = calculate_fingerprint(document)

print(fingerprint)
预期输出
text
8f3a9c6d2e7b1a5f4c0d8e9a7b6c5d4e3f2a1b0c9d8e7f6a5b4c3d2e1f0a9实际哈希值会根据文件内容变化,不同文档通常具有不同指纹。
设计增量处理流程
一个完整的增量接入流程通常包含扫描、比较、处理和更新四个阶段。扫描阶段发现候选文件,比较阶段判断变化类型,处理阶段执行解析与向量化,最后更新状态记录。
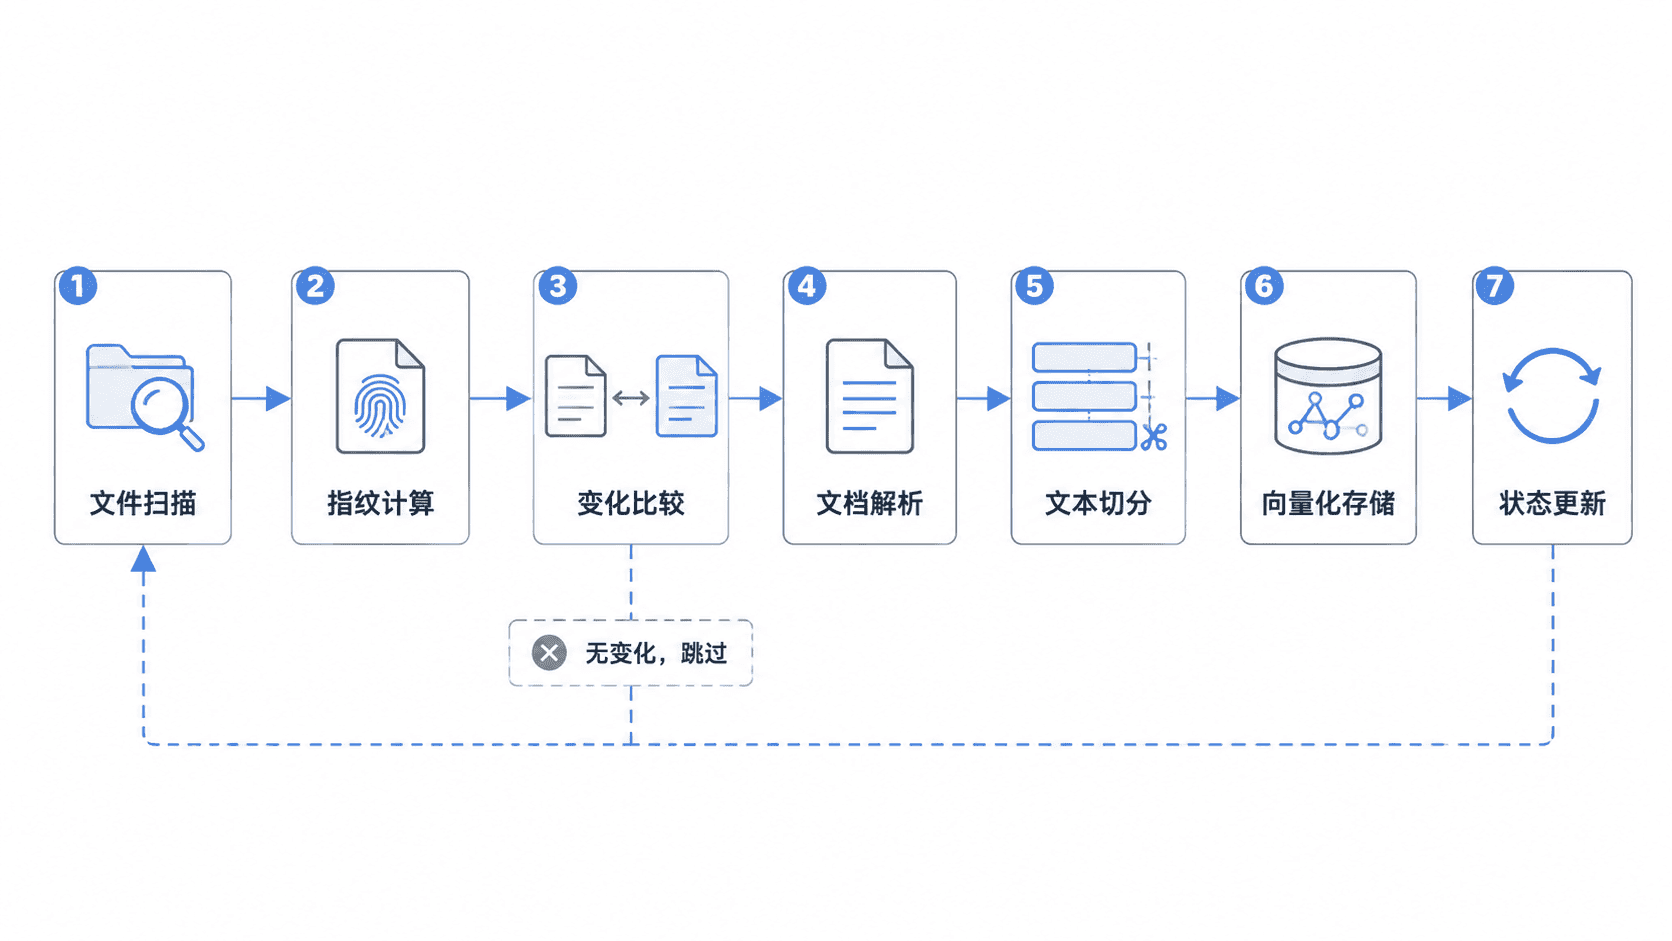
在生产环境中,还需要保存文档状态,例如最后处理时间、版本号和向量库记录 ID,便于后续更新或删除。
增量接入的边界处理
仅依赖更新时间可能导致漏检,因为部分系统会保留原始时间信息。仅依赖哈希虽然准确,但需要读取完整文件,处理超大文件时成本较高。
实际项目通常组合多个字段:先用更新时间和大小快速筛选,再使用哈希确认内容变化,在准确性和性能之间取得平衡。
按自己的节奏,确认真正理解。