
大模型应用开发 / 系统课时
记录链路追踪数据
记录链路追踪数据
本课学习如何记录 RAG 系统运行过程中的关键数据。通过保存查询改写、检索候选、重排结果、模型输入输出和耗时信息,可以快速定位效果下降与性能瓶颈。
学习目标
- 理解 RAG 全链路追踪需要记录的信息
- 掌握设计追踪事件的数据结构
- 学会利用追踪数据分析质量和性能问题
RAG 链路中的关键阶段
一次完整的 RAG 请求通常经过多个阶段:用户提问、查询改写、向量检索、结果重排、上下文拼接、模型生成和结果返回。
每个阶段都可能影响最终答案质量,因此需要记录输入、输出和耗时信息。
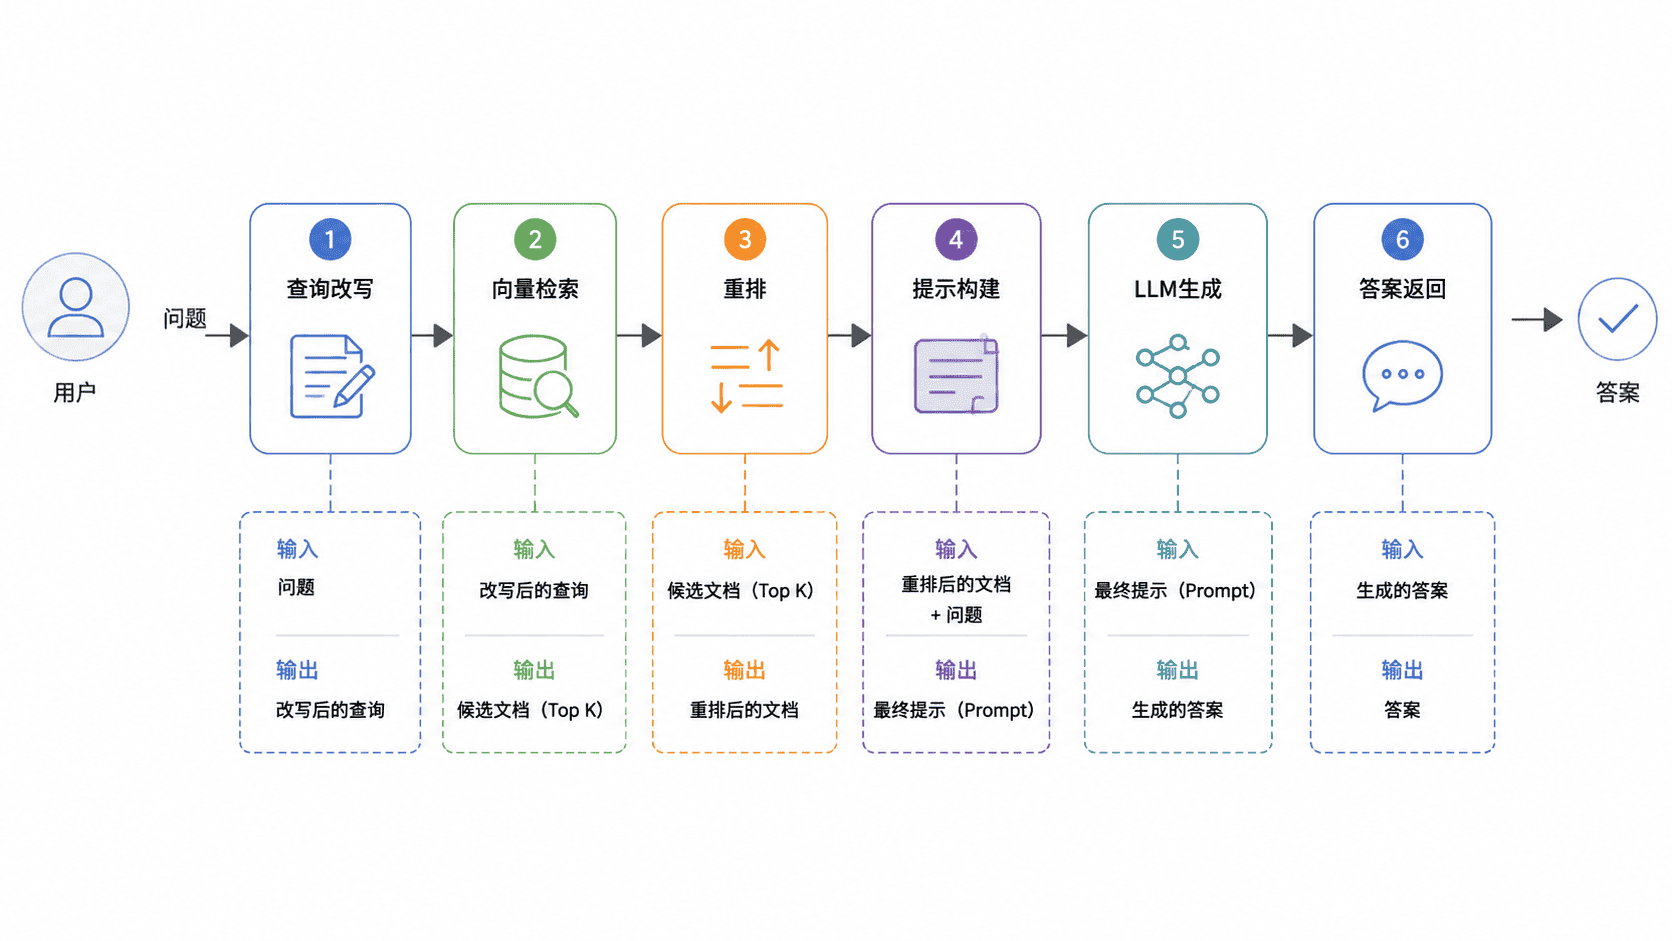
追踪数据不仅用于排查错误,也能帮助发现哪些阶段消耗时间最多,哪些阶段导致答案质量下降。
设计追踪事件结构
可以为每次请求生成唯一 ID,并记录各阶段事件。
python
import time
import uuid

trace_id = str(uuid.uuid4())
event = {
    "traceId": trace_id,
    "stage": "retrieval",
    "durationMs": 120,
    "candidateCount": 5
}

print(event)
预期输出
text
{'traceId': '<ID>', 'stage': 'retrieval', 'durationMs': 120, 'candidateCount': 5}实际项目中还需要记录查询改写前后的文本、召回文档 ID、重排分数、模型使用的令牌数量以及最终响应。
分析链路数据
通过追踪数据,可以快速回答几个关键问题:
- 用户问题是否被正确改写
- 检索结果是否包含有效证据
- 重排是否提升了相关内容排序
- 模型生成是否超出上下文范围
- 哪个阶段耗时最长
例如发现答案错误时,可以先查看检索阶段是否召回正确文档,再判断是否需要调整提示词或模型参数。
保存与管理注意事项
链路日志应避免直接保存敏感用户信息。生产环境通常需要进行脱敏处理,并设置合理的数据保留周期。
同时建议统一字段名称,方便后续接入日志系统、指标平台或质量分析工具。
按自己的节奏,确认真正理解。