
大模型应用开发 / 系统课时
认识 RAG 工作流程
认识 RAG 工作流程
RAG(Retrieval-Augmented Generation,检索增强生成)通过先检索外部知识,再让大模型基于相关内容生成答案,解决模型知识过期、私有数据无法直接使用等问题。本节将完整拆解一次 RAG 请求从输入问题到返回答案的执行链路。
学习目标
- 理解 RAG 系统中查询、检索、上下文组装和生成的完整流程。
- 掌握用户问题与知识库内容之间的数据流关系。
- 能够识别 RAG 项目中的主要组件职责。
RAG 解决的问题
大语言模型擅长理解和生成文本,但它的知识来源通常固定在训练阶段,无法自动获取企业内部文档、产品资料或实时业务数据。当用户询问这些未知信息时,模型可能无法回答,甚至生成不准确内容。
RAG 的核心思路是把外部知识库作为模型生成前的参考来源。系统先找到与问题相关的信息,再把这些信息放入提示词,让模型基于已有上下文完成回答。
RAG 请求链路
一次典型 RAG 请求包含五个阶段:查询理解、知识检索、上下文组装、模型生成和结果返回。
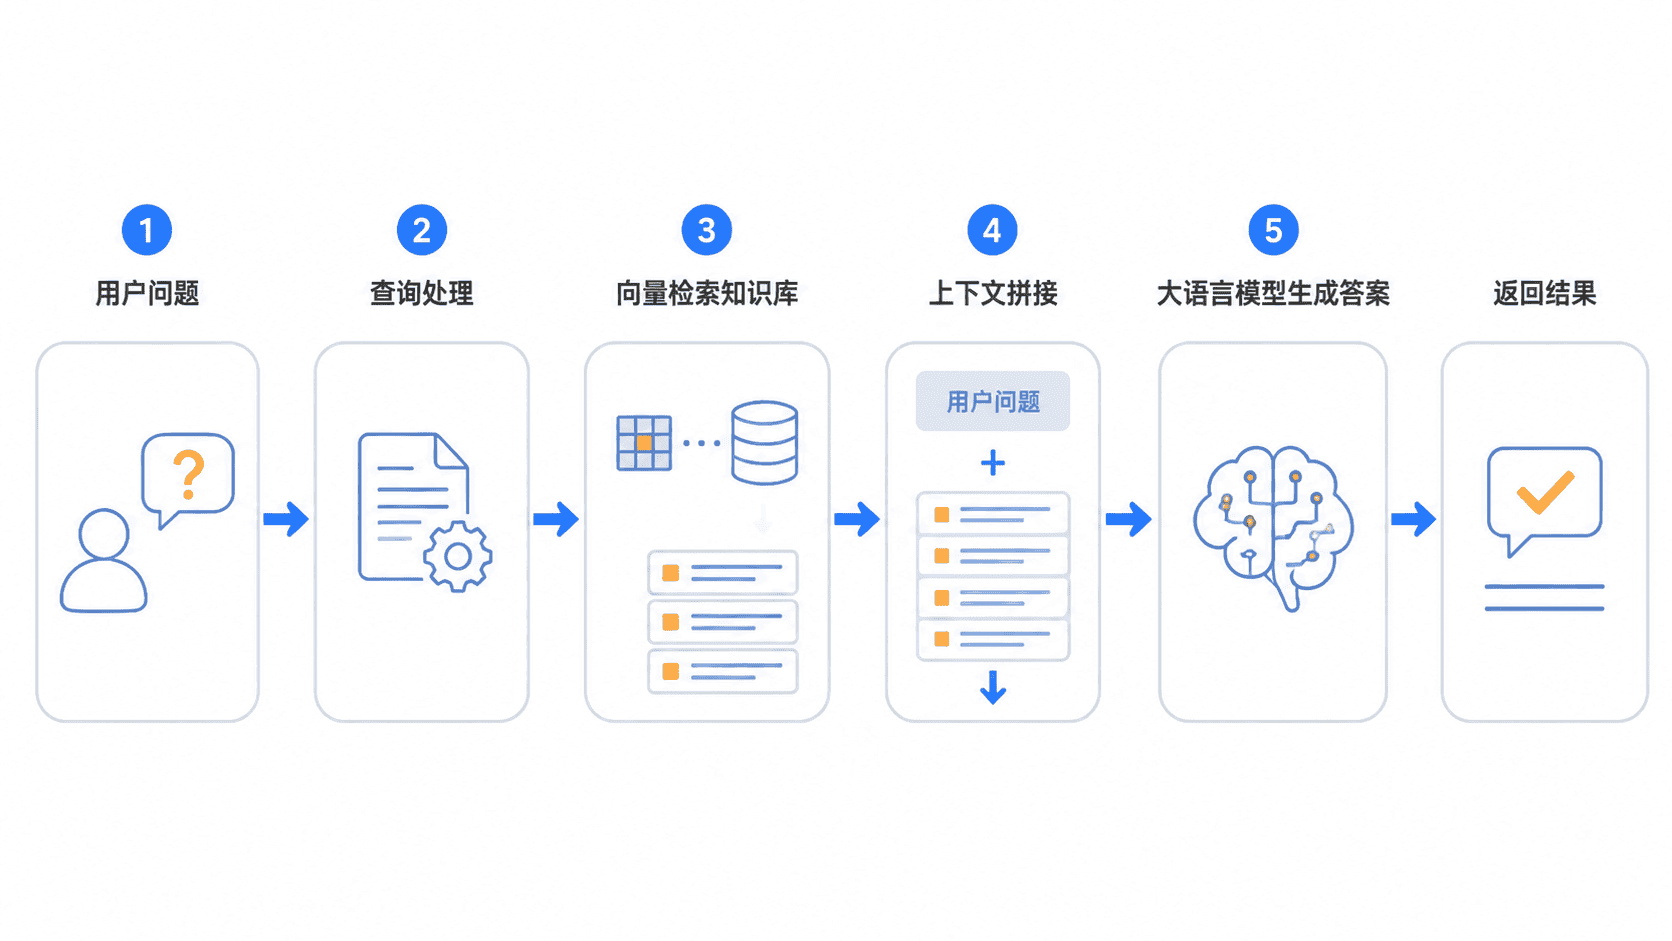
用户输入问题后,系统首先将问题转换为适合检索的表示形式,例如向量表示。检索组件根据相似度找到知识库中相关文档片段,然后把这些片段整理成模型可理解的上下文。
完成上下文组装后,应用会构造最终提示词,将用户问题和检索结果一起发送给大语言模型。模型根据这些材料生成最终答案。一个简单的 RAG 流程可以表示为:
question = "如何申请产品退款?"

# 检索阶段:从知识库找到相关文档片段
contexts = retrieve(question)

# 组装上下文后交给模型生成答案
answer = generate(question, contexts)

print(answer)
预期输出
根据退款政策,用户可以在订单完成后的 <TIME> 内提交退款申请。RAG 的核心组件
RAG 项目通常由知识库、检索系统、提示词模板和大语言模型组成。
知识库负责保存原始资料,例如 Markdown 文档、网页内容、数据库记录或 PDF 文件。检索系统负责从大量资料中找到与当前问题最相关的信息。提示词模板负责控制上下文如何传递给模型,而模型负责理解和生成自然语言答案。
这些组件共同形成一个闭环:知识负责提供事实,检索负责找到依据,模型负责组织表达。
常见误区
RAG 并不是让模型重新学习新知识,它不会修改模型参数。它只是临时把外部信息加入当前请求,因此知识更新速度取决于知识库内容,而不是模型训练周期。
另一个常见误区是认为增加更多文档一定提升效果。实际上,错误分块、无关内容和低质量资料都会降低检索准确率。