
大模型应用开发 / 系统课时
实现流式问答接口
实现流式问答接口
本节实现 RAG 系统中的流式问答接口,将检索、生成和响应传输连接起来。用户发送问题后,服务会持续返回模型生成内容,并正确处理连接断开、异常和结束事件。
学习目标
- 理解 RAG 流式响应接口的工作流程。
- 掌握服务端事件流接口的基本实现方式。
- 学会处理生成过程中的异常和连接状态。
设计流式问答流程
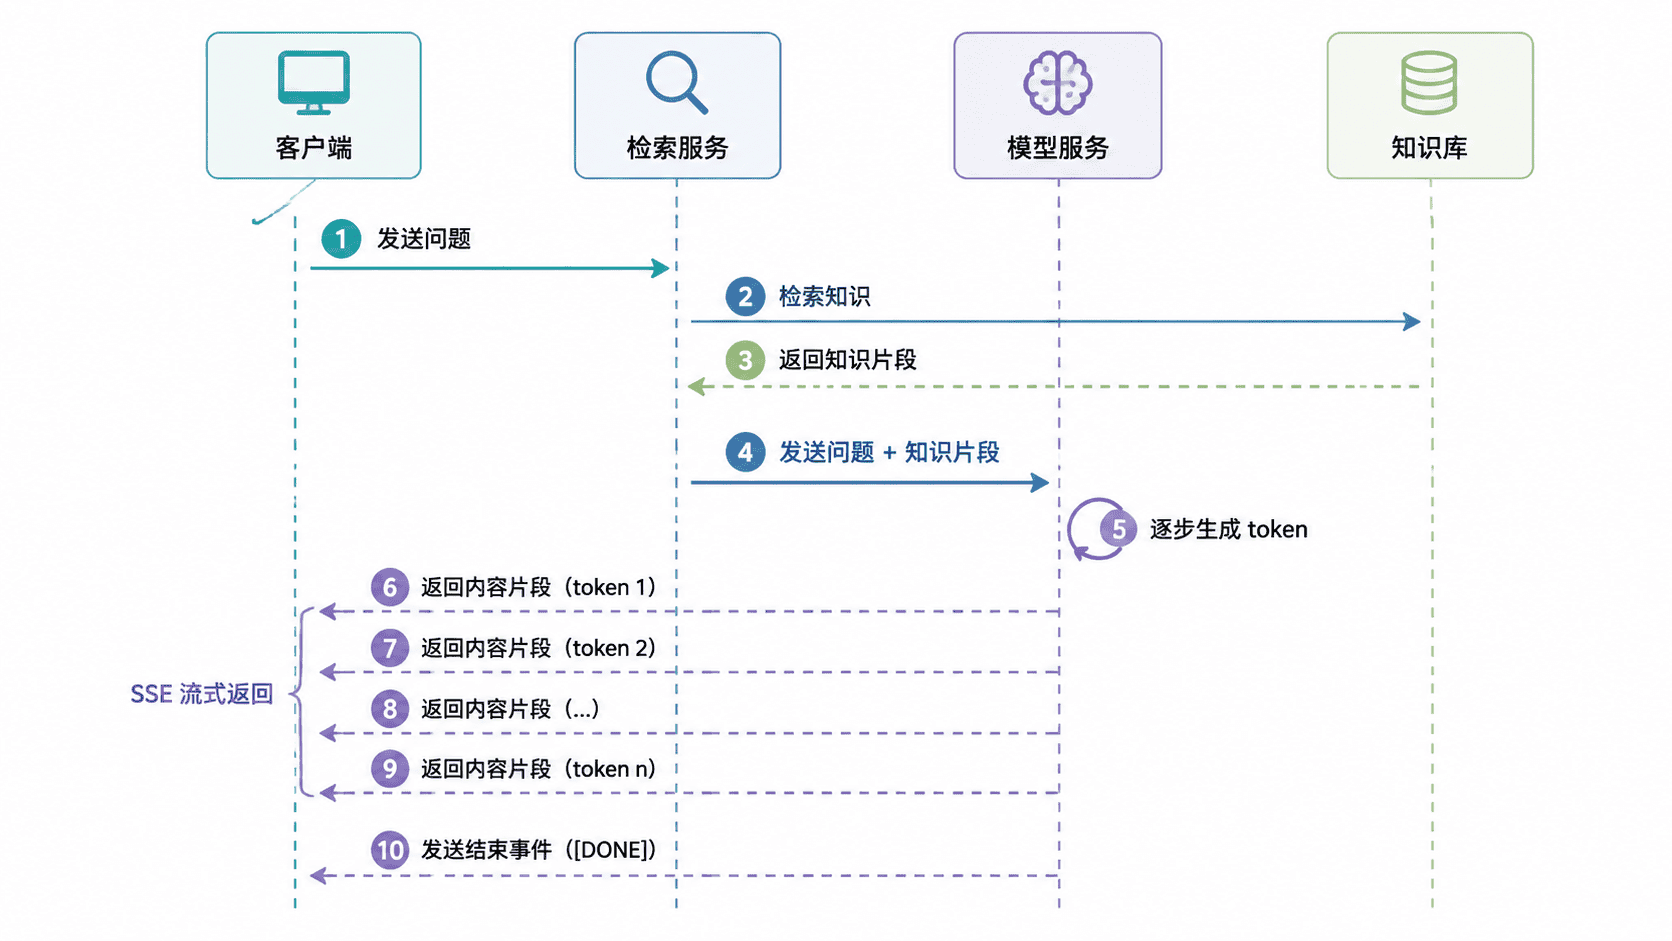
普通问答接口需要等待模型完整生成后一次返回结果,响应时间较长。流式接口则把生成过程拆分为多个数据片段,模型产生内容后立即发送给客户端。
在 RAG 场景中,服务通常先执行问题改写、向量检索和上下文拼接,再调用大模型生成答案。流式输出主要发生在最后的生成阶段。
实现 SSE 流式接口
下面使用 FastAPI 的 StreamingResponse 实现简单流式输出。示例中的生成函数模拟模型逐步返回内容,实际项目中可以替换为大模型 SDK 的 stream 调用。
python
from fastapi import FastAPI
from fastapi.responses import StreamingResponse
import asyncio

app = FastAPI()

async def generate_answer(question: str):
    # 实际项目中这里连接 RAG 检索结果和模型流式输出
    chunks = ["根据知识库", "检索结果", "生成答案"]
    for chunk in chunks:
        await asyncio.sleep(0.5)
        yield f"data: {chunk}\n\n"
    yield "event: end\ndata: done\n\n"

@app.get("/chat/stream")
async def chat_stream(question: str):
    return StreamingResponse(
        generate_answer(question),
        media_type="text/event-stream"
    )
预期结果
text
客户端建立连接后,会持续收到多个 SSE 数据事件:
data: 根据知识库

data: 检索结果

data: 生成答案

event: end
处理断开连接和异常
流式接口需要关注客户端提前关闭连接的情况。例如用户关闭页面后,服务仍继续生成内容会浪费计算资源。服务端应捕获取消异常,并及时停止后续生成任务。
模型调用失败时,不应直接关闭连接。可以发送错误事件,让客户端知道当前请求失败,而不是一直等待。
python
async def safe_stream(generator):
    try:
        async for item in generator:
            yield item
    except Exception:
        yield "event: error\ndata: generation failed\n\n"
预期结果
text
发生生成异常时,客户端收到 error 事件:
event: error
data: generation failed
设计客户端交互协议
流式接口通常采用 SSE 或 WebSocket。问答场景以单向持续输出为主时,SSE 更简单;需要双向实时通信、语音交互等场景时,可以选择 WebSocket。
接口协议需要明确事件类型,例如 message 表示内容片段,citation 表示引用来源,end 表示生成结束。这样客户端可以分别渲染答案、引用和状态。
验证流式问答效果
验证时需要检查三个方面:首字节响应时间、持续输出过程和结束事件。首字节越快,用户感受到的等待越短;结束事件能够帮助客户端关闭加载状态。
测试接口时可以使用支持流式显示的客户端,确认内容不是一次性返回,而是随着生成过程持续到达。
按自己的节奏,确认真正理解。