
大模型应用开发 / 系统课时
构建混合检索
构建混合检索
本课解决单一检索方式覆盖不足的问题,通过合并向量检索和关键词检索结果,构建更稳定的 RAG 召回链路,并使用排名融合策略生成统一候选列表。
学习目标
- 理解混合检索为什么能提升召回效果
- 掌握向量和关键词结果融合方法
- 完成基础混合检索流程设计
混合检索的核心思想
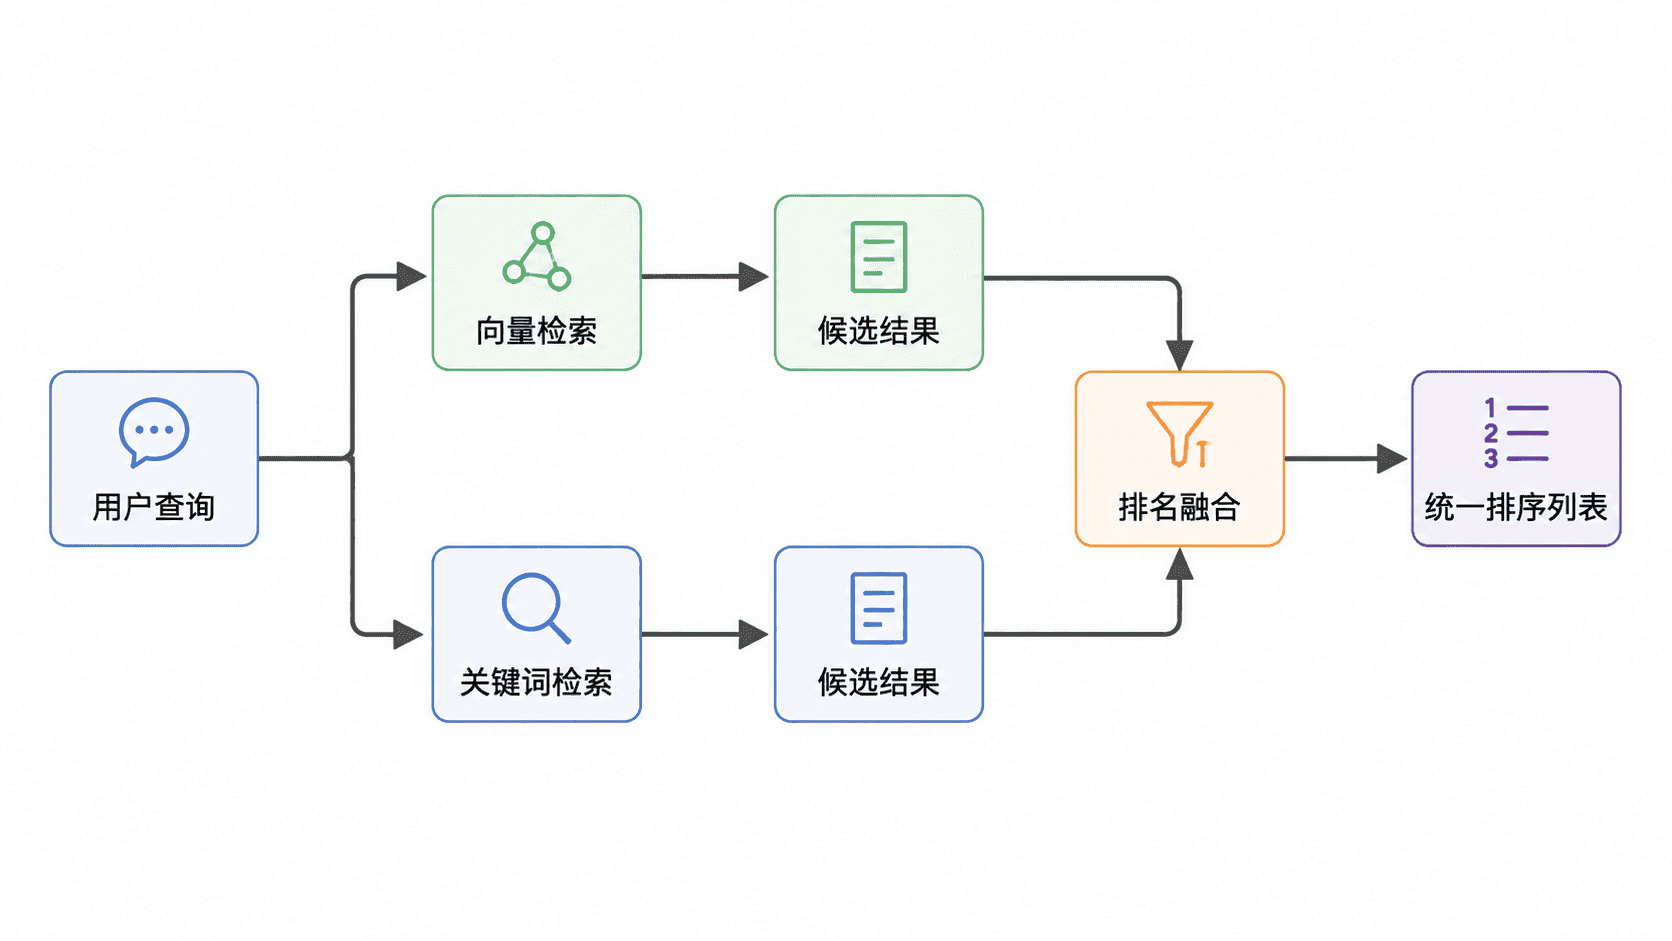
向量检索关注语义相似度,关键词检索关注文本精确匹配。两者解决的问题不同,将它们组合可以同时覆盖自然语言问题和精确实体查询。
例如用户搜索产品型号时,关键词检索能够找到准确编号文档;用户描述故障现象时,向量检索能够找到语义相关解决方案。
排名融合策略
两种检索方式返回的分数通常不可直接比较。向量数据库可能返回相似度分数,而关键词搜索可能返回 BM25 分数,因此需要先转换为统一排序指标。
常见方法包括加权融合、倒数排名融合等。倒数排名融合不依赖原始分数范围,而是根据结果所在排名计算综合得分。
其中 表示文档在第 i 个检索结果中的排名, 用于降低高排名差异带来的影响。
实现基础混合检索
下面示例模拟两个检索器返回结果,再按照权重合并排名。
python
vector_results = {
    'doc-a': 0.92,
    'doc-b': 0.85
}

keyword_results = {
    'doc-b': 0.95,
    'doc-c': 0.90
}

weight_vector = 0.6
weight_keyword = 0.4
scores = {}

for doc, score in vector_results.items():
    scores[doc] = scores.get(doc, 0) + score * weight_vector

for doc, score in keyword_results.items():
    scores[doc] = scores.get(doc, 0) + score * weight_keyword

print(sorted(scores.items(), key=lambda item: item[1], reverse=True))
预期输出
text
[('doc-b', 0.89), ('doc-a', 0.552), ('doc-c', 0.36)]混合检索接入 RAG 流程
完整链路通常包括查询解析、双路召回、结果融合、重排序和上下文组装。混合检索主要负责扩大候选范围,最终答案质量还依赖后续排序模型和提示词设计。
在实际项目中,可以根据业务调整两类检索比例。技术文档中型号和命令较多时,可以提高关键词权重;知识问答场景中,可以提高向量检索权重。
验证与优化方法
评估混合检索效果时,需要关注召回率、准确率和最终回答质量。可以准备包含精确查询、自然语言查询和模糊描述的测试集,对比单一检索与混合检索结果。
常见优化方向包括调整融合权重、增加同义词库、优化文本切分粒度,以及在融合后增加重排序模型。
按自己的节奏,确认真正理解。