
大模型应用开发 / 系统课时
接入重排模型
接入重排模型
本课介绍如何在 RAG 检索流程中加入重排模型,对初步召回的候选片段进行二次相关性判断,最终筛选更符合用户问题的知识内容,提高回答准确率。
学习目标
- 理解重排模型在 RAG 流程中的作用和处理位置
- 掌握使用重排模型对候选文档重新评分的方法
- 能够设计基础的召回与重排组合流程
重排模型解决的问题
向量检索通常通过语义相似度快速找到候选片段,但相似并不等于真正相关。用户问题可能包含多个意图,部分片段虽然包含相近词语,却无法直接回答问题。
重排模型负责对已经召回的候选结果再次进行精细判断。它通常接收查询文本和候选片段,通过更复杂的语义理解计算相关性分数,再按照分数重新排序。
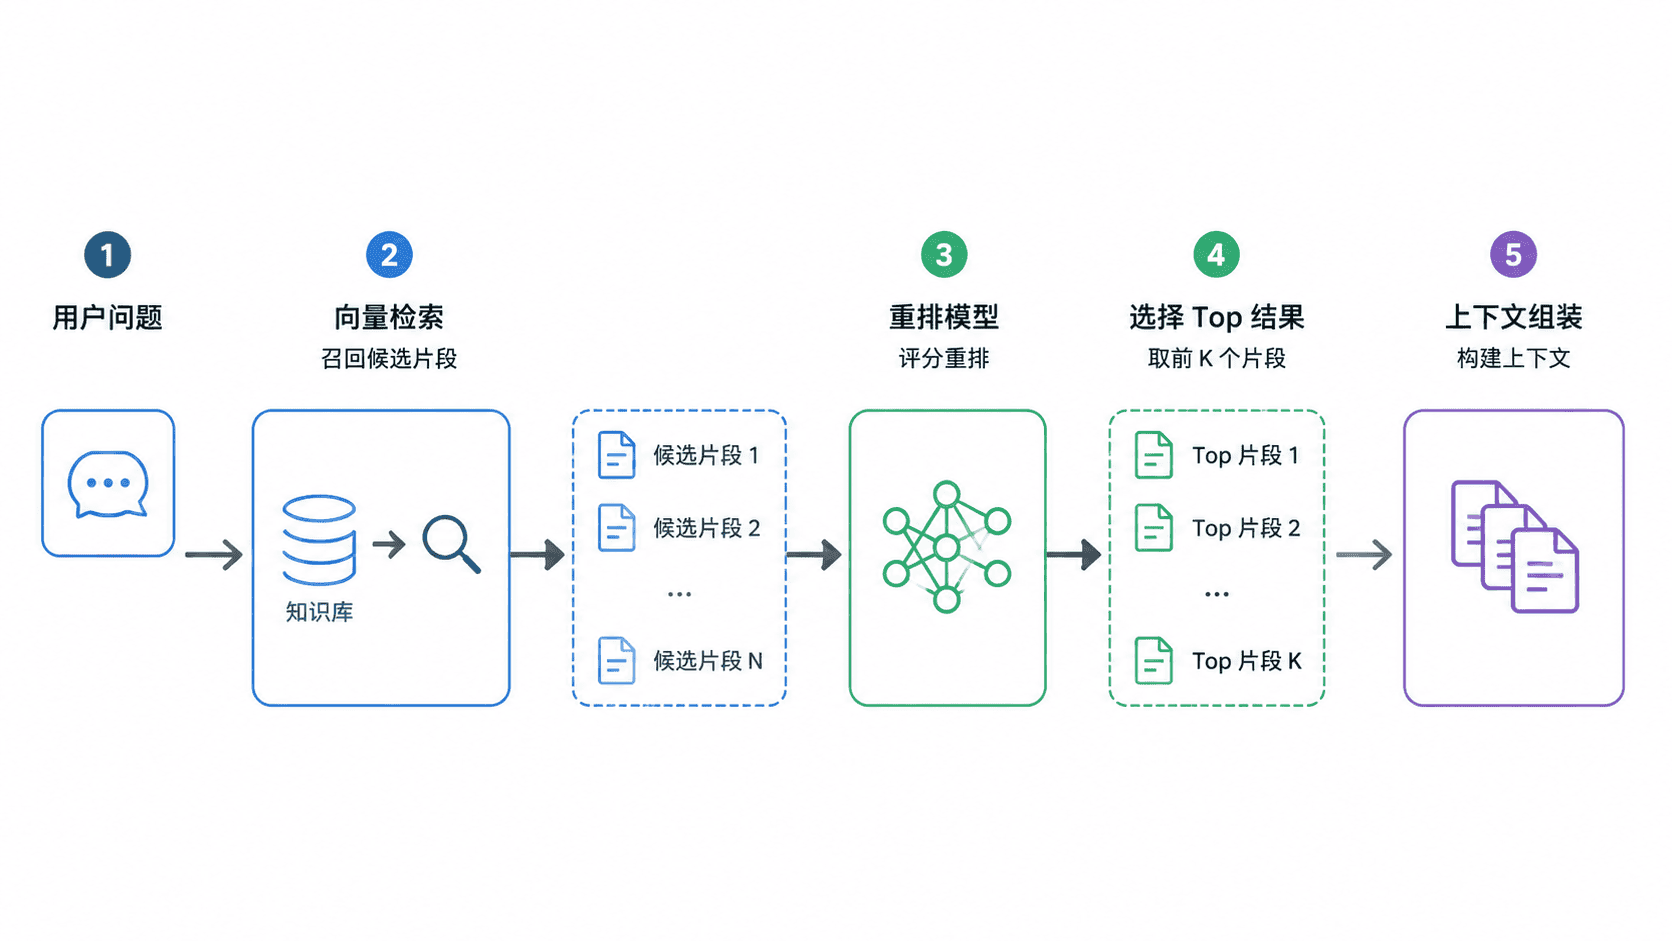
接入重排处理流程
一个典型流程包含三个阶段:先通过向量数据库召回较多候选,再使用重排模型计算精排分数,最后截取排名靠前的片段作为上下文。
为了保证召回覆盖率,初始检索数量通常大于最终使用数量。例如先获取 20 个候选片段,再经过重排保留前 5 个结果。
python
from sentence_transformers import CrossEncoder

query = "如何配置数据库连接池"
documents = [
    "连接池可以复用数据库连接,减少创建开销。",
    "日志系统负责记录应用运行状态。",
    "数据库连接池需要配置最大连接数。"
]

# CrossEncoder同时读取问题和文档,直接输出相关性分数
model = CrossEncoder("cross-encoder/ms-marco-MiniLM-L-6-v2")
scores = model.predict([(query, doc) for doc in documents])

results = sorted(
    zip(documents, scores),
    key=lambda item: item[1],
    reverse=True
)

for content, score in results:
    print(round(float(score), 4), content)
预期输出
text
0.8421 数据库连接池需要配置最大连接数。
0.7315 连接池可以复用数据库连接,减少创建开销。
0.1023 日志系统负责记录应用运行状态。
实际分数会因模型版本和输入文本变化而不同,但排序结果应体现更相关内容优先。
重排模型选择与参数控制
重排模型通常分为通用文本相关性模型和领域优化模型。通用模型适合快速搭建知识库,领域模型则可以针对法律、医疗、技术文档等场景提升效果。
使用时需要关注三个参数:候选数量、最终保留数量和评分阈值。候选过少可能导致遗漏答案,候选过多会增加重排成本。
常见策略是先扩大召回范围,再通过重排压缩上下文,使大模型接收到的信息更准确。
按自己的节奏,确认真正理解。