
大模型应用开发 / 系统课时
整合知识索引流水线
整合知识索引流水线
本课把文档解析、文本清洗、切分、向量生成、批量写入和增量更新串成一条可重复执行的索引流水线。完成后,你将得到一个具备稳定文档标识、批处理、失败隔离和幂等更新能力的最小实现,可作为生产知识库离线索引任务的基础。
学习目标
- 串联解析、清洗、切分、嵌入和写入五个核心阶段
- 使用稳定标识实现重复执行和增量更新
- 为批处理加入基本的失败隔离与结果统计
从文件到可检索片段
索引流水线的输入是原始文档,输出不是单纯的向量,而是一组可以被查询、过滤和追踪来源的片段记录。每个阶段都应只承担一种职责,并保留文档 ID、片段 ID、来源路径和内容哈希等元数据,避免后续更新时无法判断哪些数据需要替换。
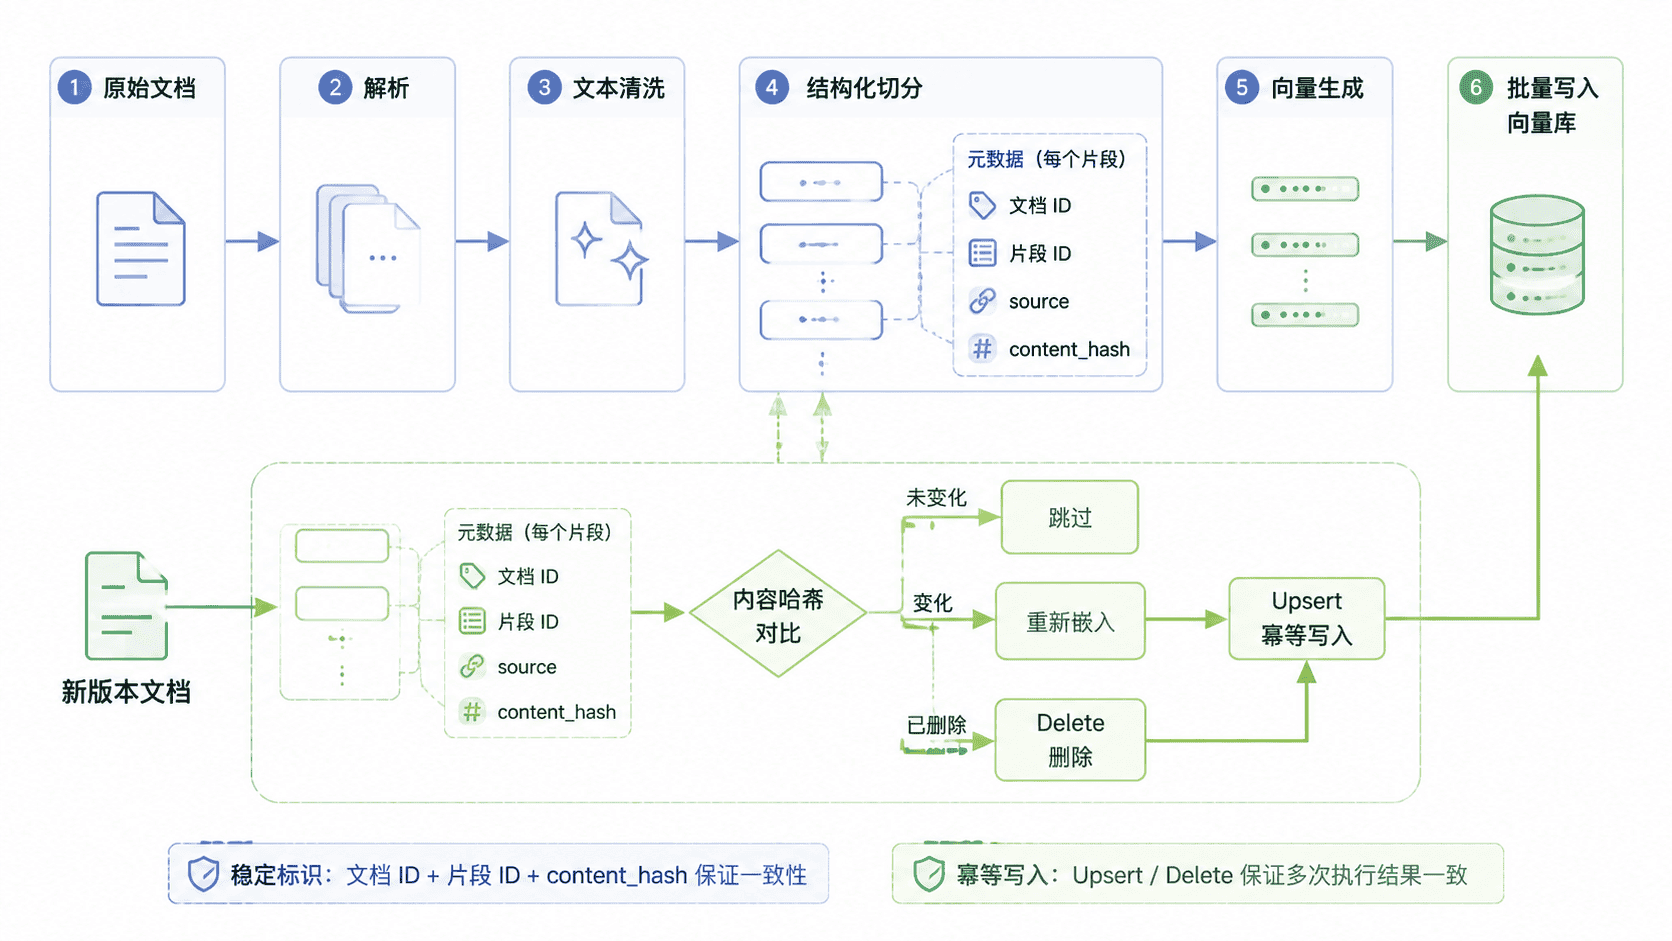
一个实用的数据模型至少包含 chunk_id、document_id、text、source 和 content_hash。其中 chunk_id 必须稳定:只要同一文档的同一逻辑片段没有变化,就应得到相同标识,这样重复运行流水线时可以使用 upsert,而不是不断插入重复记录。
实现最小索引流水线
下面示例使用标准 Python 模拟解析、切分、嵌入和向量库存储。为便于本地直接运行,嵌入函数使用确定性的哈希向量;生产环境只需将 embed() 替换为实际嵌入模型客户端,将内存字典替换为向量数据库批量 upsert 接口。
from __future__ import annotations

import hashlib
from dataclasses import dataclass
from pathlib import Path

@dataclass
class Chunk:
    chunk_id: str
    document_id: str
    text: str
    source: str
    content_hash: str

VECTOR_STORE: dict[str, dict] = {}

def sha256(text: str) -> str:
    return hashlib.sha256(text.encode("utf-8")).hexdigest()

def clean(text: str) -> str:
    # 合并多余空白,使无意义格式变化不会触发重新索引。
    return " ".join(text.split())

def split_text(text: str, size: int = 80) -> list[str]:
    return [text[i:i + size] for i in range(0, len(text), size) if text[i:i + size]]

def embed(text: str) -> list[float]:
    digest = hashlib.sha256(text.encode("utf-8")).digest()
    return [round(byte / 255, 4) for byte in digest[:8]]

def build_chunks(path: Path) -> list[Chunk]:
    raw = path.read_text(encoding="utf-8")
    text = clean(raw)
    document_id = sha256(str(path.resolve()))[:16]
    chunks = []
    for index, part in enumerate(split_text(text)):
        # 片段序号与文档稳定 ID 共同构成可重复生成的 chunk_id。
        chunk_id = f"{document_id}:{index}"
        chunks.append(Chunk(chunk_id, document_id, part, str(path), sha256(part)))
    return chunks

def index_document(path: Path) -> tuple[int, int]:
    written = skipped = 0
    for chunk in build_chunks(path):
        old = VECTOR_STORE.get(chunk.chunk_id)
        if old and old["content_hash"] == chunk.content_hash:
            skipped += 1
            continue
        VECTOR_STORE[chunk.chunk_id] = {
            "text": chunk.text,
            "vector": embed(chunk.text),
            "document_id": chunk.document_id,
            "source": chunk.source,
            "content_hash": chunk.content_hash,
        }
        written += 1
    return written, skipped

def main() -> None:
    path = Path("knowledge.txt")
    path.write_text("RAG 索引流水线需要解析、清洗、切分、嵌入和写入。" * 8, encoding="utf-8")
    first = index_document(path)
    second = index_document(path)
    print(f"first written={first[0]} skipped={first[1]}")
    print(f"second written={second[0]} skipped={second[1]}")
    print(f"stored={len(VECTOR_STORE)}")

if __name__ == "__main__":
    main()
预期输出
first written=3 skipped=0
second written=0 skipped=3
stored=3
示例中的具体片段数量取决于文本长度和切分大小;当输入与参数保持不变时,第二次执行应全部跳过,这正是幂等索引最重要的验证结果。
批量写入与增量更新
真实项目不应每生成一个向量就发起一次远程写入。更稳妥的方式是按固定批次生成嵌入后执行批量 upsert,并为每批记录成功数、失败数和耗时。如果某批失败,只重试该批,避免整个大型文档集合从头执行。
增量更新还需要处理删除。一次文档重建结束后,可以比较“本次生成的 chunk_id 集合”和“向量库中该 document_id 已存在的 chunk_id 集合”,将后者多出的记录删除。这样才能避免文档缩短后,旧片段继续参与检索。
更新判断最好基于清洗后的内容哈希,而不是文件修改时间。时间戳改变不代表正文改变,而内容哈希相同意味着无需重新调用昂贵的嵌入模型。若切分算法或嵌入模型升级,则应增加 index_version,主动触发对应范围的重建。
生产化验收要点
一条可部署的流水线至少要能回答四个问题:哪些文档处理成功、哪些失败、失败发生在哪个阶段、重复执行是否会产生重复数据。日志中应携带 document_id 和批次 ID,指标则统计解析失败、嵌入调用失败、写入失败及处理吞吐量。
验证时选取一个小型文档集连续运行两次:第一次应写入全部片段,第二次应基本跳过;修改某个文档后,只应重新计算变化片段;删除正文后,对应旧片段也应消失。通过这三项测试,才能确认增量策略真正闭环。