
大模型应用开发 / 系统课时
实现向量相似度检索
实现向量相似度检索
本节实现 RAG 检索链路中的核心步骤,将用户问题转换为查询向量,通过相似度计算找到最相关片段,并读取对应元数据供后续生成使用。
学习目标
- 理解查询向量与文档向量匹配的过程。
- 掌握相似度检索参数和结果结构。
- 能够编写基础向量检索代码并验证返回片段。
从问题到候选片段
向量检索的输入不是原始文本匹配,而是经过嵌入模型转换后的数字向量。系统会计算查询向量与索引中已有向量之间的距离或相似度,再返回排名靠前的候选结果。
一个完整流程通常包括查询文本、嵌入生成、向量搜索、元数据过滤和结果排序几个阶段。
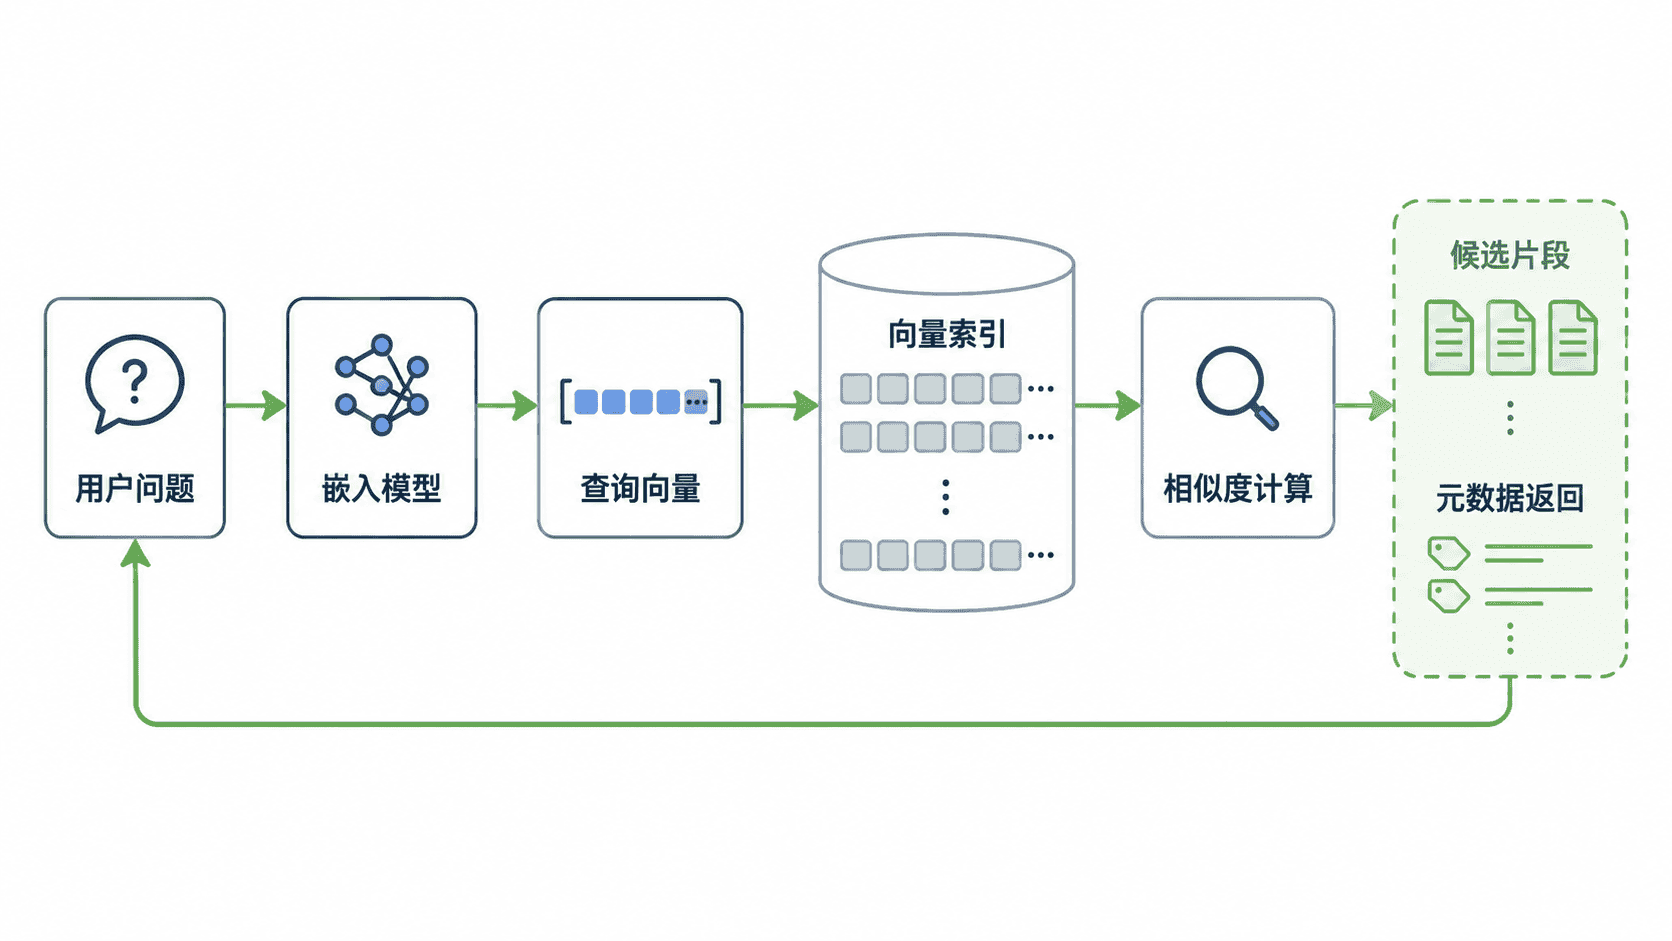
执行基础相似度查询
检索时通常需要指定返回数量 topK。数量过小可能遗漏相关信息,数量过大则会增加后续上下文长度和模型成本。下面示例展示一个简化的向量检索过程。
python
query_text = "如何配置订单服务缓存"

# 将用户问题转换为查询向量
query_vector = embedding_model.encode(query_text)

# 查询最相关的三个片段
results = vector_store.search(
    vector=query_vector,
    top_k=3,
    include_metadata=True
)

for item in results:
    print(item["score"], item["metadata"]["documentId"])
预期输出
text
0.92 doc-<ID>
0.87 doc-<ID>
0.81 doc-<ID>
实际分数范围和字段名称会根据向量数据库实现不同而变化,重点是保留相似度值和来源信息。
理解检索参数选择
topK 决定候选片段数量,过滤条件决定搜索范围,相似度阈值决定结果质量。
在企业知识库中,通常会结合业务元数据过滤。例如按部门、产品版本或文档状态限制搜索范围,减少无关内容进入上下文。
参数调整没有固定答案,需要结合问题类型、文档规模和生成模型上下文窗口进行测试。
检查召回结果质量
向量检索完成后不能只看是否返回结果,还要检查返回片段是否真正回答问题。
常见问题包括:相似但无答案的片段排名靠前,原因可能是切片过大、嵌入模型不匹配或缺少元数据过滤。
优化方向通常包括调整文本切分策略、增加混合检索、加入重排模型等。
按自己的节奏,确认真正理解。