
大模型应用开发 / 系统课时
理解检索结果重排
理解检索结果重排
检索结果重排用于解决向量召回“找得多但不一定准”的问题。本节将理解召回模型与重排模型的区别,掌握交叉编码器如何重新评估候选文档,并明确它在 RAG 链路中的作用。
学习目标
- 理解向量召回和结果重排的职责差异。
- 掌握交叉编码重排模型的基本工作方式。
- 能够设计包含召回和重排的检索流程。
为什么需要结果重排
向量检索通过计算查询与文档向量的相似度快速找到候选内容,但它通常只关注整体语义接近程度,无法深入判断查询和文档之间的精确匹配关系。
例如用户查询“如何修改数据库连接池大小”,向量检索可能返回数据库配置、连接超时、性能优化等多个相关文档。重排模型会进一步判断哪个文档真正回答了问题。
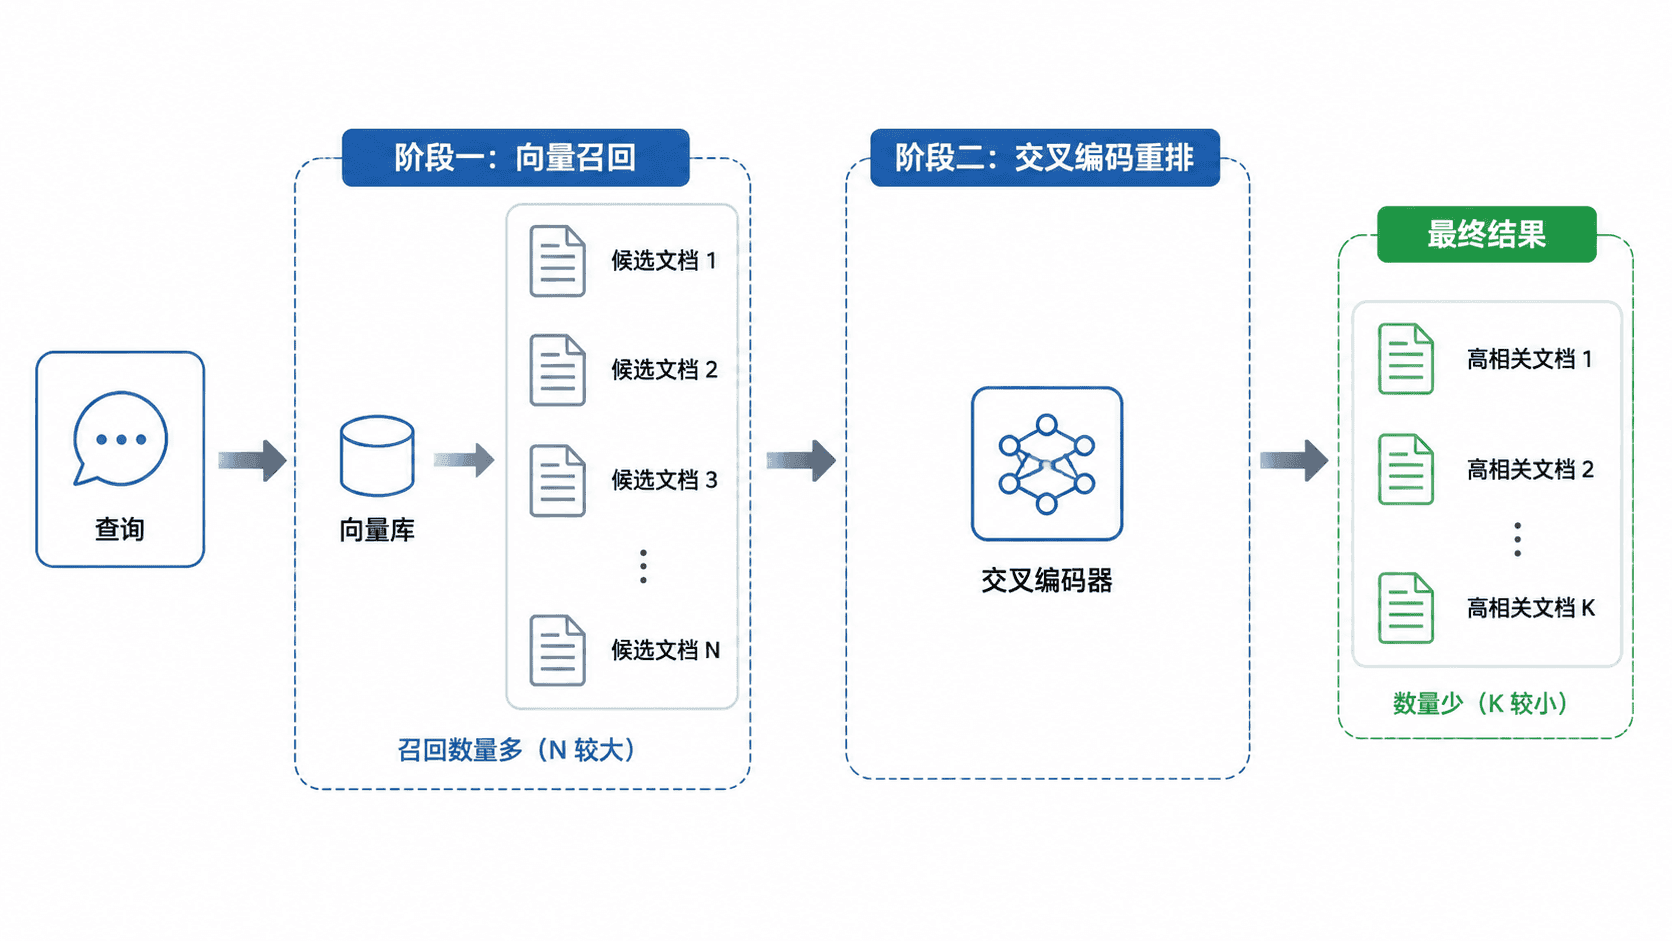
向量召回与交叉编码重排的区别
向量召回通常采用双编码结构,分别将查询和文档转换为向量,然后计算相似度。它适合处理大规模文档,因为向量可以提前建立索引。
交叉编码模型则同时输入查询和候选文档,让模型直接分析二者关系,因此准确度更高,但计算成本也更大。
| 阶段 | 目标 | 特点 |
|---|---|---|
| 向量召回 | 快速找到候选集合 | 速度快,适合大规模搜索 |
| 交叉编码重排 | 精确判断相关性 | 准确率高,计算成本较高 |
重排模型的工作流程
典型 RAG 流程会先召回较大的候选集,例如 Top 50 文档,再使用重排模型筛选 Top 5 文档进入上下文生成阶段。下面示例展示一个简单的重排接口调用流程:
python
from typing import List

def rerank(query: str, documents: List[str]) -> List[str]:
    # 示例中使用关键词数量模拟模型评分
    scored = [(doc.count("数据库"), doc) for doc in documents]
    return [doc for _, doc in sorted(scored, reverse=True)]

query = "数据库连接池配置"
docs = ["缓存优化方案", "数据库连接池调整方法"]

print(rerank(query, docs)[0])
预期输出
text
数据库连接池调整方法重排策略中的实践注意事项
重排并不适合无限扩大候选数量。候选文档过多会增加模型计算时间,也可能引入更多噪声。
常见做法是根据业务规模调整召回数量和重排数量,例如先召回几十篇文档,再选择少量高质量片段进入提示词上下文。
同时需要监控重排后的命中率。如果重排模型长期降低原始召回结果质量,应检查领域适配、训练数据和评分策略。
按自己的节奏,确认真正理解。