
大模型应用开发 / 系统课时
分析失败案例
分析失败案例
当 RAG 系统回答错误时,不能只看最终答案,而需要定位问题发生在哪个环节。本课介绍如何拆解失败样本,区分知识缺失、解析错误、切分不合理、召回失败、重排偏差和生成偏差,并建立可执行的问题定位流程。
学习目标
- 掌握 RAG 失败案例的分类方法。
- 学会根据检索链路定位错误来源。
- 建立从问题复现到修复验证的分析流程。
认识 RAG 失败的完整链路
一次 RAG 请求通常经过文档处理、向量检索、候选排序和答案生成多个阶段。最终答案错误,并不一定意味着模型能力不足,可能是任意一个环节丢失了正确的信息。
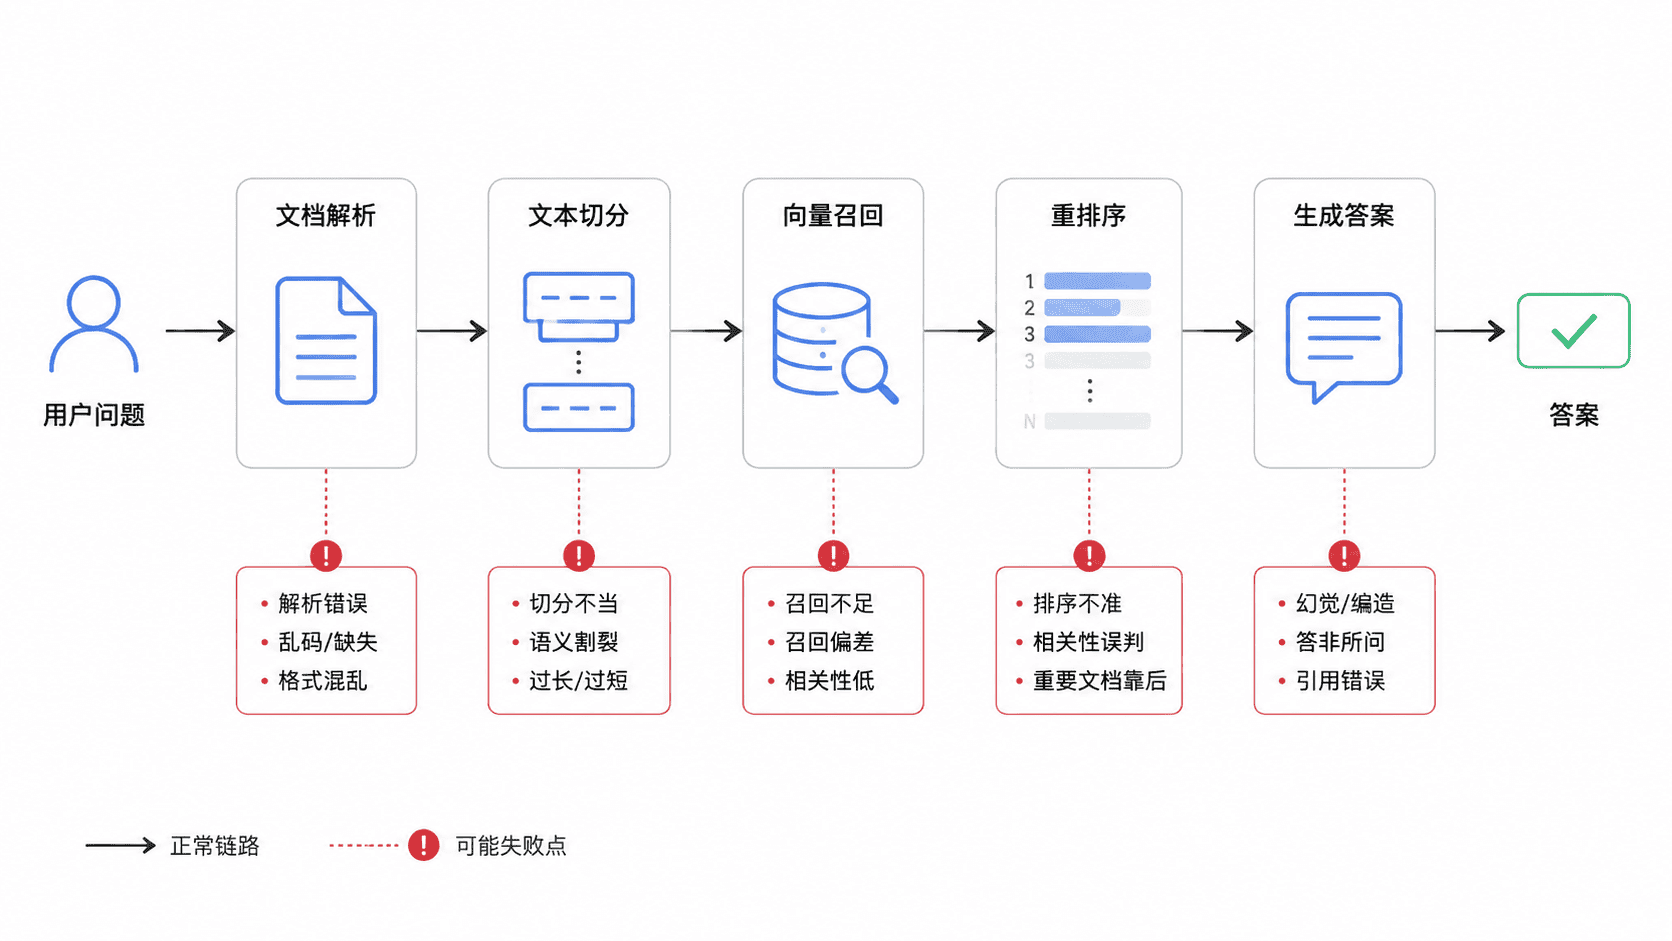
分析失败案例时,应先记录输入问题、检索结果、最终回答和引用内容,再逐层判断是哪一步出现偏差,而不是直接修改提示词。
区分常见失败类型
知识缺失表示知识库中没有覆盖用户需要的信息。此时即使检索流程正常,也无法找到正确依据,需要补充数据来源。
解析错误通常发生在文档导入阶段,例如 PDF 表格、扫描文本或特殊格式没有正确转换,导致原始内容已经丢失。
切分不当会破坏上下文关系。一个完整规则被拆散后,单个片段可能无法表达原始含义,导致召回结果缺少关键条件。
召回失败表示正确内容存在,但检索阶段没有找到。例如查询表达方式与文档语言差异较大,或者向量搜索参数限制过严。
重排错误表示候选文档已经包含正确内容,但排序模型没有将相关片段放在前面,导致生成阶段优先参考错误信息。
生成偏差表示检索结果正确,但模型没有按照上下文回答,可能受到提示词、上下文长度或模型推理方式影响。
使用日志定位问题
实际项目中,可以通过保存关键中间结果快速定位问题。建议为每次请求记录查询文本、召回片段、排序分数和最终上下文。
{
  "query": "如何修改用户密码",
  "retrievedChunks": [
    {
      "id": "chunk-001",
      "score": 0.86,
      "content": "用户可以在账户设置页面修改密码"
    }
  ],
  "answer": "请进入账户设置页面修改密码"
}
预期结果
能够看到一次请求经过检索和生成后的关键数据,用于判断错误发生位置。如果 retrievedChunks 为空,需要优先检查检索问题;如果 retrievedChunks 正确但 answer 错误,则重点检查生成阶段。
建立失败分析流程
面对一个错误回答,可以按照固定顺序排查:先确认知识是否存在,再确认文档是否正确解析,然后检查切分结果是否完整,之后查看召回和重排效果,最后分析模型生成。
这种顺序可以避免过早调整提示词。很多问题根源在数据处理阶段,修改提示词只能暂时掩盖问题。常见判断方法如下:
| 现象 | 优先检查位置 | 典型修复 |
|---|---|---|
| 没有引用任何资料 | 召回阶段 | 调整检索条件或补充知识 |
| 引用内容缺少关键句 | 切分阶段 | 调整片段策略 |
| 引用正确但回答错误 | 生成阶段 | 优化提示词或模型参数 |
| 相似问题结果波动大 | 重排阶段 | 调整排序模型 |