
大模型应用开发 / 系统课时
生成答案引用
生成答案引用
本节解决 RAG 系统回答“依据来自哪里”的问题,通过引用编号将模型生成内容与检索到的知识片段关联,最终让用户能够追踪答案对应的文档标题、页码和原始来源。
学习目标
- 理解答案引用在 RAG 流程中的作用
- 掌握引用编号与检索文档元数据的映射方式
- 实现带来源追踪信息的答案结构
引用生成的核心设计
普通生成式回答只输出自然语言内容,用户无法判断信息是否来自知识库。RAG 系统需要在生成阶段保留检索证据,并让模型输出稳定的引用编号。
引用编号通常采用 [1]、[2] 这样的短标记。编号本身不保存完整信息,而是作为答案文本与证据列表之间的连接点。典型流程如下:
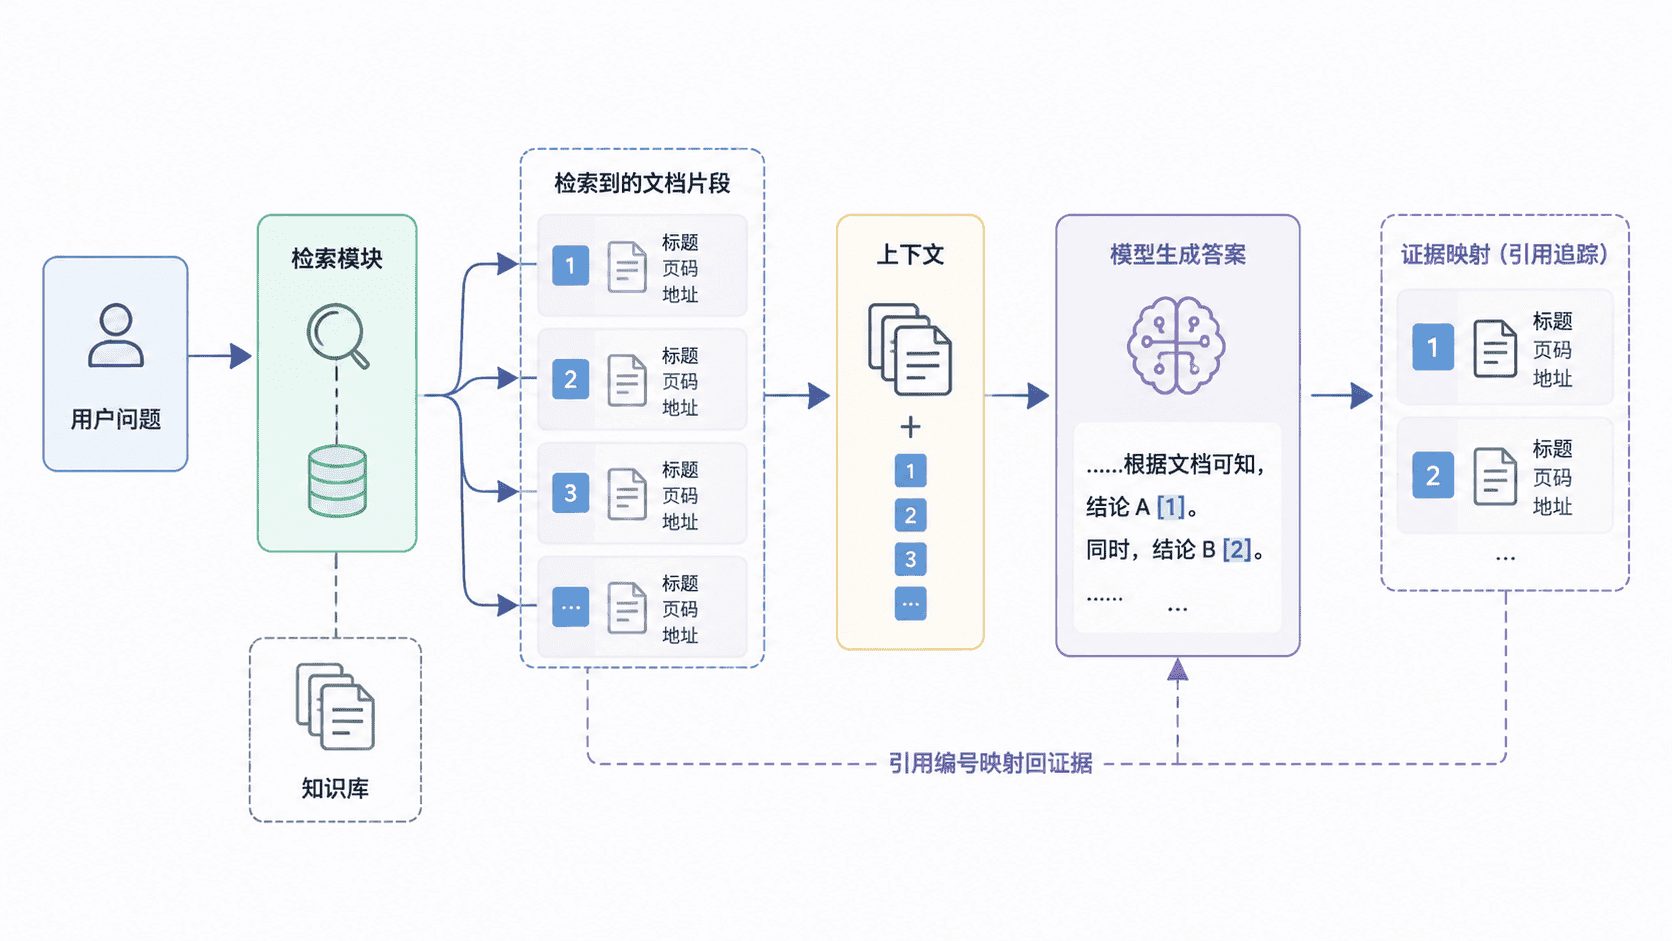
设计引用数据结构
生成引用前,需要保证检索结果携带完整元数据。除了文本内容,还需要保存文档名称、章节、页码或 URL 等信息。一个简化的数据结构如下:
json
{
  "id": "doc-001",
  "content": "RAG 通过检索增强生成提升答案准确性。",
  "metadata": {
    "title": "RAG 实战指南",
    "page": 12,
    "url": "https://example.com/doc-001"
  }
}
预期结果
text
检索结果包含文本内容和可追踪的来源信息。模型生成时只需要引用编号,不直接拼接复杂元数据。例如提示模型输出:
text
请根据提供的资料回答问题,并在使用资料的位置添加引用编号,例如[1]。预期结果
text
答案文本中出现[1]、[2]等引用标记。实现引用编号映射
应用层通常负责建立编号和文档对象之间的关系,再把映射结果返回给前端。
python
sources = [
    {
        "title": "RAG 实战指南",
        "page": 12,
        "url": "https://example.com/doc-001"
    },
    {
        "title": "向量检索原理",
        "page": 8,
        "url": "https://example.com/doc-002"
    }
]

citation_map = {
    index + 1: source
    for index, source in enumerate(sources)
}

print(citation_map[1]["title"])
预期输出
text
RAG 实战指南前端展示答案时,可以扫描引用编号,再从 citation_map 中获取对应标题、页码和地址。
引用生成的边界问题
引用编号不能替代质量控制。如果模型引用不存在的编号,或者引用与答案内容无关,会降低可信度。
常见处理方式包括:限制模型只能使用提供的编号、生成后校验引用范围、删除没有对应证据的引用标记。
按自己的节奏,确认真正理解。