
大模型应用开发 / 系统课时
理解文本嵌入
理解文本嵌入
文本嵌入负责把自然语言转换为计算机可以比较的向量表示,是 RAG 检索链路中的关键步骤。本节将理解向量维度、语义距离和嵌入空间之间的关系,明确嵌入模型解决的问题。
学习目标
- 理解文本嵌入将文字转换为向量的过程
- 掌握向量维度和语义距离的基本含义
- 了解嵌入在 RAG 检索中的位置
文本嵌入解决什么问题
计算机无法直接理解“如何配置数据库连接”和“数据库连接配置方法”这类表达之间的相似关系。文本嵌入模型会分析文本语义,将内容映射到高维空间中的向量。
转换后的向量不是文字编码,而是一种表示语义特征的数学形式。含义接近的文本通常会在向量空间中距离更近。
向量维度与嵌入空间
一个文本向量由多个数字组成,数字数量称为维度。例如某模型可能输出 768 维向量,每个维度共同表示文本的语义特征。
向量空间可以理解为一个多维坐标系统。文档片段和用户问题都会被映射到同一个空间中,然后通过距离计算寻找相似内容。
常见距离计算方式包括余弦相似度。计算结果越接近 1,通常表示两个向量方向越接近,语义相关性越高。
文本嵌入在 RAG 中的位置
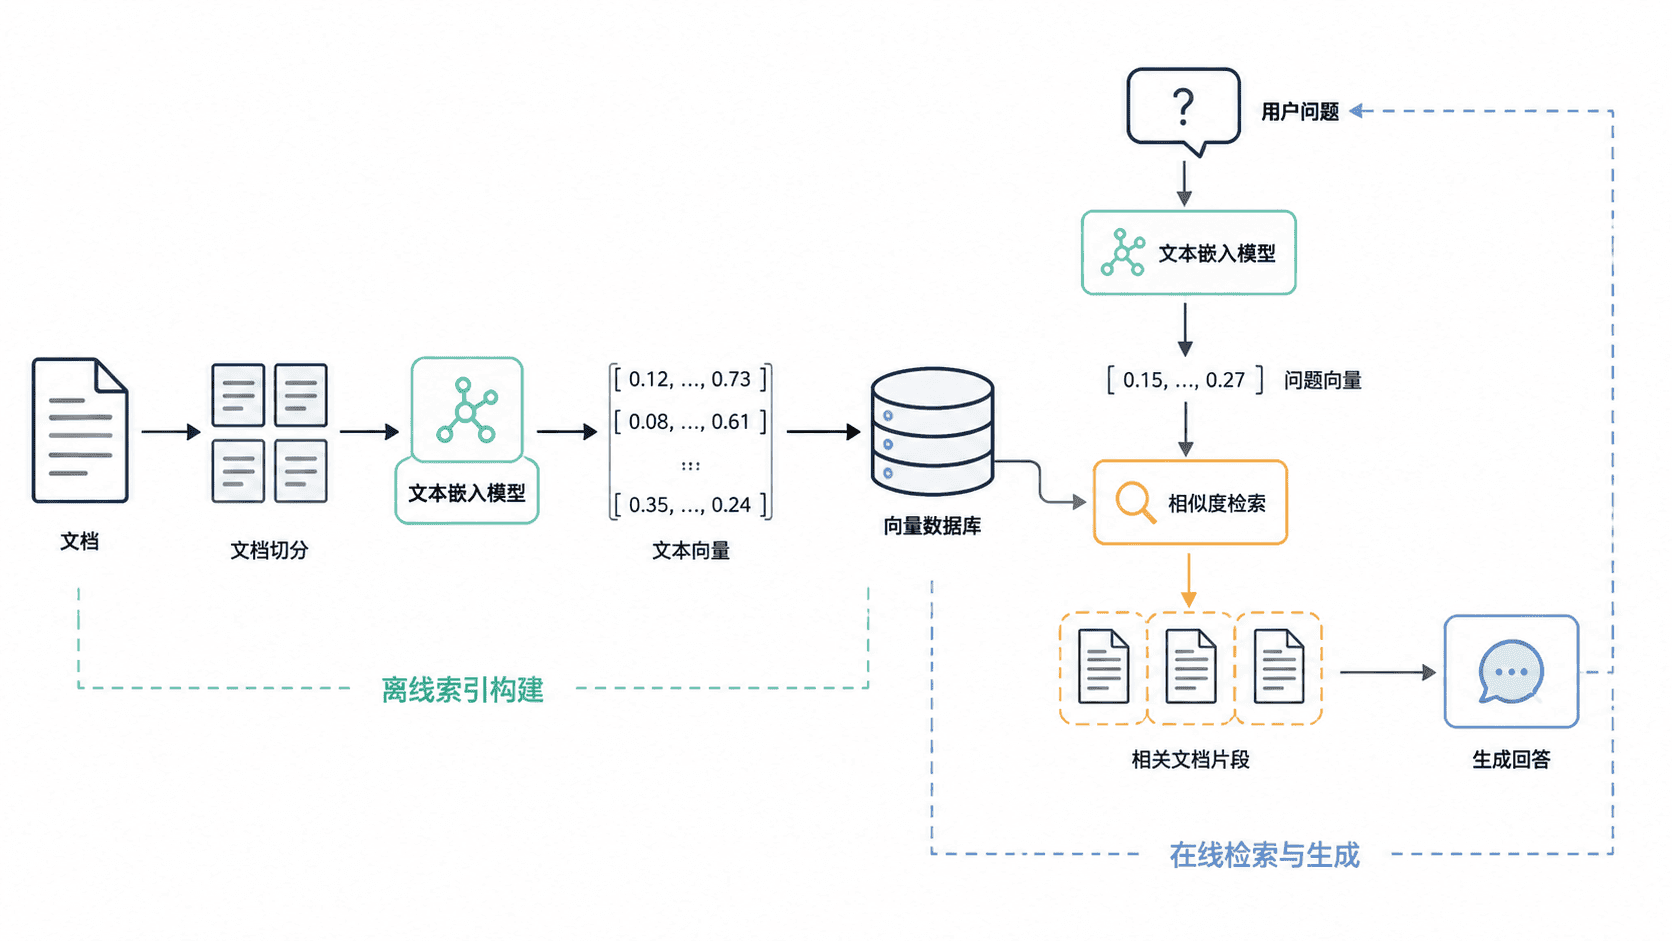
RAG 流程中,文档进入知识库时会先经过切分和嵌入,生成对应向量并保存到向量索引中。用户查询时,问题也会经过同样的嵌入过程,再与已有向量进行匹配。
选择嵌入模型时的关注点
不同嵌入模型在维度、语言支持、速度和语义效果上存在差异。实际项目中需要根据数据类型、查询场景和成本要求选择合适模型。
维度越高不一定代表效果越好,还需要结合实际检索评测结果判断。过大的向量也会增加存储和计算压力。
按自己的节奏,确认真正理解。