
大模型应用开发 / 系统课时
实现基础问答链
实现基础问答链
本课将实现一个最小可运行的 RAG 问答链,将用户问题处理、知识检索、上下文拼接和模型调用连接起来。完成后可以理解一次知识库问答请求在系统内部的完整执行过程。
学习目标
- 理解基础 RAG 问答链的执行顺序。
- 掌握检索结果进入模型提示词的方式。
- 能够实现简单的端到端问答流程。
基础问答链的执行流程
RAG 问答链的核心流程是先理解问题,再检索相关资料,最后让模型基于资料生成答案。相比直接调用大模型,RAG 增加了外部知识获取步骤。
一次请求通常经过以下阶段:用户输入问题,系统生成查询条件,向向量库检索文档,将结果格式化为上下文,然后调用模型生成最终回答。
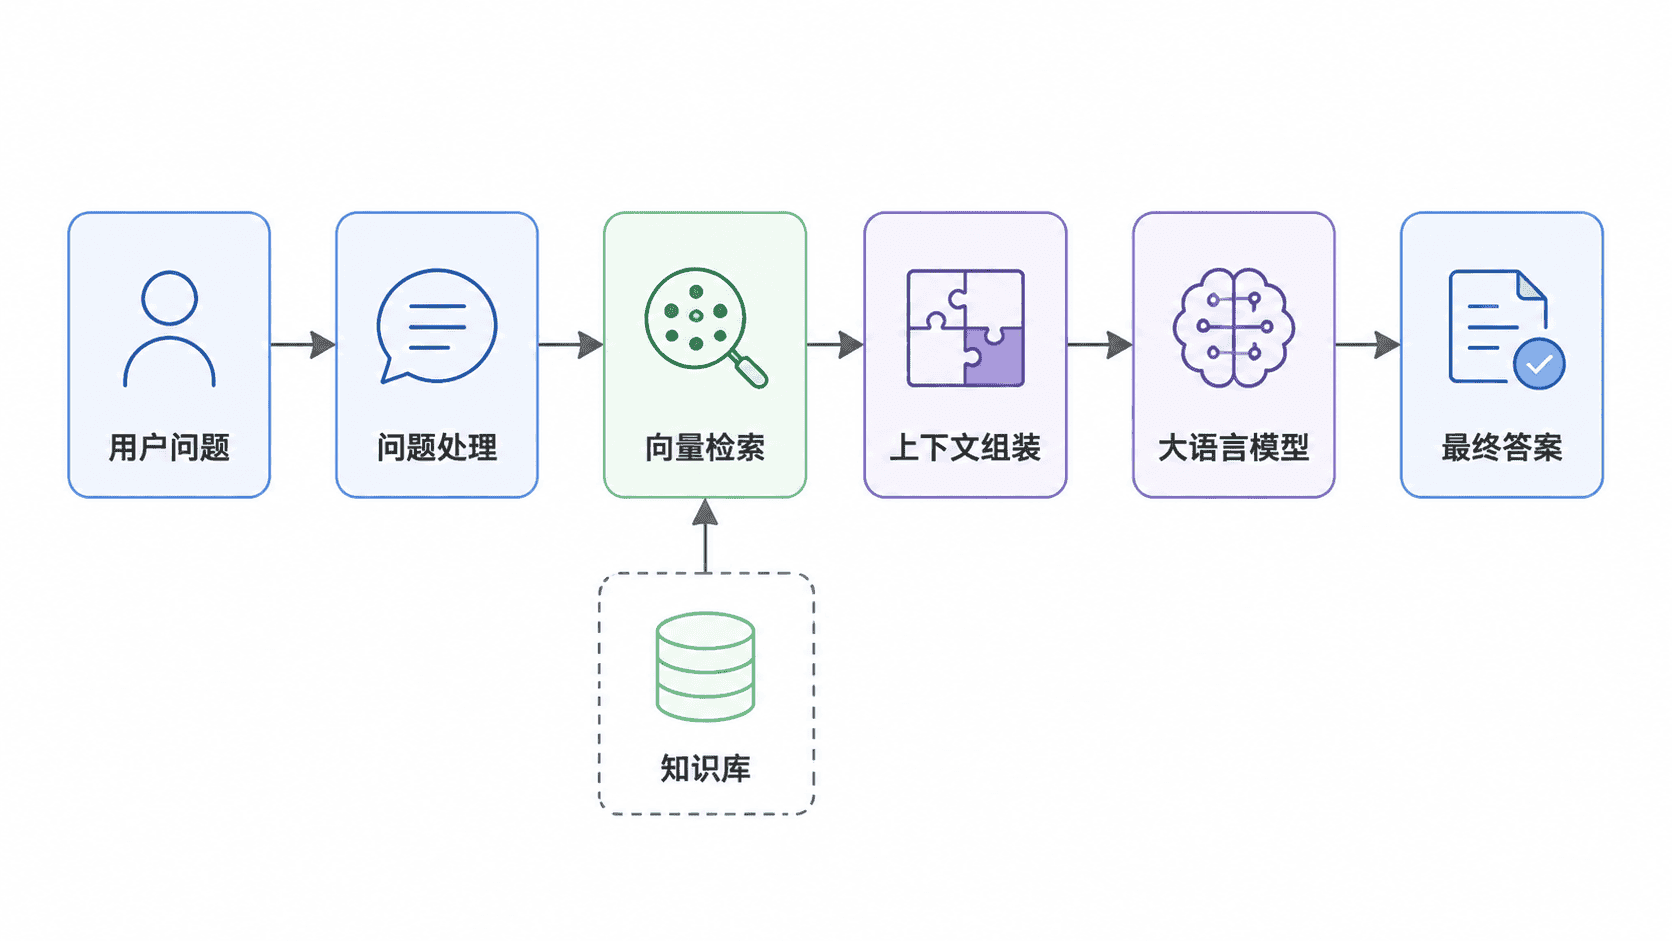
实现最小问答链
实际项目中可以先使用简单函数串联各阶段,再逐步替换为真实向量数据库和模型服务。
python
from typing import List

def retrieve(question: str) -> List[str]:
    # 示例检索逻辑,实际项目替换为向量数据库查询
    return ["文档片段:RAG 通过检索增强模型回答能力。"]

def build_prompt(question: str, contexts: List[str]) -> str:
    context_text = "\n".join(contexts)
    return f"""你是知识库助手。
只根据上下文回答问题。

上下文:
{context_text}

问题:
{question}
"""

def call_model(prompt: str) -> str:
    # 示例返回,实际项目替换为模型 API 调用
    return "根据知识库内容,RAG 使用检索结果辅助生成答案。"

question = "什么是 RAG?"
documents = retrieve(question)
prompt = build_prompt(question, documents)
answer = call_model(prompt)
print(answer)
预期输出
text
根据知识库内容,RAG 使用检索结果辅助生成答案。连接真实模型调用
在生产环境中,call_model 函数通常负责调用大语言模型接口。调用前需要保证提示词长度没有超过模型上下文限制,并根据业务要求设置温度、最大输出长度等参数。
问答链中的每个阶段都应该保持独立,这样出现问题时可以快速定位。例如回答错误可能来自检索结果不相关,也可能来自提示词约束不足。
验证问答链效果
测试基础问答链时,不应只检查最终答案,还需要观察中间过程。重点验证以下内容:
- 检索结果是否包含回答问题所需信息。
- 拼接后的提示词是否保留关键上下文。
- 模型回答是否遵守限定范围。
可以记录问题、检索文档 ID、提示词版本和最终答案,方便后续优化和引用追踪。
按自己的节奏,确认真正理解。