
大模型应用开发 / 系统课时
设计知识访问权限
设计知识访问权限
本课解决 RAG 系统中“用户能检索到什么知识”的控制问题,通过用户、角色、部门和知识空间映射为过滤条件,确保召回阶段不会返回无权限内容。
学习目标
- 理解 RAG 权限控制为什么必须参与检索流程
- 掌握用户身份到知识过滤条件的映射方式
- 能设计基础的权限过滤字段模型
权限控制在 RAG 中的位置
传统应用通常在页面展示阶段限制数据访问,但 RAG 的风险更早发生在召回阶段。如果受限文档已经进入上下文,大模型可能基于这些内容生成回答,因此权限校验需要前置到检索链路。
一个完整流程通常包含用户身份解析、权限规则计算、向量检索过滤、结果重排和答案生成。过滤条件应该成为检索请求的一部分,而不是生成后的补充检查。
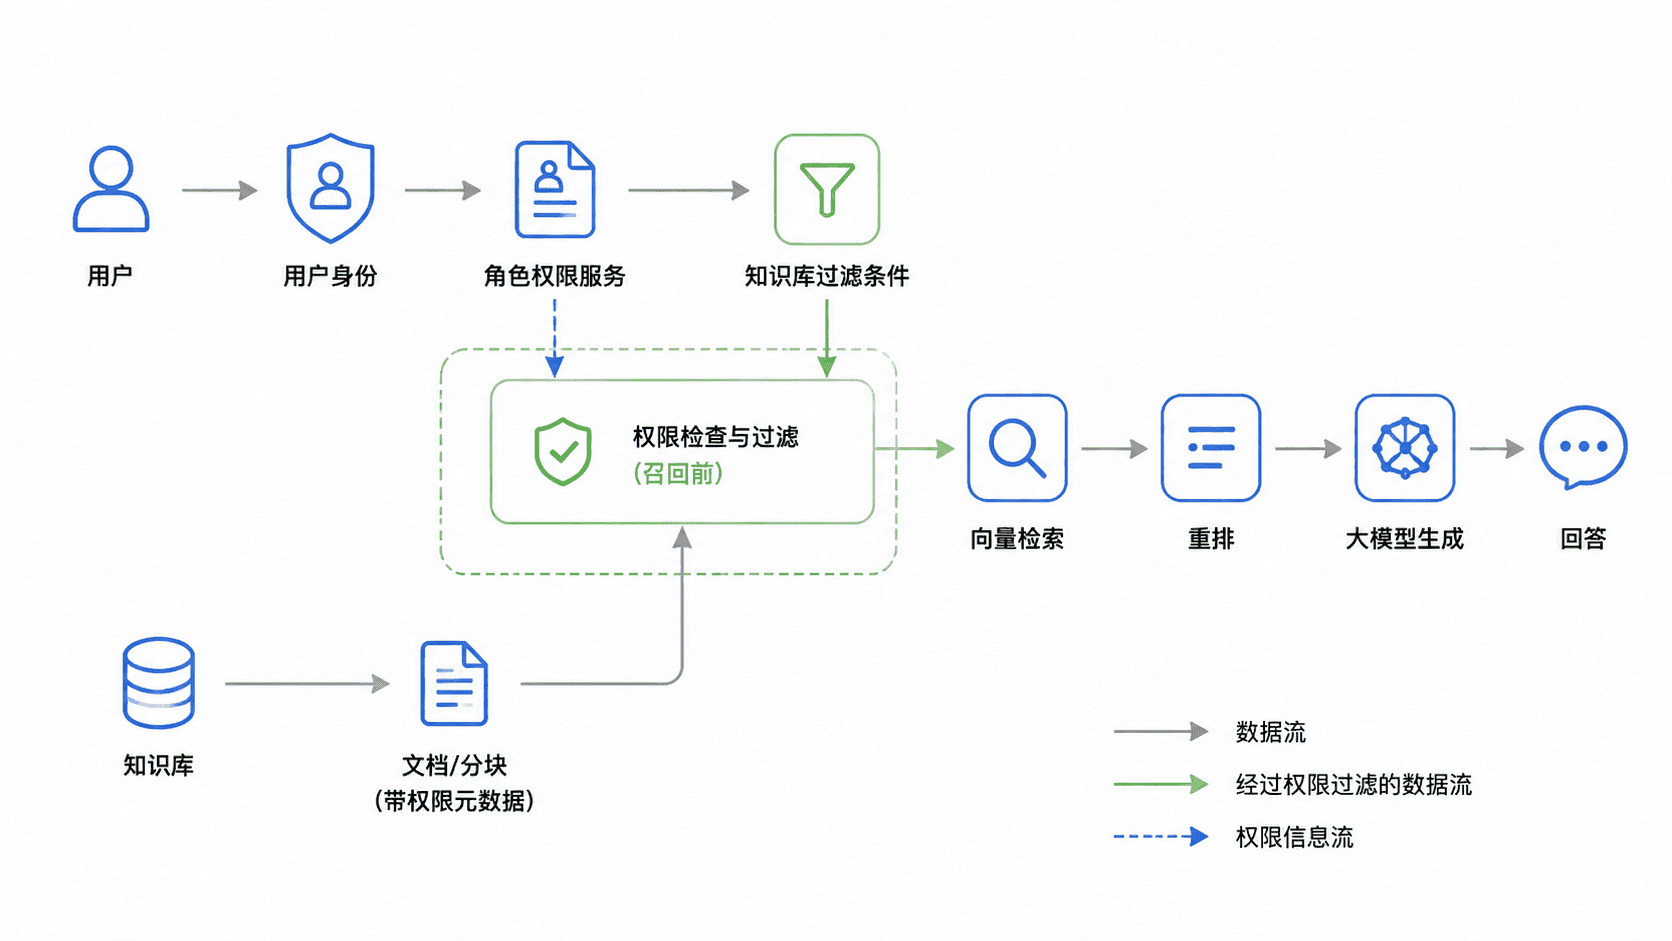
设计权限数据模型
权限设计的核心是给知识内容附加可查询的权限元数据。常见字段包括租户编号、部门编号、角色列表、可访问用户列表等。例如一份文档可以保存如下元数据:
json
{
  "documentId": "doc-<ID>",
  "department": "finance",
  "roles": ["manager", "auditor"],
  "visibility": "internal"
}
预期结果
text
文档记录包含业务字段和权限字段,检索时可以根据这些字段过滤结果。权限字段应该根据业务规则设计。不要只保存一个布尔值,例如 isPublic,因为企业场景通常需要支持部门、岗位和项目组等复杂关系。
将用户转换为检索条件
用户请求进入系统后,需要先解析身份信息,再转换成检索过滤表达式。例如用户信息如下:
python
user = {
    "userId": "user-<ID>",
    "department": "finance",
    "roles": ["manager"]
}

filter_condition = {
    "department": user["department"],
    "role": {"$in": user["roles"]}
}

print(filter_condition)
预期输出
text
{'department': 'finance', 'role': {'$in': ['manager']}}实际项目中,过滤条件通常由权限服务生成,应用服务只负责携带结果调用检索系统,避免业务代码散落大量权限判断逻辑。
常见权限错误
最危险的问题不是检索不到内容,而是错误返回了不应该访问的内容。常见原因包括:
- 上传文档时遗漏权限元数据
- 检索接口允许客户端直接传入过滤条件
- 权限缓存更新不及时
- 只在前端隐藏结果,没有后端过滤
权限过滤字段必须由可信服务生成,不能完全信任用户请求中的参数。
按自己的节奏,确认真正理解。