
大模型应用开发 / 系统课时
组装模型上下文
组装模型上下文
检索和重排后的知识片段还不能直接发送给大模型,需要按照相关性、来源可信度和令牌预算进行组织。本课介绍如何构建稳定的上下文结构,让模型更容易理解并引用检索结果。
学习目标
- 理解模型上下文组装的基本原则
- 掌握知识片段排序和编号方法
- 能够根据预算生成结构化提示上下文
上下文组装的核心流程
RAG 应用中的上下文组装负责连接检索结果和生成模型。它需要处理片段排序、长度控制、来源标记以及提示词格式。
通常会优先放置相关性最高的片段,同时保留来源编号,让模型回答时能够关联具体依据。
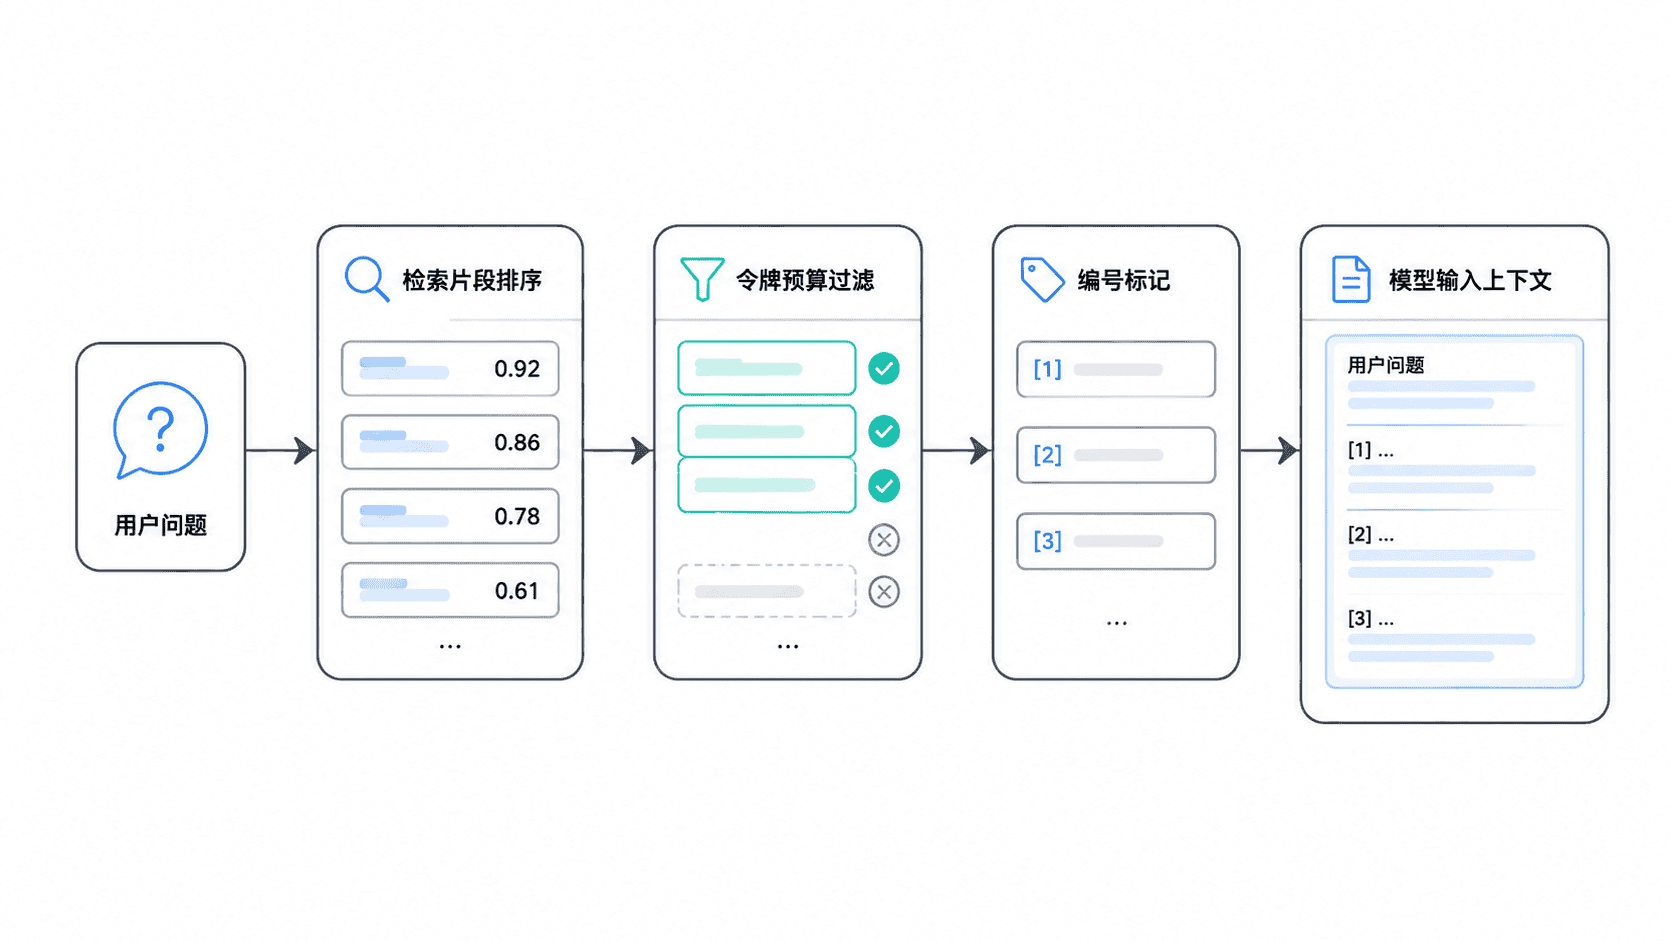
按相关性排列知识片段
组装前需要对候选片段进行排序。排序结果通常来自重排序模型,也可以结合多个因素计算综合分数。例如可以使用以下规则:
- 相关性最高的片段优先进入上下文前部
- 来源可靠的文档获得更高优先级
- 内容重复的片段进行合并或降低权重
根据令牌预算裁剪内容
模型上下文窗口有限,因此需要控制输入长度。系统可以逐个加入片段,直到达到预算限制。下面示例展示一个简单的上下文构建函数。
python
from typing import List

def build_context(chunks: List[str], max_chars: int = 200) -> str:
    """按顺序拼接知识片段,超过预算后停止。"""
    result = []
    used = 0

    for index, chunk in enumerate(chunks, start=1):
        item = f"[{index}] {chunk}"
        if used + len(item) > max_chars:
            break
        result.append(item)
        used += len(item)

    return "\n".join(result)

chunks = [
    "RAG 使用检索结果增强生成能力",
    "上下文需要控制长度避免超过模型限制"
]

print(build_context(chunks))
预期输出
text
[1] RAG 使用检索结果增强生成能力
[2] 上下文需要控制长度避免超过模型限制
稳定的引用编号设计
引用编号可以帮助模型和用户追踪信息来源。编号应该在一次请求生命周期内保持稳定,避免模型生成过程中出现来源错乱。常见格式如下:
text
[1] 来源:RAG设计文档
内容:检索增强生成通过外部知识提升回答质量。

[2] 来源:系统架构说明
内容:上下文组装负责控制输入长度。
这种格式比直接拼接文本更容易让模型区分不同知识来源。
组装策略中的常见问题
如果只按照检索顺序拼接,低质量片段可能覆盖高质量答案。如果只保留最高分片段,又可能丢失补充条件。
实际项目通常采用混合策略:保留少量高相关片段,再加入必要的背景信息,同时记录每个片段的来源和评分。
按自己的节奏,确认真正理解。