
大模型应用开发 / 系统课时
隔离多租户数据
隔离多租户数据
本课解决多租户 RAG 系统中的数据隔离问题,通过比较独立集合、命名空间和租户字段过滤方案,帮助设计既安全又易维护的知识库架构。
学习目标
- 理解多租户数据隔离的主要方案
- 掌握租户字段过滤的实现方式
- 能根据业务规模选择合适隔离策略
多租户隔离的核心问题
多租户系统中,不同客户共享检索基础设施,但不能共享知识内容。RAG 场景不仅需要隔离存储,还需要保证查询、索引、缓存和权限链路都不会发生跨租户访问。
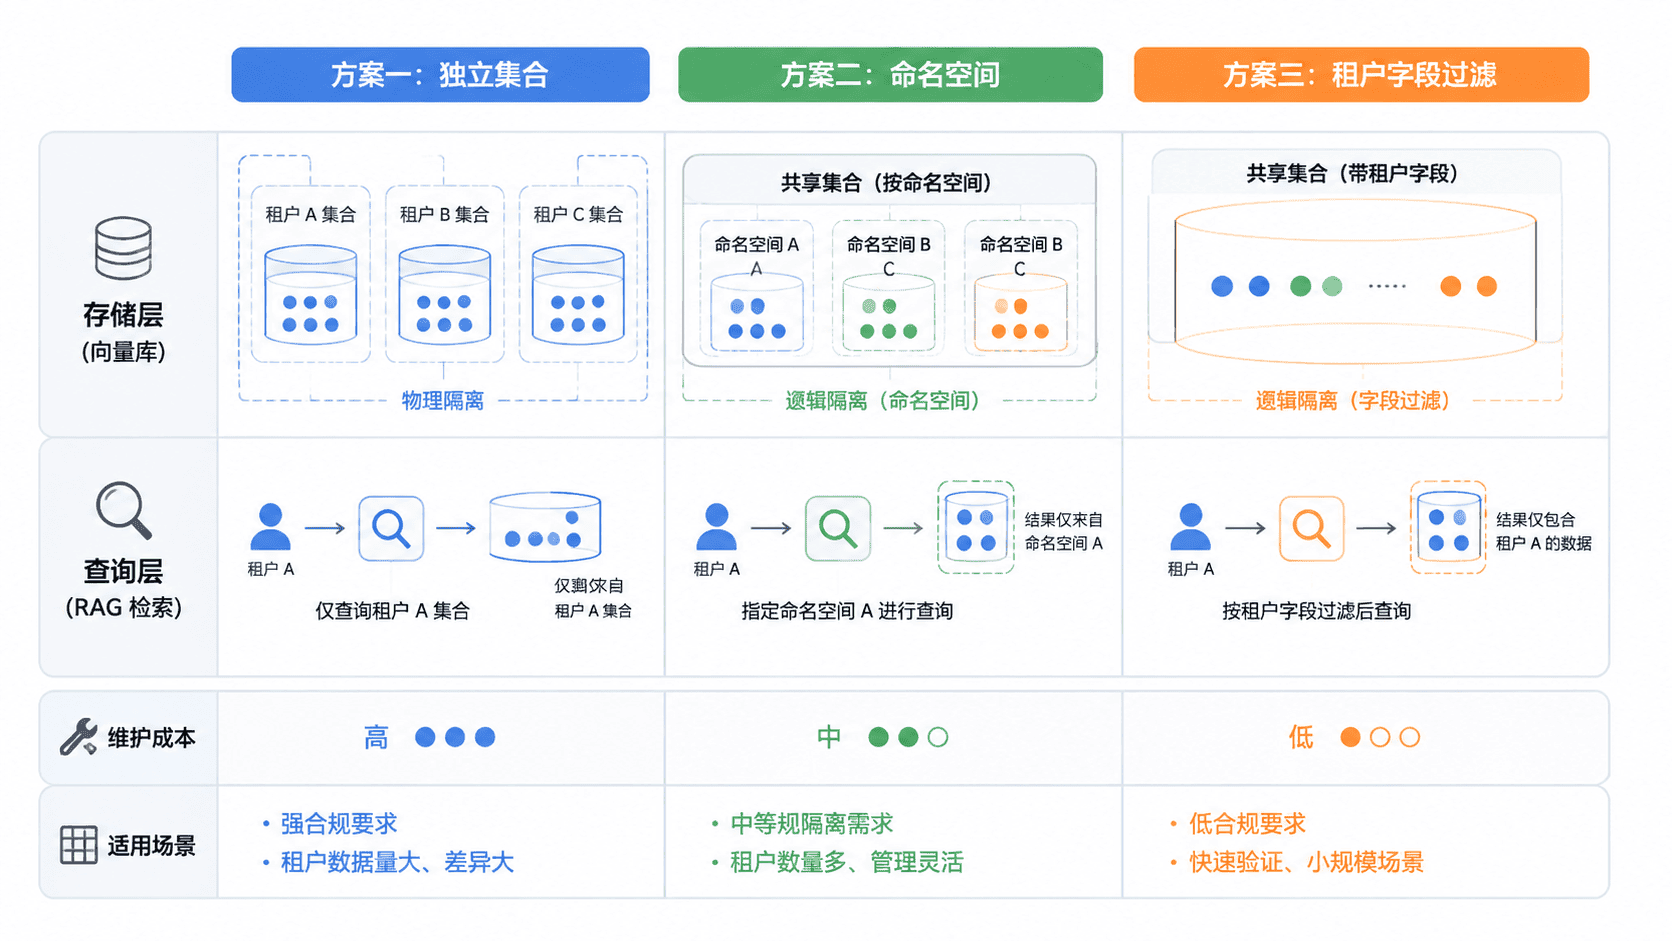
隔离设计通常有三个层级:物理隔离、逻辑隔离和字段级隔离。隔离程度越高,安全性越强,但运维成本也会增加。
独立集合隔离
独立集合方式为每个租户创建独立向量集合。例如租户 A 使用 collection-a,租户 B 使用 collection-b。
这种方式隔离最明显,适合对安全要求高、租户数量有限的系统。
python
collections = {
    "tenant-a": "collection-a",
    "tenant-b": "collection-b"
}

collection = collections["tenant-a"]
print(collection)
预期输出
text
collection-a优点是数据边界清晰,缺点是租户数量增加后,集合管理和索引维护成本会上升。
命名空间隔离
命名空间方式在同一个向量存储中划分逻辑区域。查询时必须指定当前租户对应的 namespace。
这种方案比独立集合更容易管理,适合大量中小租户场景。
python
query = {
    "namespace": "tenant-a",
    "text": "员工报销流程"
}

print(query["namespace"])
预期输出
text
tenant-a实现时需要保证 namespace 来源于服务端身份解析结果,不能由客户端随意修改。
租户字段过滤
字段过滤方式是在每个向量记录中增加 tenantId 字段,查询时携带过滤条件。
json
{
  "text": "报销规则文档",
  "metadata": {
    "tenantId": "tenant-a"
  }
}
预期结果
text
检索系统仅返回 tenantId 等于 tenant-a 的文档片段。这种方案扩展性最好,可以快速增加租户,但必须依赖严格的过滤机制。如果过滤条件失效,会直接造成跨租户泄露。
选择隔离方案
不同规模系统可以采用不同策略:
| 方案 | 隔离强度 | 管理成本 | 适用场景 |
|---|---|---|---|
| 独立集合 | 高 | 高 | 少量高安全租户 |
| 命名空间 | 中高 | 中 | 大量普通租户 |
| 租户字段过滤 | 中 | 低 | 大规模 SaaS 场景 |
实际项目中也可以组合使用,例如大客户独立集合,小客户共享集合并使用租户字段过滤。
按自己的节奏,确认真正理解。