
大模型应用开发 / 系统课时
解析 PDF 文档
解析 PDF 文档
本节解决 RAG 知识库中 PDF 文档难以直接利用的问题,学习如何提取页面文本,识别页眉页脚、分页断句和多栏排版造成的信息错误,最终生成适合检索的文本内容。
学习目标
- 理解 PDF 文本提取的基本机制和限制。
- 掌握页面文本读取与基础清洗方法。
- 能够定位 PDF 解析中的常见质量问题。
PDF 文档解析的特点
PDF 主要描述页面上的文字位置,而不是像 Markdown 一样保存明确的文本结构。因此同一段内容在视觉上连续,在底层数据中可能被拆成多个文本片段。
RAG 系统解析 PDF 时需要先提取文本,再根据页面顺序、坐标信息和规则进行整理,避免生成错误的知识片段。
提取 PDF 页面文本
Python 项目中常使用 PDF 解析库读取页面内容。基础流程是打开文件、遍历页面、提取文本并合并结果。
python
import fitz

def extract_pdf_text(path: str) -> str:
    document = fitz.open(path)
    pages = []
    for page in document:
        # 按页面顺序提取文本,复杂排版需要额外布局分析
        pages.append(page.get_text())
    return "\n".join(pages).strip()

text = extract_pdf_text("<PATH>")
print(text[:120])
预期输出
text
PDF 第一页提取出的文本内容示例...处理页眉页脚与分页问题
企业文档通常会在每页重复显示标题、日期或页码。如果直接进入向量库,这些重复内容会污染检索结果。
清理时可以根据固定模式过滤重复行,例如检测连续多个页面出现的相同文本。同时需要处理分页断开的句子,将跨页内容重新连接。
多栏排版导致的文本错序
论文、报告和产品手册经常使用双栏或多栏布局。简单提取可能按照坐标顺序读取,导致左栏和右栏文字交错。
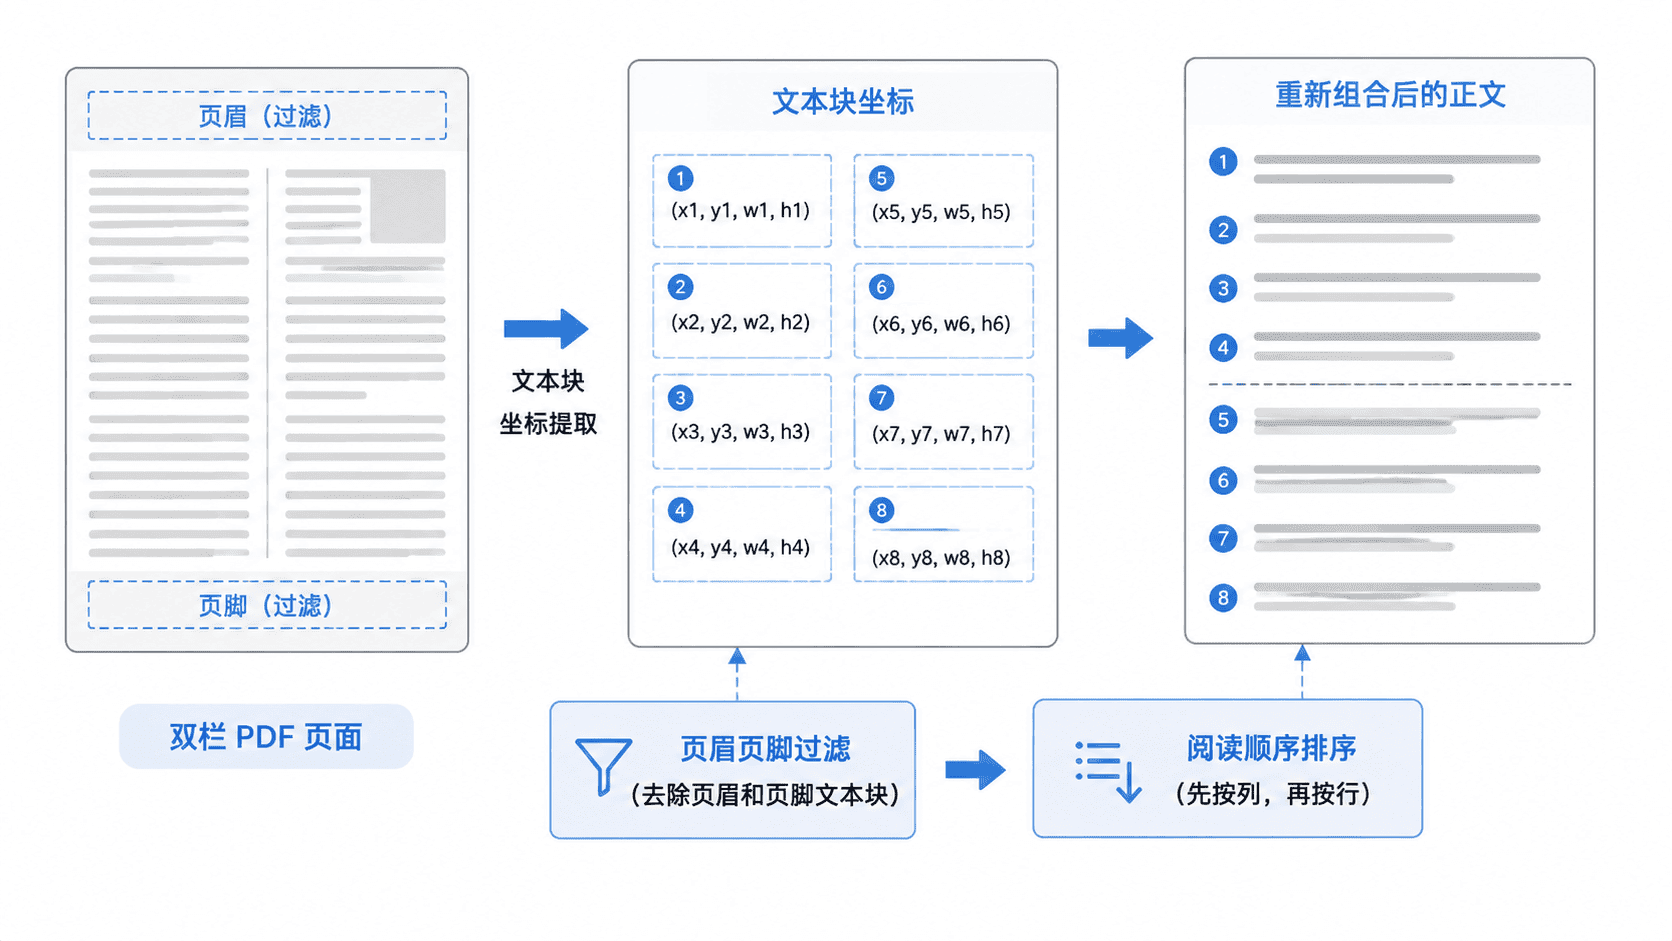
处理此类 PDF 时,应优先使用支持布局分析的解析方式,根据文本块位置重新排序,而不是直接拼接所有字符串。
验证解析质量
PDF 解析完成后,需要通过抽样检查确认文本是否符合预期。重点检查标题是否保留、段落是否连续、表格内容是否错乱以及特殊字符是否异常。
python
from pathlib import Path

text = Path("<PATH>").read_text(encoding="utf-8")
print("length:", len(text))
print("preview:", text[:80])
预期输出
text
length: <ID>
preview: 解析后的文本预览内容
实际项目中还应结合人工抽查和检索测试验证解析效果,因为文本完整不代表语义结构一定正确。
按自己的节奏,确认真正理解。