
大模型应用开发 / 系统课时
整合在线问答链路
整合在线问答链路
本课把查询改写、混合检索、结果重排、上下文组装、回答生成和引用追踪组合成一条完整在线问答链路。完成后,你将能明确每个阶段的输入输出,并实现一个可运行的最小版本,让最终答案不仅来自检索证据,还能追踪到具体来源片段。
学习目标
- 理清在线 RAG 从用户问题到最终回答的处理顺序
- 组合关键词与向量结果,并在生成前完成重排和上下文裁剪
- 让回答携带可追踪的引用标识,便于核验来源
一次请求经过哪些阶段
在线问答链路的核心原则是“先确定证据,再生成答案”。用户问题可以先经过查询改写,提高检索命中率;随后由关键词检索与向量检索分别召回候选结果,再合并、去重、重排,最后才把有限数量的高质量片段交给生成模型。
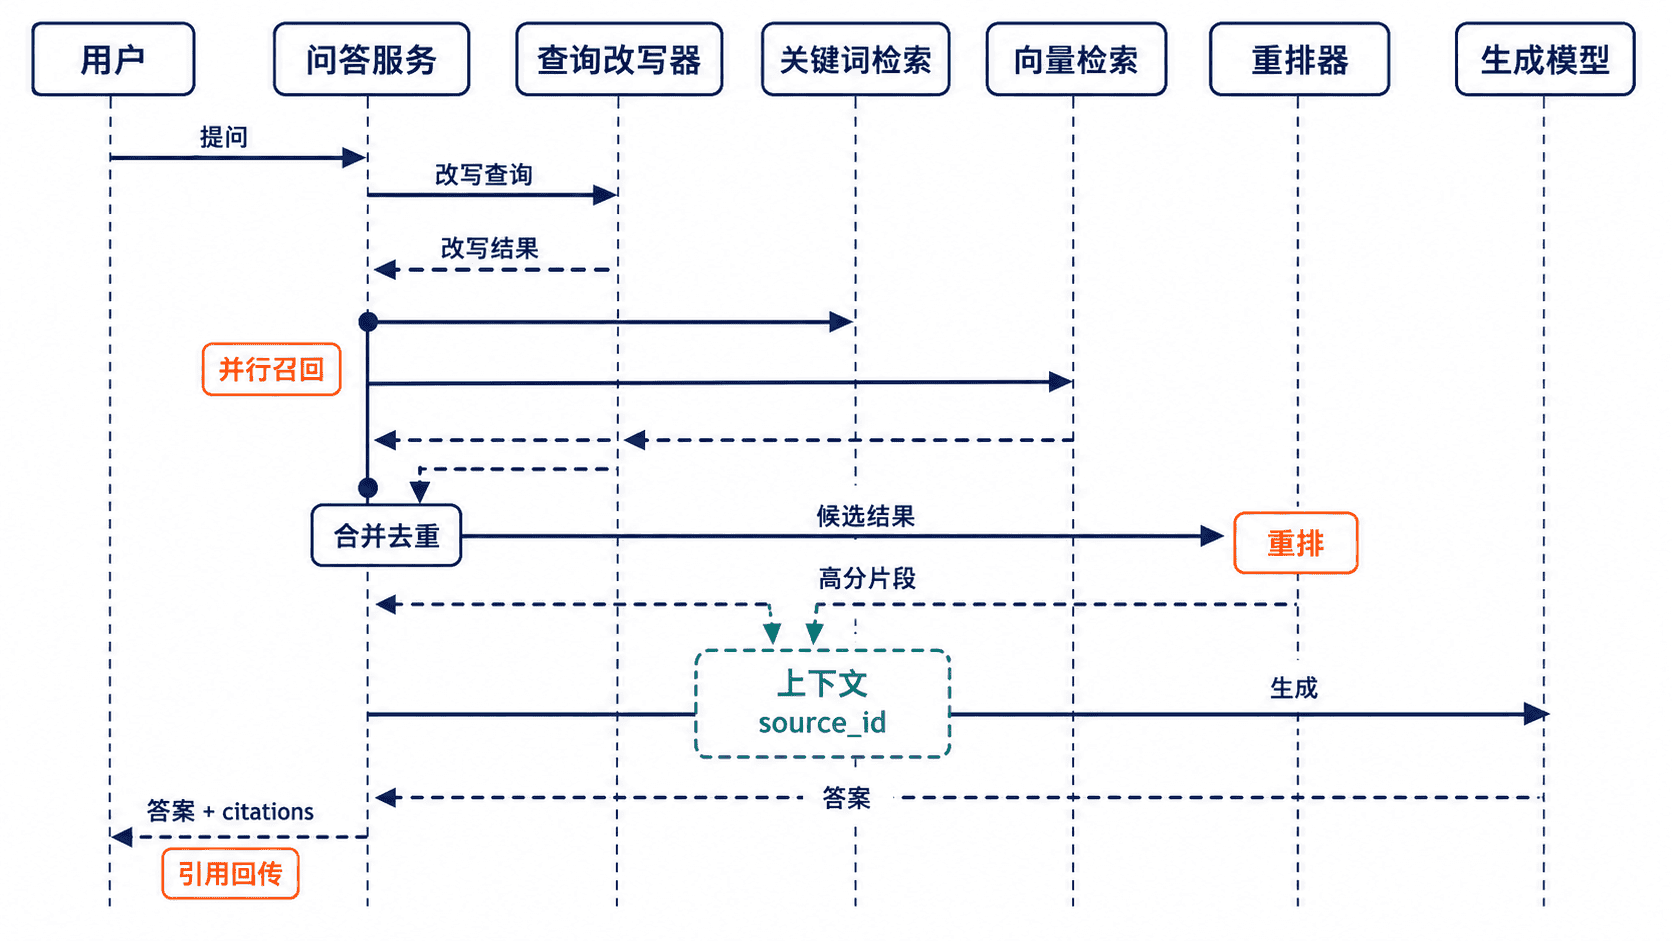
这条链路不能只关注最终答案是否“像是正确的”。还应保存改写后的查询、各检索器返回的候选、重排分数、最终上下文片段和生成结果。这样出现错误时,才能判断问题究竟来自召回不足、排序错误、上下文污染还是模型生成偏离证据。
实现一个可运行的最小链路
下面使用内存文档模拟混合检索。关键词召回按照词项重合计分,向量召回用字符集合相似度近似,再通过融合分数重排。示例不依赖第三方服务,因此可以直接运行并观察最终引用;生产环境可逐步替换各阶段实现,而保持链路接口不变。
from __future__ import annotations

from dataclasses import dataclass

@dataclass
class Document:
    source_id: str
    text: str

DOCS = [
    Document("doc-1", "RAG 的索引阶段负责切分文档并生成向量。"),
    Document("doc-2", "混合检索可以组合关键词检索和向量检索的候选结果。"),
    Document("doc-3", "重排模型用于把更相关的候选片段移动到前面。"),
]

def rewrite_query(question: str) -> str:
    # 最小示例只清理问句;真实系统可调用模型补全检索意图。
    return question.replace("?", "").strip()

def keyword_score(query: str, text: str) -> float:
    terms = [term for term in ["混合检索", "关键词", "向量", "重排"] if term in query]
    return float(sum(term in text for term in terms))

def semantic_score(query: str, text: str) -> float:
    q, t = set(query), set(text)
    return len(q & t) / max(len(q | t), 1)

def retrieve(query: str) -> list[tuple[Document, float]]:
    candidates = []
    for doc in DOCS:
        # 两路信号归一到同一个融合分数后再统一排序。
        score = keyword_score(query, doc.text) + semantic_score(query, doc.text)
        candidates.append((doc, score))
    return sorted(candidates, key=lambda item: item[1], reverse=True)

def build_context(results: list[tuple[Document, float]], top_k: int = 2) -> str:
    return "\n".join(f"[{doc.source_id}] {doc.text}" for doc, _ in results[:top_k])

def generate_answer(context: str) -> tuple[str, list[str]]:
    citations = [line.split("]", 1)[0][1:] for line in context.splitlines()]
    answer = "混合检索先汇总关键词与向量召回结果,再通过排序选择更相关的证据片段。"
    return answer, citations

def main() -> None:
    question = "混合检索和重排是怎么配合的?"
    query = rewrite_query(question)
    results = retrieve(query)
    context = build_context(results)
    answer, citations = generate_answer(context)
    print(f"query={query}")
    print(f"top_source={results[0][0].source_id}")
    print(f"answer={answer}")
    print(f"citations={','.join(citations)}")

if __name__ == "__main__":
    main()
预期输出
query=混合检索和重排是怎么配合的
 top_source=doc-2
answer=混合检索先汇总关键词与向量召回结果,再通过排序选择更相关的证据片段。
citations=doc-2,doc-3
实际生产系统中的检索分数和生成文字会随模型、索引及数据变化,因此不要依赖固定自然语言输出;应重点验证候选来源、引用 ID 和阶段执行顺序是否符合预期。
上下文组装不是简单拼接
重排后的片段仍不能无限加入提示词。上下文组装器应在模型上下文预算内选择片段,并保留 source_id、标题或文档路径等引用信息。重复片段要去重,明显冲突或低分片段应剔除,单个超长片段则需要裁剪,否则真正关键证据可能被挤出窗口。
推荐将证据组织成带明确边界的块,例如 [doc-2] 内容...。生成提示词要求模型只基于这些证据回答,并在无法支持结论时明确说明证据不足。相比生成后再猜测答案来自哪个文档,这种“生成前绑定来源”的方法更容易保证引用可追踪。
为链路设置失败边界
查询改写不是越复杂越好。若改写结果偏离原问题,应保留原始问题参与检索,或者在改写置信度不足时直接跳过。混合召回也需要分别记录两路候选,防止融合后无法发现某一路检索器已经失效。
当没有足够高质量证据时,链路应停止正常回答,而不是让模型凭内部知识补全。可以根据重排最高分、有效片段数量以及引用完整性设置拒答条件。这样会降低表面的回答率,却能显著减少“检索不到仍强行作答”的生产风险。
验收在线问答链路
验收时不要只看最终文本。至少记录 request_id、原始查询、改写查询、候选文档 ID、重排结果、最终上下文和引用列表。出现错误答案后,可以沿这条记录逐层回放,快速确定是哪一个阶段首先偏离预期。
还应构造三类测试:能被知识库直接回答的问题应返回正确证据;无相关资料的问题应拒答或说明资料不足;存在多个相近文档的问题应让重排结果稳定地把最相关片段放在前面。只有这三类都可验证,在线链路才算真正闭环。