
大模型应用开发 / 系统课时
加入关键词检索
加入关键词检索
本课解决向量检索难以精确命中产品型号、错误码、缩写等固定文本的问题,通过引入关键词检索链路,让知识库同时具备语义理解和精确匹配能力。
学习目标
- 理解关键词检索适合解决的问题类型
- 使用倒排索引实现基础关键词召回
- 掌握关键词检索结果的验证方法
为什么需要关键词检索
向量检索擅长理解语义相近内容,但对完全匹配的字符串并不总是稳定。例如产品型号 AX-200、错误码 E1007 或接口名称 getUserById 等内容,字符差异会直接影响匹配效果。
关键词检索通过分析文本中的词项建立倒排索引。当用户查询包含明确关键词时,系统可以快速定位包含这些词的文档片段,提高精确召回能力。
关键词检索的工作机制
关键词检索通常包含分词、建立索引和查询匹配三个步骤。文档进入知识库时,会被拆分成词项,并记录词项出现的位置。查询时,根据关键词查找对应文档集合。
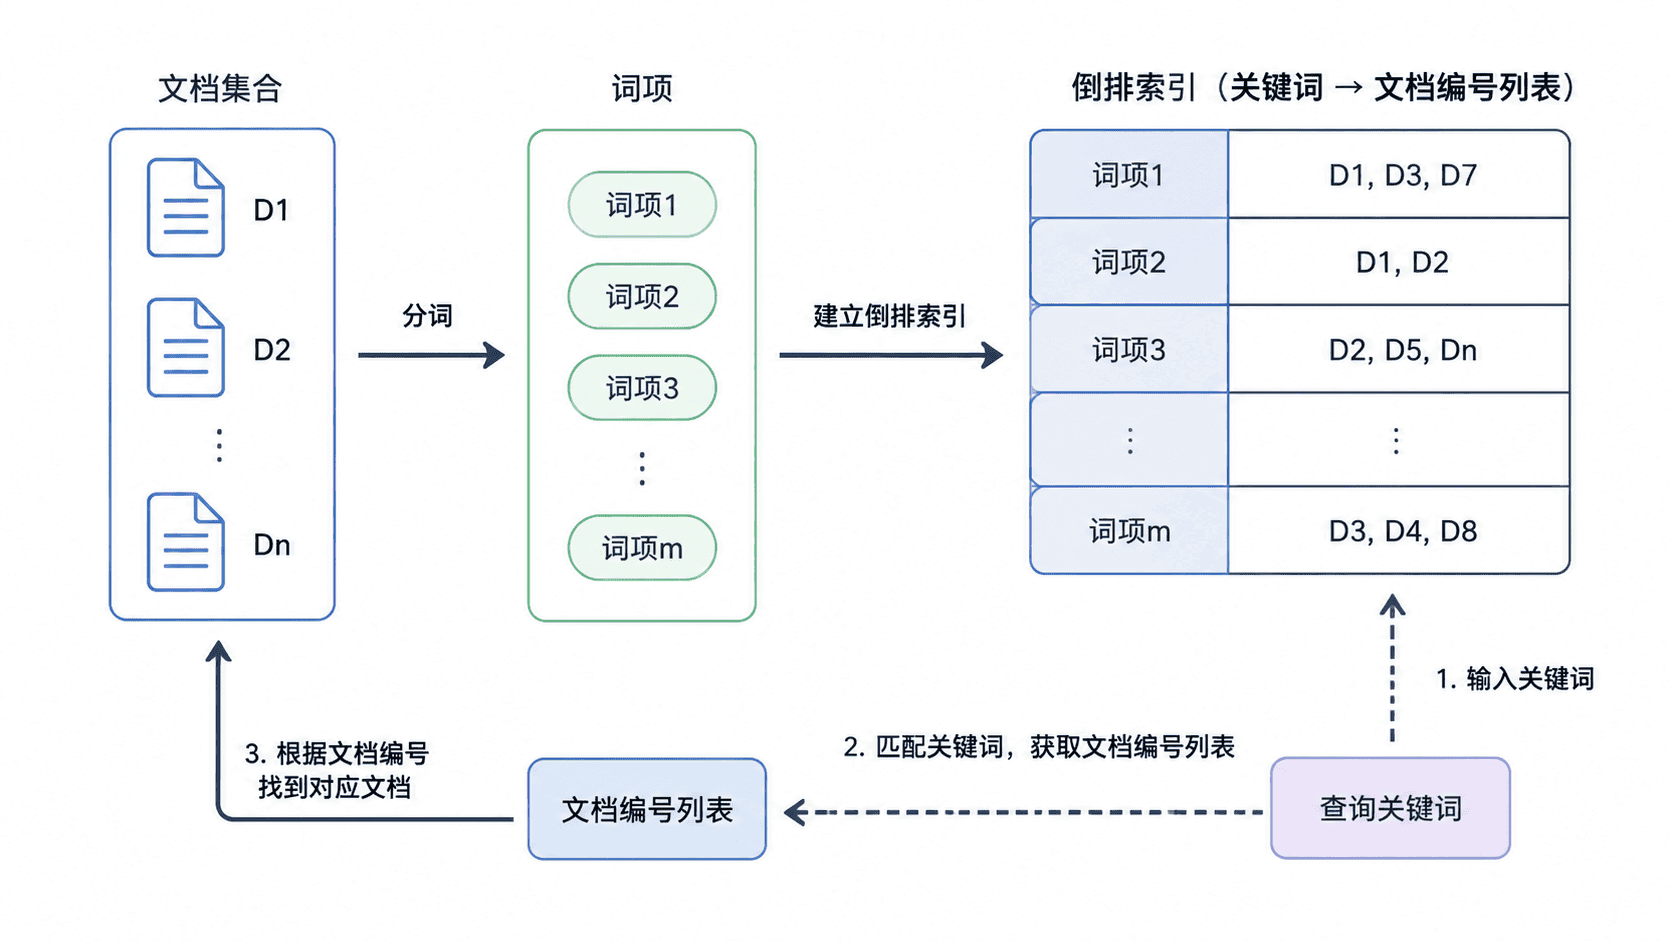
一个简单的关键词检索流程可以使用现有搜索库完成,也可以理解其核心数据结构。下面示例展示使用 Python 构建简单倒排索引。
python
documents = {
    1: 'AX-200 网络设备配置手册',
    2: 'E1007 登录失败处理说明',
    3: '用户接口调用指南'
}

# 建立关键词到文档编号的映射
index = {}
for doc_id, text in documents.items():
    for word in text.split():
        index.setdefault(word, []).append(doc_id)

query = 'E1007'
result = index.get(query, [])
print(result)
预期输出
text
[2]在 RAG 链路中的接入方式
关键词检索通常位于召回阶段,与向量检索并列运行。用户输入问题后,系统分别执行关键词查询和向量查询,再将两类结果交给后续排序模块处理。
适合优先使用关键词检索的场景包括:产品编号查询、日志错误码搜索、API 名称查找、配置项定位以及法律条款编号检索。
常见问题与优化方向
关键词检索依赖词项质量,简单按空格切分无法处理中文、复合词和同义表达。生产环境通常需要结合专业分词器、停用词过滤、词权重调整等能力。
如果关键词召回过多,可以提高匹配条件或限制返回数量;如果召回过少,需要检查分词规则、同义词表和文档清洗流程。
按自己的节奏,确认真正理解。