
大模型应用开发 / 系统课时
管理会话与消息
管理会话与消息
本课介绍知识库问答系统中的会话管理设计,解决用户问题、模型回答、引用来源和请求状态如何持久保存的问题。完成后可以建立可追踪、可恢复的多轮问答数据模型。
学习目标
- 理解会话与消息在 RAG 应用中的职责划分
- 设计支持引用和状态管理的数据结构
- 实现基础会话消息保存接口
设计会话与消息模型
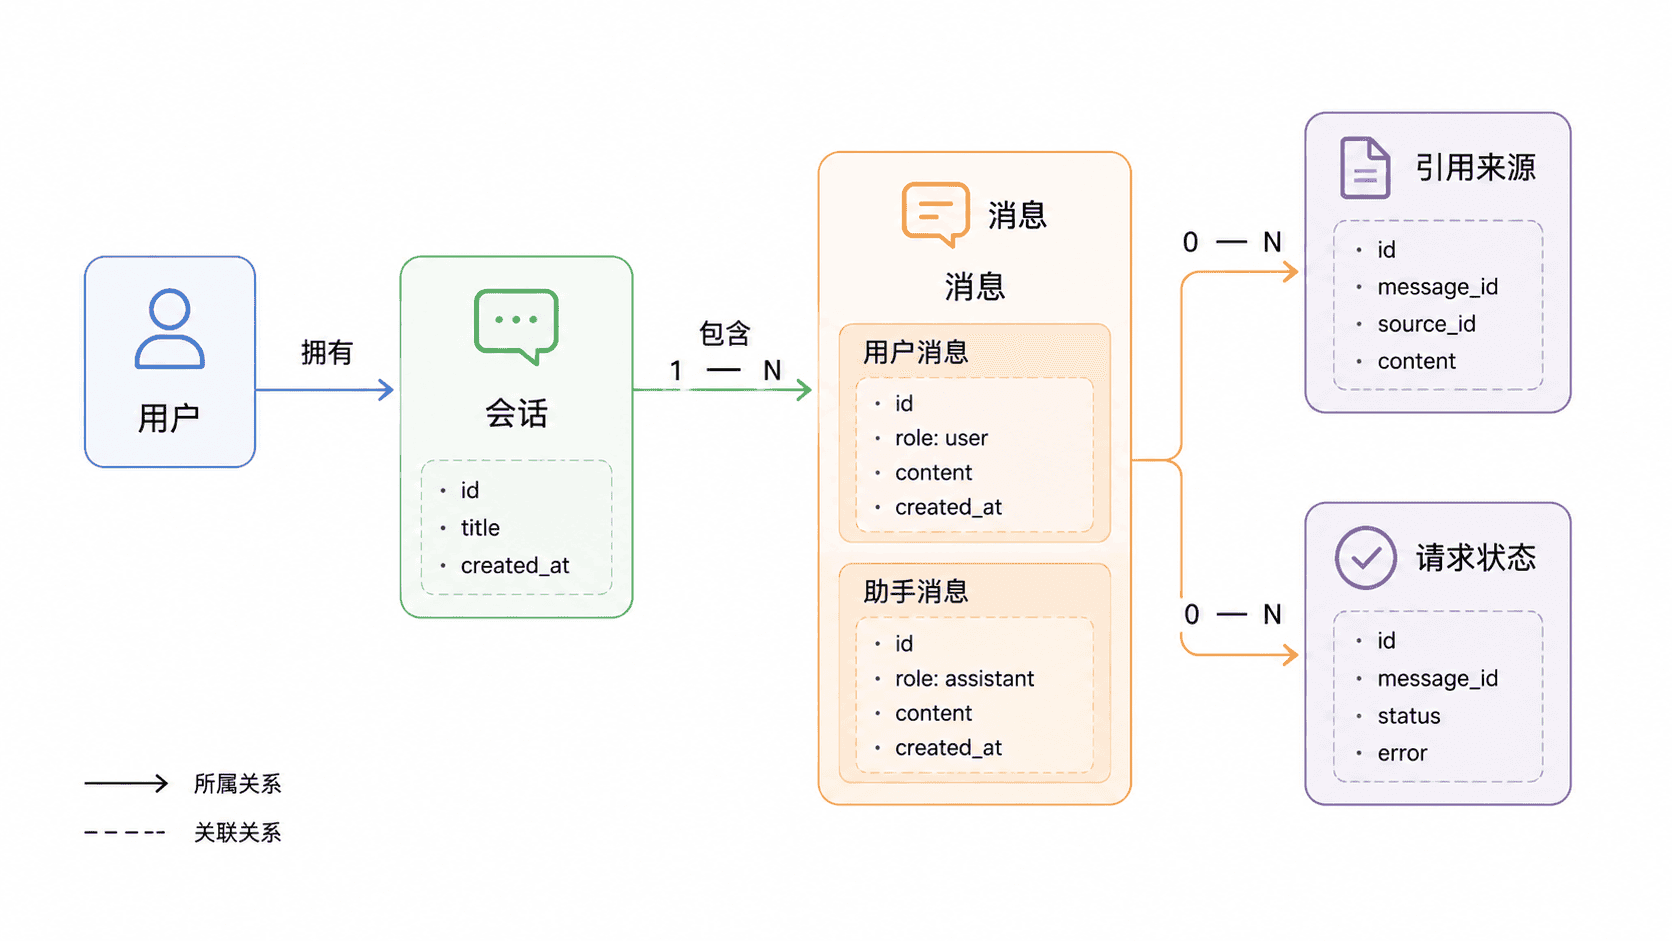
RAG 应用通常需要同时保存一次完整问答过程中的多个对象:用户输入、检索结果、模型生成内容以及引用信息。会话用于组织上下文,消息用于记录具体交互事件。
一个常见设计是会话表保存用户和对话整体信息,消息表保存每轮输入输出。消息中保留角色字段,可以区分 user、assistant 和 system 等不同来源。
定义消息存储结构
消息记录需要满足查询历史、恢复上下文和分析效果三个目标。下面给出一个简化的数据模型示例。
sql
CREATE TABLE conversations (
  id BIGINT PRIMARY KEY,
  user_id VARCHAR(64) NOT NULL,
  title VARCHAR(255),
  status VARCHAR(32) NOT NULL
);

CREATE TABLE messages (
  id BIGINT PRIMARY KEY,
  conversation_id BIGINT NOT NULL,
  role VARCHAR(16) NOT NULL,
  content TEXT NOT NULL,
  citations JSON,
  request_status VARCHAR(32)
);
预期结果
text
创建 conversations 和 messages 两张表。
messages 可以关联会话,并保存角色、内容、引用和请求状态。
保存一次问答流程
保存消息时建议采用先写用户消息,再更新助手消息的方式。模型生成过程中可以将助手消息状态设置为 processing,完成后更新为 completed,失败时记录 failed。
python
from dataclasses import dataclass

@dataclass
class Message:
    role: str
    content: str
    status: str = "completed"

messages = [
    Message("user", "如何配置知识库检索"),
    Message("assistant", "可以通过向量检索和生成模型组合实现")
]

for message in messages:
    print(message.role, message.status)
预期输出
text
user completed
assistant completed
处理上下文与引用边界
多轮问答不能无限携带历史消息,否则会增加模型输入成本。实际系统通常根据时间、消息数量或 token 数量裁剪历史,同时保留关键摘要。
引用来源应单独保存,而不是只拼接到答案文本中。这样前端可以展示来源,后台也能分析哪些文档被频繁使用。
按自己的节奏,确认真正理解。